L04b-4 过拟合与正则化:训练集上满分,为什么反而是坏信号
用三联图分清欠拟合、刚好和过拟合,再从零讲 L1/L2 正则化,用三点例子逐帧看 λ 怎样把碗底往 0 拉。
一句话版
训练集上误差压到零不一定是好事,模型可能只是把训练数据背了下来。正则化的做法是保留全部特征,在代价函数里给「参数太大」记一笔罚分,让曲线别为了迎合个别点扭成麻花。
读之前最好先懂代价函数 J 和梯度下降,见 L04b-1 和 L04b-2。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| underfitting | 欠拟合 | 模型太简单,连训练数据的弯曲都跟不上 |
| overfitting | 过拟合 | 模型太复杂,训练集上近乎满分,换新数据就失灵 |
| bias / variance | 偏差 / 方差 | 欠拟合叫 high bias,过拟合叫 high variance |
| generalize | 泛化 | 对没见过的新样本也预测得准 |
| regularization | 正则化 | 在 J 里加一项惩罚,让参数不敢太大 |
| λ | 读「拉姆达」,正则化系数 | 惩罚的力度,由人设定,属于超参数 |
| Lasso / Ridge | L1 / L2 正则化的别名 | 一个罚绝对值,一个罚平方 |
一个类比:给一个人量身做衣服
裁缝做衣服有两种失败。一种是只做均码,布料是直筒,谁穿都松松垮垮。这是欠拟合:模型太简单,连最明显的形状都没抓住。
另一种是量得太细。客人那天左肩微微耸起、口袋里揣着手机,裁缝把这些全量进去。客人换个姿势、掏出手机,衣服立刻别扭。这是过拟合:模型把训练数据里的偶然细节也当成了规律。
正则化相当于给裁缝立一条规矩:每一处改动都要计成本,改得越多越要有理由。偶然的小起伏不值得专门改一刀,真正的身形轮廓才值得。λ 就是这条规矩有多严。太宽松,裁缝照样把手机量进去;太严,裁缝干脆不改,又回到均码。
类比在哪里失效:
- 衣服做好能当场试穿。模型过拟合在训练集上看不出来,必须拿没见过的新样本去测才会暴露。
- 裁缝可以只对某几处严格。L2 正则化的 λ 是一个数,对 θ₁ 到 θₙ 所有参数一视同仁,只有截距 θ₀ 例外。
从零讲起
1. 欠拟合与过拟合
它解决什么问题
前三页一直在把 J 往下压。可模型能选得简单,也能选得复杂:直线、二次曲线、四次曲线。越复杂,训练集上的 J 越低。这一节回答:复杂度怎么选才对,J 低到什么程度反而是坏事。
直觉
模型太简单,连训练数据都贴不上,训练误差和新数据误差都大,这是欠拟合。
模型太复杂,参数个数和数据点一样多甚至更多,它能精确穿过每一个点,训练误差接近 0。可点与点之间它扭来扭去,新数据一来就错得离谱,这是过拟合。
两者之间有一个刚好的复杂度,既抓住了整体趋势,又不迁就个别点。
一步一步看
目标:用一次、二次、四次三个模型拟合同一组五个房价点,看模型太简单和太复杂时各错在哪。
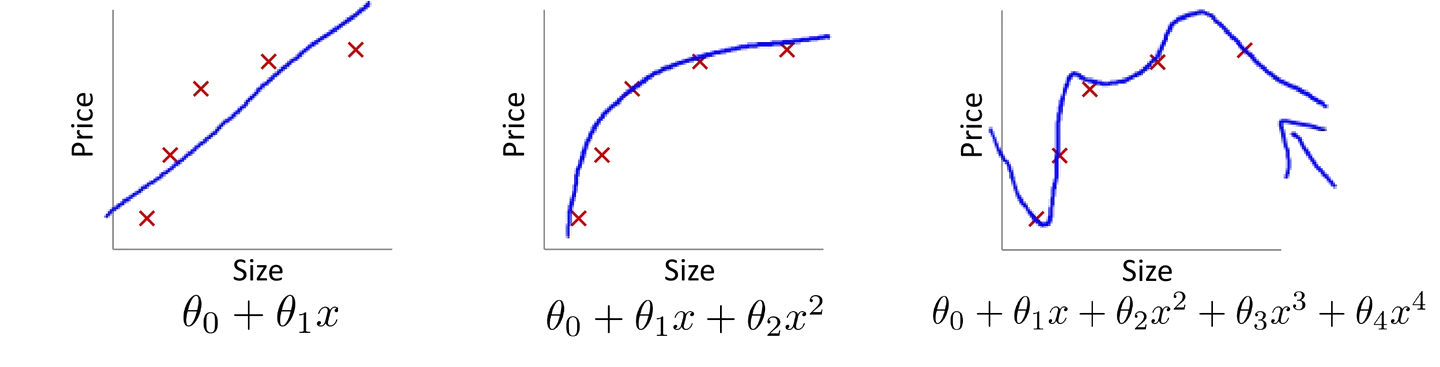
同一组五个房价点,换三个模型:
-
一次式 θ₀ + θ₁x:一条直线,点在线两侧偏得明显,跟不上数据的弯曲。欠拟合,high bias。
-
二次式 θ₀ + θ₁x + θ₂x²:平滑曲线,贴近各点又不扭。刚好。
-
四次式 θ₀ + θ₁x + θ₂x² + θ₃x³ + θ₄x⁴:五个参数配五个点,曲线精确穿过每一个。过拟合,high variance。
-
换成分类问题也一样:直线边界两侧都有分错的点,平滑曲线大致分开两类,绕着每个点转圈的边界就是过拟合。
怎么判断
拿一个模型,看两样东西:训练集上的误差,新样本上的误差。
训练误差大,就是欠拟合,模型太简单。训练误差很小、新样本误差很大,就是过拟合,模型太复杂。两者都小,才是刚好。光看训练集只能发现欠拟合,发现不了过拟合。
常见误解
把「训练集上误差为零」当成好消息
它恰恰是过拟合的信号。五个点配一条四次曲线,有五个参数可调,总能精确穿过每个点。这只说明模型够灵活,不说明它学到了房价的规律。
把 bias 和 variance 对应反了
欠拟合是 high bias:模型有偏见,硬要用直线去套弯的数据。过拟合是 high variance:模型对训练数据太敏感,换一批数据形状就大变。
试一下
一个模型训练误差 0.01,新数据误差 5;另一个训练误差 3,新数据误差 3.2。各是什么状态?
第一个训练误差极小、新数据误差大很多,是过拟合。第二个两个误差都大且接近,是欠拟合。
2. 处理过拟合的两条路
它解决什么问题
发现过拟合之后怎么办。课件给了两条路,分别适合不同情况。
直觉
过拟合是因为模型太灵活。一条路是直接拿掉一些灵活度:删掉一部分特征。另一条路是特征全留,但给每个参数套上缰绳,不让它们变得太大。
一步一步看
目标:拿四次多项式分别走减特征和正则化两条路,看两种做法怎样都让曲线退回接近二次的形状。
拿四次多项式 θ₀ + θ₁x + θ₂x² + θ₃x³ + θ₄x⁴ 来看。
-
第一条路,减特征:直接删掉 x³ 和 x⁴,模型回到二次式。可以手动挑,也可以用模型选择算法挑。
-
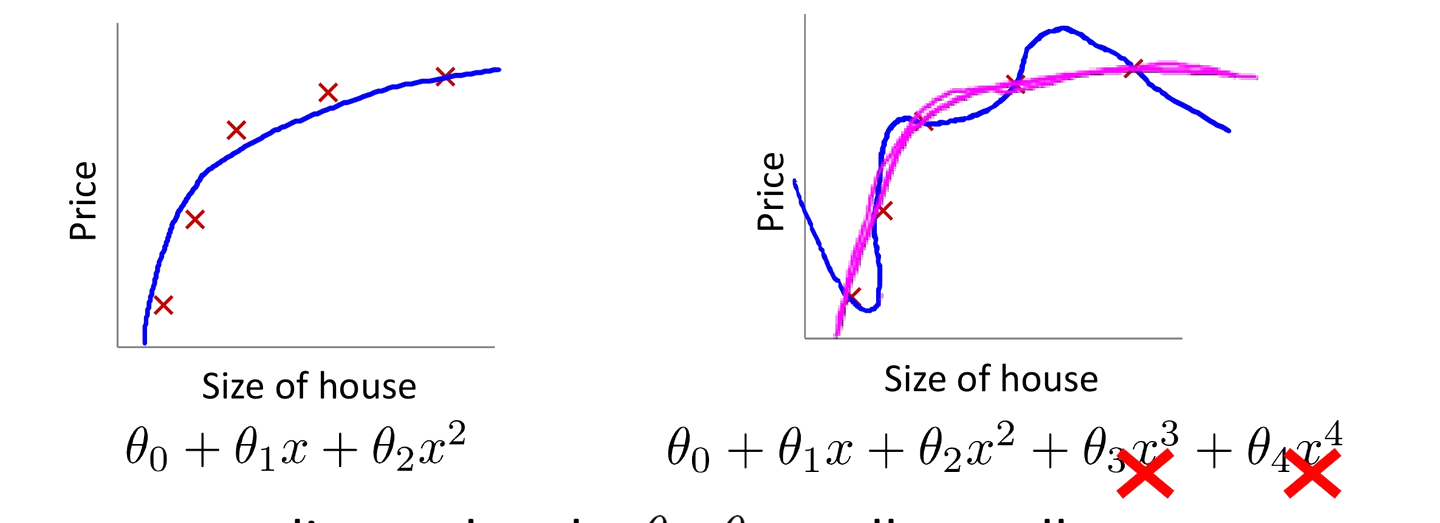
第二条路,正则化:x³、x⁴ 都保留,但让 θ₃、θ₄ 变得非常小。
-
θ₃、θ₄ 接近 0 时,x³、x⁴ 两项几乎不起作用,曲线同样退化成接近二次的形状。
-
两条路对比:
减特征 正则化 特征 删掉一部分 全部保留 参数 被删的直接没了 都在,只是被压小 适合 知道哪些特征没用 特征很多,每个都有一点用 风险 删错了就丢了信息 要多选一个 λ -
现实里一套房子可能有 100 个特征,很难知道该删哪个,所以正则化更常用。
怎么判断
问一句:我知不知道哪几个特征是多余的?
知道,就删掉它们。不知道,或者每个特征都对预测有一点贡献、舍不得删,就用正则化,把全部参数一起压小。
常见误解
以为正则化要先知道该压哪几个参数
压 θ₃、θ₄ 只是直觉演示。现实里特征上百个,根本不知道哪个是罪魁,所以正则化把 θ₁ 到 θₙ 全部一起压。参数整体越小,假设越简单,越不容易过拟合。
试一下
你有 100 个特征,每个和房价都有一点关系,但模型过拟合了。选哪条路?
选正则化。每个特征都有用,删哪个都会丢信息;正则化保留全部特征,只把参数压小。
3. L1 和 L2 正则化
它解决什么问题
上一节说要让参数变小,可梯度下降只会让 J 变小。办法是把「参数大小」也算进 J 里,参数越大 J 越大,梯度下降为了降 J 就会自动把参数往小处推。
从哪来(补充)
L2 正则化又叫 Ridge 回归,由 Hoerl 和 Kennard 在 1970 年的两篇论文里首次提出。L1 正则化又叫 Lasso,全称 least absolute shrinkage and selection operator。它在 1986 年的地球物理文献里已经出现过,Tibshirani 在 1996 年独立重新发现并推广,Lasso 这个名字也是他起的。
出处:Wikipedia: Ridge regression、Wikipedia: Lasso (statistics)
直觉
原来的 J 只有一项:拟合误差。现在再加一项:参数有多大。两项加起来,梯度下降要在「贴数据」和「参数别太大」之间找平衡。
L2 罚参数的平方,大参数被罚得特别重;L1 罚参数的绝对值,所有参数按同样的比例罚。λ 决定第二项占多少份量。
一步一步看
目标:在原来的 J 里加上参数平方的惩罚项,再把平方换成绝对值,看 L2 和 L1 各怎样罚参数。
-
写出原来的 J:(1/2m) Σ (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²。
-
在方括号里加一项 λ Σ θⱼ²,求和从 j = 1 到 n,θ₀ 不在里面。
-
整体仍然乘 1/2m,惩罚项也在括号里,同样被除。
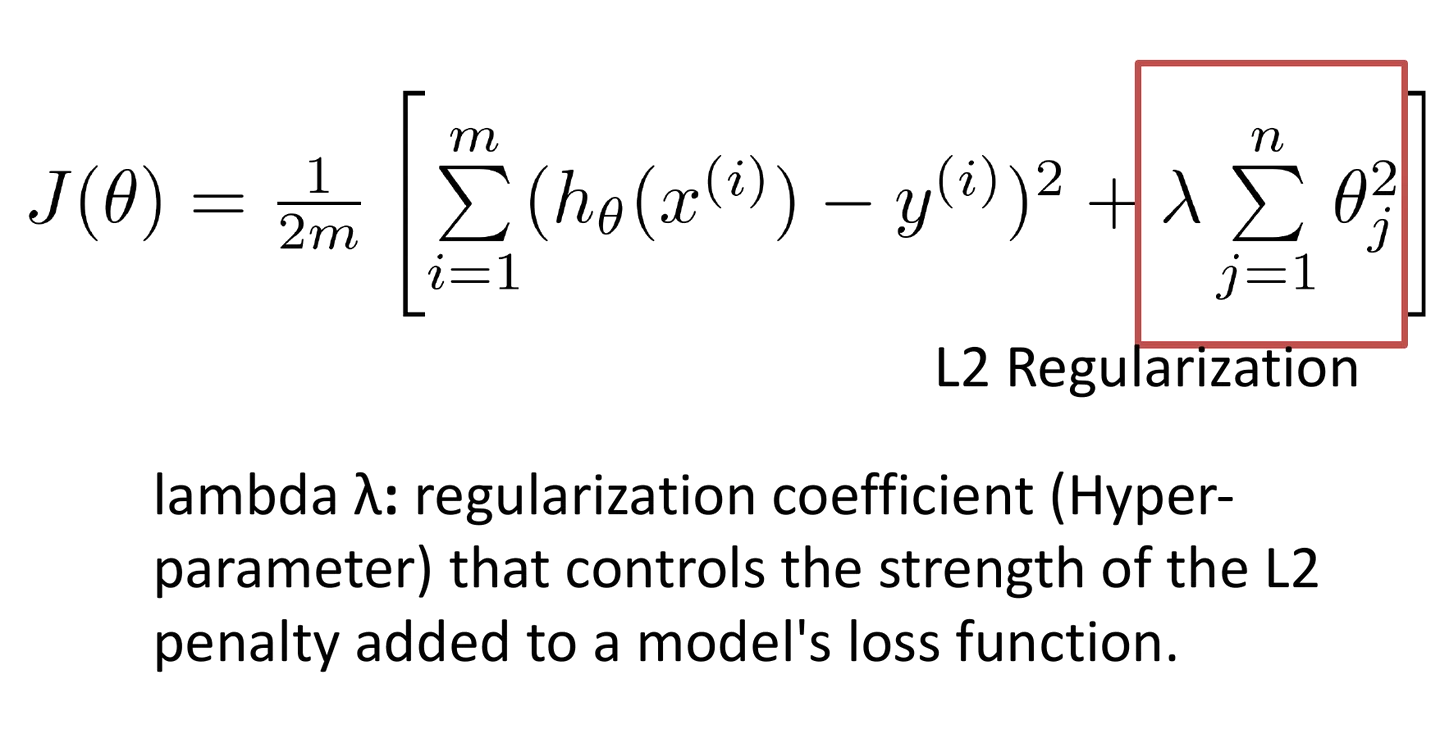
图片来源:COMP5511 Lecture 4 Machine Learning Part I-2, p.35 -
把平方换成绝对值 |θⱼ|,就是 L1。
-
两种惩罚对比:
L1(Lasso) L2(Ridge) 惩罚项 λ Σ |θⱼ| λ Σ θⱼ² 从哪个 j 开始 1 1 对大参数 按比例罚 罚得更重
怎么算
J(θ) = (1/2m) [ Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)² + λ Σ_{j=1}^{n} θⱼ² ]
意思是:方括号里前一半是老的平方误差,后一半是参数的平方和乘 λ。截距 θ₀ 只是把线整体上下移,和曲线扭不扭无关,所以不罚。λ 和学习率 α 一样是超参数,由人设定,不靠梯度下降学出来。
常见误解
把惩罚项写成从 j = 0 开始
课件明确是 j = 1 到 n。θ₀ 不参与「复杂度」,罚它没有意义。
把惩罚项写在方括号外面
课件里惩罚项在方括号内,和平方误差一起被 1/2m 除。写到外面,λ 的含义就变了。
试一下
参数是 θ₀ = 5、θ₁ = 2、θ₂ = −1,λ = 1。L2 和 L1 的惩罚项各是多少?
θ₀ 不罚。L2:1 × (4 + 1) = 5。L1:1 × (2 + 1) = 3。
4. λ 这个旋钮
它解决什么问题
加了惩罚以后,碗底的位置会变。λ 定多大,决定碗底被拉到哪里。这一节用三点例子算出来,看 λ 怎样一步步把最优参数往 0 拉。
直觉
λ = 0,惩罚项消失,回到原来的碗,模型想怎么贴就怎么贴。λ 越大,参数大一点就被罚得越狠,碗底越往 0 靠。
λ 大到极端,所有参数几乎都被压成 0,模型只剩一条水平线,又回到欠拟合。所以 λ 是在过拟合和欠拟合之间滑动的旋钮。
一步一步看
目标:在三点例子上把 λ 从 0 调到 1 再到 14,看最优 θ₁ 怎样被一步步拉向 0,拟合误差怎样变大。
三个点 (1,1)、(2,2)、(3,3),θ₀ 固定为 0,加 L2 惩罚:J(θ₁) = (1/6)[14(θ₁ − 1)² + λθ₁²]。
-
λ = 0:就是原来的碗,最低点在 θ₁ = 1,J = 0。
-
λ = 1:求导令零,28(θ₁ − 1) + 2θ₁ = 0,得 θ₁ = 28/30 ≈ 0.933。碗底往左挪了一点。此时 J 约 0.156,其中平方误差部分只有约 0.01。
-
λ = 14:θ₁ = 14/28 = 0.5。碗底被拉到一半,J 升到约 1.17,平方误差部分约 0.58。
-
三个 λ 整理成表:
λ 最优 θ₁ 平方误差部分 加上惩罚后的 J 0 1 0 0 1 0.933 0.01 0.156 14 0.5 0.58 1.17 -
λ 越大,最优 θ₁ 越小,平方误差部分越大:模型为了参数小,主动放弃了一部分拟合精度。
怎么算
对 J(θ₁) = (1/6)[14(θ₁ − 1)² + λθ₁²] 求导令零:28(θ₁ − 1) + 2λθ₁ = 0,解得 θ₁ = 14/(14 + λ)。
意思是:分母里多出来的 λ 把最优解往 0 压。λ = 0 时就是原来的 1;λ 越大,分母越大,θ₁ 越小;λ 趋于无穷,θ₁ 趋于 0,直线被压成水平线。
常见误解
以为加了正则化,训练集上的误差应该更小
正好反过来。正则化让模型主动放弃一部分训练集上的精度,换来参数更小、曲线更平滑,目的是让新数据上的误差变小。
以为 λ 有一个通用的最佳值
课件演示里 λ = 0.0001 效果最好,那只对那组演示数据成立。换问题最佳 λ 完全不同,要用验证集去选。
试一下
λ = 2 时,三点例子的最优 θ₁ 是多少?
14/(14 + 2) = 14/16 = 0.875,比 λ = 1 时的 0.933 又往 0 靠了一点。
把它们串起来
前三页的结论是:梯度下降一定能走到碗底。这一页追问一句:碗底就一定好吗?
不一定。模型太复杂时,碗底对应的是一条穿过每个训练点的扭曲曲线,训练误差接近 0,新数据一来就错,这是过拟合,high variance。反过来,模型太简单是欠拟合,high bias。回归和分类都适用,分类里看决策边界扭不扭。
修过拟合有两条路:减特征,或者正则化。正则化在 J 的方括号里加 λ Σ θⱼ²,把碗底往 0 拉。参数小了,高次项几乎不起作用,曲线自然变平滑。
λ 是一个旋钮:0 是过拟合那一端,太大是欠拟合那一端,中间某处泛化最好。具体选哪个值、怎么判断「泛化最好」,课件末页留成了问题,由下一份课件回答。
课件里的坑
- [课件留白] p.31 的三张分类图课件只提问没给答案;对照 p.30,从左到右是欠拟合、刚好、过拟合(p.31)
- [课件留白] p.36 的 λ = 0.0001、0.01、1 是那个演示数据的专属数字,换问题最优 λ 完全不同(p.36)
- [课件留白] p.39 的三个带走问题课件没给答案;L1 和 L2 的区别在 p.35 只给了公式,稀疏性等说法是课外补充(p.39)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写 L2 正则化的 J,回查两个最容易错的地方:惩罚项从 j = 1 开始、惩罚项在方括号里;再把完整例题的六张图逐一判断;最后用 θ₁ = 14/(14 + λ) 自己算两个 λ,看最优参数怎样往 0 走。
必背
- 欠拟合对应 high bias,过拟合对应 high variance;过拟合的标志是训练集 J ≈ 0 但新样本预测差,处理办法是减特征或正则化
- L2 正则化代价函数 J(θ) = (1/2m)[Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)² + λ Σ_{j=1}^{n} θⱼ²],惩罚项从 j = 1 起、θ₀ 不罚;L1 = Lasso 用 |θⱼ|,L2 = Ridge 用 θⱼ²,λ 是超参数
- 把四次多项式的 θ₃、θ₄ 压到接近 0,它就退化成二次曲线;参数越小假设越简单,越不容易过拟合
- λ 是过拟合和欠拟合之间的旋钮:λ = 0 等于没正则化(过拟合),λ 太大把参数全压没(欠拟合),中间某个值泛化最好
- 三点例子加 L2 正则(θ₀ = 0):最优 θ₁ = 14/(14 + λ),λ = 0 时 1,λ = 1 时约 0.933,λ = 14 时 0.5;λ 越大越往 0 拉
- 过拟合是所有监督模型的通病:分类问题里决策边界越扭曲、越迁就个别点,越可能是过拟合
课件例题
例 1(课件 p.30):房价回归的三张图各是什么拟合状态?
见下方完整例题。
例 2(课件 p.31):逻辑回归的三条决策边界各是什么拟合状态?
见下方完整例题。
例 3(课件 p.33):为什么压小 θ₃、θ₄ 就能防过拟合?
题面:左图是二次曲线 θ₀ + θ₁x + θ₂x²;右图是四次多项式 θ₀ + θ₁x + θ₂x² + θ₃x³ + θ₄x⁴,θ₃x³ 和 θ₄x⁴ 两项被打了叉。课件写:Suppose we penalize and make θ₃, θ₄ really small.
提示
系数接近 0 的那一项,对曲线形状还有多大影响?
解答
θ₃、θ₄ 接近 0 时,x³、x⁴ 两项几乎贡献不了什么,四次多项式实际上退化成左边那条二次曲线。特征一个没删,只是让高次项的系数几乎不起作用。做法是在要最小化的目标后面加上对 θ₃、θ₄ 的大额惩罚,梯度下降为了让总代价小,只好把它们压下去。
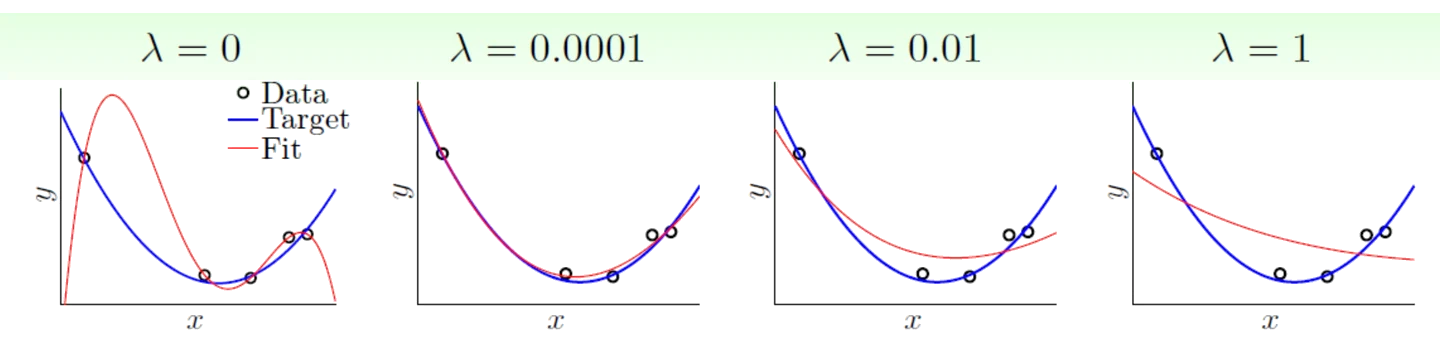
例 4(课件 p.36):λ 取 0、0.0001、0.01、1 时,拟合曲线各是什么样?
题面:四张小图,同一组数据点、同一条 U 形目标曲线,只有 λ 不同,底部写着 Generalization。
提示
λ = 0 是没有正则化;λ 越大,参数越被往 0 压。
解答
λ = 0:剧烈摆动,精确穿过每个点,过拟合。λ = 0.0001:几乎和目标曲线重合。λ = 0.01:比目标曲线平缓,稍有偏离。λ = 1:近似一条直线,欠拟合。λ 从 0 往上调,模型从过拟合一路滑到欠拟合,中间某处泛化最好。这几个具体数值只对这个演示数据成立。
例 5(课件 p.39):三个带走的问题怎么回答?
题面:① L1 和 L2 正则化在线性回归里的实际差别是什么,哪个更好?② 怎么选学习率 α 和正则化系数 λ 这类超参数?③ 怎么评估模型的表现?
提示
① 从「罚绝对值」和「罚平方」对小参数、大参数的影响去想。② 和 ③ 要用到训练集之外的数据。
解答
课件没给答案,以下是常见答法。① L1 罚绝对值,会把不重要的参数精确压成 0,相当于自动做特征选择;L2 罚平方,把所有参数都压小但一般不归零,对大参数惩罚更重。想删特征选 L1,只想稳定防过拟合选 L2。② 和 ③ 是下一份课件的内容:划分训练、验证、测试集,在验证集上比较不同取值,再用测试集评估。
完整例题
题面(课件 p.30–31):(1)同一组五个房价点,三个模型分别是 θ₀ + θ₁x、θ₀ + θ₁x + θ₂x²、θ₀ + θ₁x + θ₂x² + θ₃x³ + θ₄x⁴,曲线依次是两侧偏得明显的直线、贴近各点的平滑曲线、精确穿过每个点的扭曲曲线。(2)两类点的分类问题,g 是 sigmoid 函数,三个模型分别是 g(θ₀ + θ₁x₁ + θ₂x₂)、加入 x₁²、x₂²、x₁x₂ 的二次式、加入大量高次交叉项的式子,边界依次是两侧都有分错点的直线、大致分开两类的平滑曲线、把每个点都圈对的弯曲边界。判断六张图各是什么状态,对应 bias 还是 variance,过拟合时怎么处理。
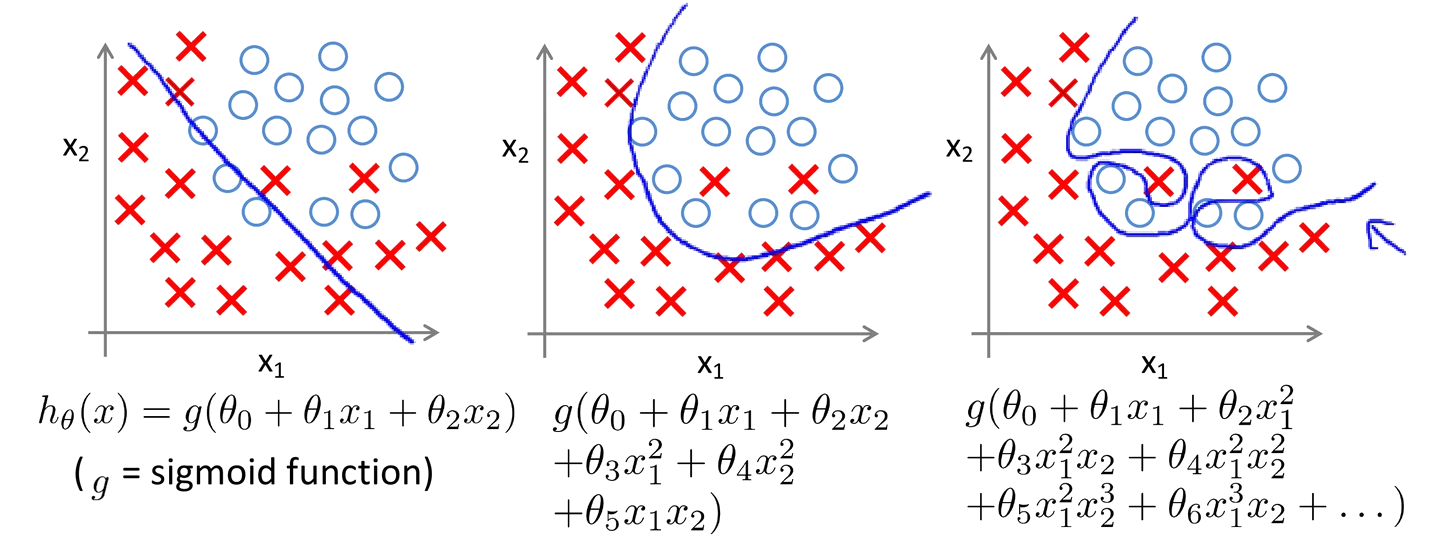
约定:只看图形和模型复杂度判断,不需要算 J。
解法:
- 回归左图:欠拟合,high bias。直线跟不上数据的弯曲,训练集上误差都大。
- 回归中图:刚好。二次曲线贴近各点又平滑,对新房子的预测也最可靠。
- 回归右图:过拟合,high variance。五个点、五个参数,曲线精确穿过每一个,训练集 J ≈ 0;但两点之间扭来扭去,新房子一来就预测离谱。
- 分类三图同理:左边直线边界欠拟合,中间平滑曲线刚好,右边绕着每个点转圈的边界过拟合。课件只提问没给答案,按回归版的对照推出。
- 判断标准统一:看模型是否在迁就个别点。越扭曲、在训练集上越完美,越要怀疑过拟合。
- 处理办法:减少特征,比如删掉高次项;或者正则化,保留全部特征但把参数压小。
要点:训练集上的误差只能发现欠拟合,发现不了过拟合;过拟合必须用新样本检验。
答题格式:画一张「图 / 状态 / bias 或 variance / 理由」四列表,六行各一句理由,最后一行写处理办法。
变式题(先自己做)
(1) 改编自课件 p.11–12、p.35:三点 (1,1)、(2,2)、(3,3),θ₀ 固定为 0,加 L2 正则。λ = 28 时最优 θ₁ 是多少?λ 要取多大,最优 θ₁ 才会降到 0.25? (2) 改编自课件 p.35:同样的设定,λ = 14、θ₁ = 1 时加上惩罚后的 J 是多少?和 θ₁ = 0.5 时比,哪个更小?说明什么? (3) 自编情境:一个模型训练误差 0.02、新数据误差 4.5。同事建议把 λ 从 0.01 调到 0。这个建议对吗?
提示
(1) 用 θ₁ = 14/(14 + λ),第二问反过来解方程。(2) 把 θ₁ 代进 (1/6)[14(θ₁ − 1)² + λθ₁²]。(3) 先判断这是过拟合还是欠拟合,再想 λ 变小会让哪种毛病更重。
判分点与答案(非官方评分标准)
判分点:① (1) 两问都要写出代入过程;② (2) 两个 J 都要算出来再比较;③ (3) 要先判断状态,再说 λ 的方向。
(1) λ = 28:θ₁ = 14/42 ≈ 0.333。要 θ₁ = 0.25:14/(14 + λ) = 0.25,14 + λ = 56,λ = 42。
(2) θ₁ = 1:平方误差部分 0,惩罚 14 × 1 = 14,J = 14/6 ≈ 2.33。θ₁ = 0.5:(1/6)[14 × 0.25 + 14 × 0.25] = 7/6 ≈ 1.17,更小。说明加了重惩罚后,完美贴合训练数据的 θ₁ = 1 不再是最优,模型宁可少贴一点数据换取更小的参数。
(3) 不对。训练误差很小、新数据误差很大,是过拟合。λ 调到 0 等于取消正则化,过拟合会更严重。应该把 λ 调大,或者减少特征。
闪卡自测
1. 过拟合的定义是什么?对应 bias 还是 variance?
模型把训练集拟合得极好(J ≈ 0)但对新样本失效。过拟合对应 high variance,欠拟合对应 high bias(p.30)。
2. 处理过拟合的两条路是什么?
一是减少特征,手动挑选或用模型选择算法;二是正则化,保留全部特征但把参数值压小,适合特征多且每个都有一点用的情况(p.32)。
3. 为什么「参数小」就能防过拟合?
参数越小,假设越简单。高次项的系数接近 0 时,那一项几乎不起作用,曲线退化成低次的平滑形状(p.33–34)。
4. 写出 L2 正则化的代价函数,惩罚项的求和从几开始?
J(θ) = (1/2m)[Σ_{i=1}^{m}(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)² + λ Σ_{j=1}^{n} θⱼ²]。从 j = 1 开始,θ₀ 不罚;惩罚项在方括号内(p.35)。
5. L1 和 L2 各叫什么、惩罚项各是什么?
L1 叫 Lasso,惩罚 λΣ|θⱼ|;L2 叫 Ridge,惩罚 λΣθⱼ²(p.35)。
6. λ 从 0 调大会发生什么?
λ = 0 等于没正则化,可能过拟合;λ 太大参数全被压没,欠拟合;中间某个值泛化最好(p.36)。
7. 三点例子加 L2 正则,最优 θ₁ 的公式是什么?λ = 1 时是多少?
θ₁ = 14/(14 + λ)。λ = 1 时约 0.933,比不加正则时的 1 小。
8. 加了正则化,训练集上的误差会变大还是变小?
变大或不变。正则化主动放弃一部分训练集精度,换来更小的参数和更好的泛化。
9. λ 和 α 有什么共同点?
都是超参数,由人设定,不靠梯度下降学出来。怎么选它们是下一份课件的内容(p.35、p.39)。
下一讲
课件末页留的三个问题:怎么划分训练集和测试集、怎么选 α 和 λ、怎么诊断偏差与方差,在本周第三份课件里回答,见 L04c-1。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。