L04b-3 同时更新与学习率:两个参数怎么一起走,步子迈多大
在参数平面上逐帧对比同时更新和顺序更新,用三点例子手算三种学习率的走法,再看为什么线性回归不会卡在局部最低点。
一句话版
梯度下降真正跑起来时有两处要小心:两个参数要用同一组旧值算坡度、再一起改;步长 α 要适中,太小走不动,太大会跳过碗底甚至越跳越远。
读之前最好先懂梯度下降的更新式,见 L04b-2。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| simultaneous update | 同时更新 | 先把所有新值算好,再一次性写回去 |
| sequential update | 顺序更新 | 算一个改一个,后面的用的是已经改过的值 |
| temp0, temp1 | 临时变量 | 暂存新值的格子,等全部算完再赋给 θ |
| 收敛 | converge | 越走越接近碗底,最后基本不动 |
| 发散 | diverge | 越走离碗底越远 |
| 局部最低点 | local minimum | 周围一小片里最低,但不一定是全局最低 |
| 凸函数 | convex function | 碗形,只有一个最低点 |
一个类比:摄影师给两个人调站位
摄影师拍了一张照片,看着这张照片说:左边的人往左挪一步,右边的人往前挪半步。两条指令都来自同一张照片,两个人一起动。这是同时更新。
另一种做法:摄影师先让左边的人挪,然后重拍一张,再根据新照片指挥右边的人。右边那条指令看的是一张已经变了的画面,和第一条指令不在同一个基准上。这是顺序更新。
步长也一样。摄影师说「挪一步」,你挪了五步,就会冲过头,摄影师只好喊你往回走,一来一回可能越喊越远。
类比在哪里失效:
- 拍照时顺序调整往往也能调好,只是多拍几张。梯度下降里顺序更新算出的方向本身就偏了,课件把它判为错误的实现。
- 人冲过头会自己减速。梯度下降不会,α 太大时每一步都按同样的比例放大偏差。
从零讲起
1. 同时更新
它解决什么问题
线性回归有 θ₀、θ₁ 两个参数,每个都要按自己的偏导更新。问题是:先改了 θ₀,再算 θ₁ 的偏导时用新 θ₀ 还是旧 θ₀?两种做法结果不一样,只有一种是梯度下降的本意。
直觉
梯度是「站在当前这一点」量出来的坡度。两个偏导必须在同一个点上量,合起来才是这一点最陡的下坡方向。
先挪了 θ₀,人已经站到另一个点上,这时再量 θ₁ 方向的坡,量的就是别处的坡了。所以要先把两个新值都算好,放在 temp0、temp1 里,最后一起写回。
一步一步看
目标:从同一个起点分别做同时更新和顺序更新,看两种做法落点差了多少,为什么顺序更新让 J 偏高。
三个点 (1,1)、(2,2)、(3,3),起点 (θ₀, θ₁) = (0, 0.5),α = 0.1。下面的图横轴是 θ₀、纵轴是 θ₁,一个点就是一组参数。
-
在起点算两个偏导:∂J/∂θ₀ = −1,∂J/∂θ₁ ≈ −2.33。
-
同时更新:temp0 = 0 − 0.1 × (−1) = 0.1,temp1 = 0.5 − 0.1 × (−2.33) ≈ 0.733,再一起赋值。参数一步斜着走到 (0.1, 0.733),J 从 0.58 降到约 0.118。
-
顺序更新:先把 θ₀ 改成 0.1,人站到 (0.1, 0.5)。在这里重新算 θ₁ 的偏导,误差变成 −0.4、−0.9、−1.4,偏导约 −2.13。θ₁ 只走到 0.5 + 0.213 ≈ 0.713。
-
两种做法差了 0.02,顺序更新后的 J 约 0.139,比同时更新的 0.118 高。一步的差距不大,可每一步都偏,多步之后就会累积。
怎么算
正确顺序是四行:
temp0 := θ₀ − α · ∂J/∂θ₀ temp1 := θ₁ − α · ∂J/∂θ₁ θ₀ := temp0 θ₁ := temp1
意思是:前两行算新值时,右边的 θ₀、θ₁ 都还是旧的;后两行才写回。只要「算」全部在「写」之前,就是同时更新。
常见误解
以为只要用了 temp 变量就是同时更新
看顺序,不看有没有 temp。课件里错误的那个版本也用了 temp0、temp1,但它算完 temp0 立刻写回 θ₀,然后才算 temp1,temp1 用的就是新 θ₀。
以为顺序更新只是慢一点,结果一样
它在半新半旧的点上算坡度,方向本身就不对。课件的评语是会引入 bias and instability,即偏差和不稳定。
试一下
四行代码的顺序是:temp0 := …;θ₀ := temp0;temp1 := …;θ₁ := temp1。这是同时更新吗?
不是同时更新。第三行算 temp1 时,θ₀ 已经被第二行改掉了。把第二行挪到 temp1 那一行之后就对了。
2. 学习率 α
它解决什么问题
更新式里的 α 由人来定。它决定每一步按坡度的多少倍去走。取得不合适,梯度下降要么慢得没法用,要么根本停不下来。
直觉
α 小,每步只走一点,方向一直对,但要走很多步。α 大,一步就可能迈过碗底,落到对面的碗壁上。对面的坡度方向相反,下一步又往回跳。
如果每次跳过去都比上次离碗底更近,还算能收敛,只是左右摇摆;如果每次都更远,就越跳越高,叫发散。
一步一步看
目标:从同一个 θ₁ 出发只换 α 走四步,看步子太小、合适和太大时分别是稳步靠近、来回收敛和发散。
三点例子,θ₀ 固定为 0,都从 θ₁ = 0.5 出发,只换 α。
-
α = 0.1:0.5 → 0.733 → 0.858 → 0.924 → 0.96。一直在碗底左边,稳步靠近 1。
-
α = 0.3:0.5 → 1.2 → 0.92 → 1.032 → 0.987。第一步就跨过碗底,之后左右摆动,摆幅越来越小,仍然收敛。
-
α = 0.5:0.5 → 1.67 → 0.11 → 2.19 → −0.58。每次跨过碗底都落得更远,J 从 0.58 涨到约 5.8,发散。
-
把四步后的结果并排比较:
α 四步后 θ₁ 四步后 J 走法 0.1 0.96 0.004 单边稳步靠近 0.3 0.987 0.0004 来回摆,越摆越小 0.5 −0.58 5.8 来回跳,越跳越远 -
下图左边是 α 小的稳步下降,右边是 α 太大的发散:
怎么算
这个例子里,走一步之后 (θ₁ − 1) 会乘上一个固定因子 (1 − 14α/3)。
意思是:因子在 0 和 1 之间,每步离碗底的距离按比例缩小,单边收敛;因子在 −1 和 0 之间,每步跳到对面但距离缩小,摆动收敛;因子小于 −1,每步跳到对面且距离放大,发散。α = 0.1 时因子 0.53,α = 0.3 时 −0.4,α = 0.5 时 −1.33。
让因子等于 −1,解出分界 α = 6/14 ≈ 0.43。超过它就发散。这个分界只对这三个点成立,换一组数据就要重算,但「因子绝对值大于 1 就发散」的机制是通用的。
常见误解
以为 α 越大越快
α 在一定范围内变大确实更快,过了分界就会发散,一步也到不了。上面 α = 0.5 比 α = 0.3 大,结果却离碗底越来越远。
以为 θ₁ 在碗底两边来回跳就是出错了
来回跳本身不一定是错。α = 0.3 时也在跳,但摆幅越来越小,仍然收敛。要看的是摆幅在变大还是变小。
试一下
α = 0.2 时因子是多少?从 θ₁ = 0.5 走一步到哪?
1 − 14 × 0.2 / 3 ≈ 0.067。θ₁ − 1 从 −0.5 变成约 −0.033,θ₁ ≈ 0.967,一步就到了碗底附近。
3. 凸函数与局部最低点
它解决什么问题
梯度下降只看脚下的坡,走到坡度为 0 的地方就停。如果曲面上有好几个低谷,它停下来的地方未必是最低的那个。要知道线性回归会不会遇到这个问题,就得看它的 J 长什么样。
直觉
想象一片起伏的丘陵,有两个山谷。从左边出发会滚进左边的谷,从右边出发会滚进右边的谷,两个谷的深度可能不一样。这种有多个低谷的曲面叫非凸。
碗不一样。碗只有一个底,从碗壁上哪一点出发,一直往下走都会到同一个底。这种形状叫凸函数。
一步一步看
目标:在波浪曲线和碗形曲线上各放两个起点,看前者可能停在不同谷底,而线性回归的碗只有一个底。
-
看左边的波浪曲线:它有两个谷底。
-
起点 A 在左边山坡上,沿下坡走进左边的谷底。
-
起点 B 在右边山坡上,走进右边的谷底。两个起点,两个终点。
-
再看右边的碗:左右各放一个起点,都走到同一个碗底。
-
线性回归的 J 属于右边这种:一个参数时是抛物线,两个参数时是碗形曲面。
怎么判断
拿到一个问题,先问 J 是不是凸的。
凸:只有一个最低点,梯度下降只要 α 合适,从任何起点出发都走到同一个全局最优。非凸:可能有多个局部最低点,起点不同,结果可能不同。线性回归的平方误差代价函数是凸的,属于前一种。
常见误解
拿课件那张多峰曲面来回答线性回归的问题
那张曲面是为了演示「一般函数」画的,不是线性回归的 J。考试问「线性回归的梯度下降会不会陷入局部最优」,答不会,理由是 J 是凸的。
试一下
线性回归里,两个同学用不同的初始 θ 跑梯度下降,α 都合适,最后得到的参数会一样吗?
会一样,至少会无限接近同一组参数。J 是凸的碗,只有一个最低点,起点只影响走几步,不影响终点。
把它们串起来
上一页给了更新式,这一页讲真正跑起来时的两个细节。
第一个细节在「同一步之内」:所有偏导都要在同一个点上算,先全部存进 temp,再一起写回。先改一个再算另一个,坡度就是在半新半旧的点上量的,方向会偏。
第二个细节在「步与步之间」:α 决定每步按坡度走多远。太小走得慢,太大跳过碗底;跳过去的距离越来越大就发散。三点例子里的分界是 α ≈ 0.43。
只要这两处都做对,起点就无所谓。线性回归的 J 是凸的碗,没有局部最低点的陷阱,从哪里出发都走到同一个碗底。下一页换个问题:碗底一定好吗?训练集上误差最小的模型,也可能是最糟的模型。
课件里的坑
- [课件留白] p.20–21 的多峰曲面并非线性回归的 J,是为了演示「随机初始化可能走到不同谷底」画的一般情况;线性回归的 J 只有一个底(p.15、p.20)
- [课件留白] p.27 只画了 α 太小、太大两张手绘图,没给数值,也没说怎么选 α;三种 α 的数值是用 p.12 的三点例子补算的(p.27)
- [看清代码] p.25 的两个版本都用了 temp0、temp1,区别只在赋值语句的位置,考试别只看有没有 temp(p.25)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写同时更新的四行代码,标出哪两行必须在前;再从 (0, 0.5) 出发、α = 0.1,分别用两种方式算一步,对一下 0.733 和 0.713;最后用因子 (1 − 14α/3) 判断 α = 0.1、0.3、0.5 各是什么走法。
必背
- 两个参数必须同时更新:temp0、temp1 都用旧 θ 算完再一起赋值;先更新 θ₀ 再算 θ₁ 的梯度是错的
- 课件对两种实现的评语:同时更新 ensures consistency,顺序更新 can introduce bias and instability
- α 太小收敛慢,α 太大跨过碗底来回震荡甚至发散
- 三点例子里每步 (θ₁ − 1) 乘上因子 (1 − 14α/3):α = 0.1 时 0.53,α = 0.3 时 −0.4,α = 0.5 时 −1.33;绝对值大于 1 就发散,分界 α ≈ 0.43
- 非凸曲面上初始点不同可能走到不同的局部最低点;线性回归的 J 是凸的碗,只有一个最低点,不会陷入局部最优
课件例题
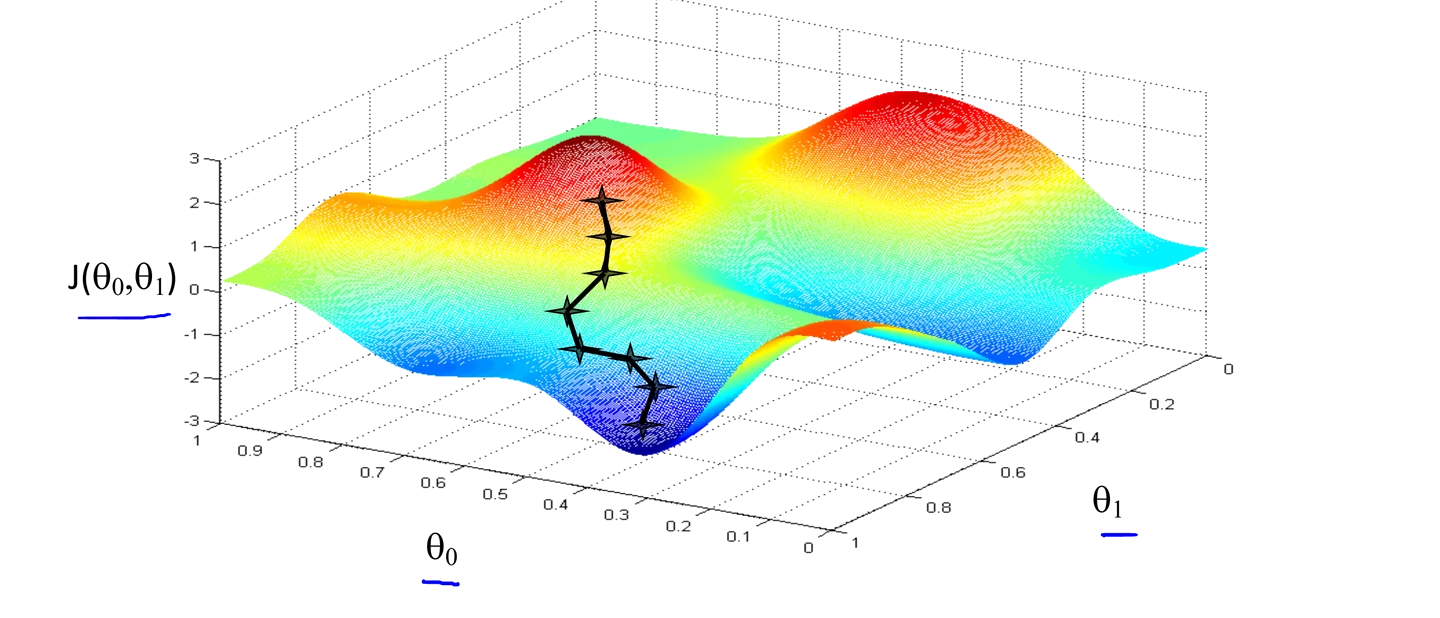
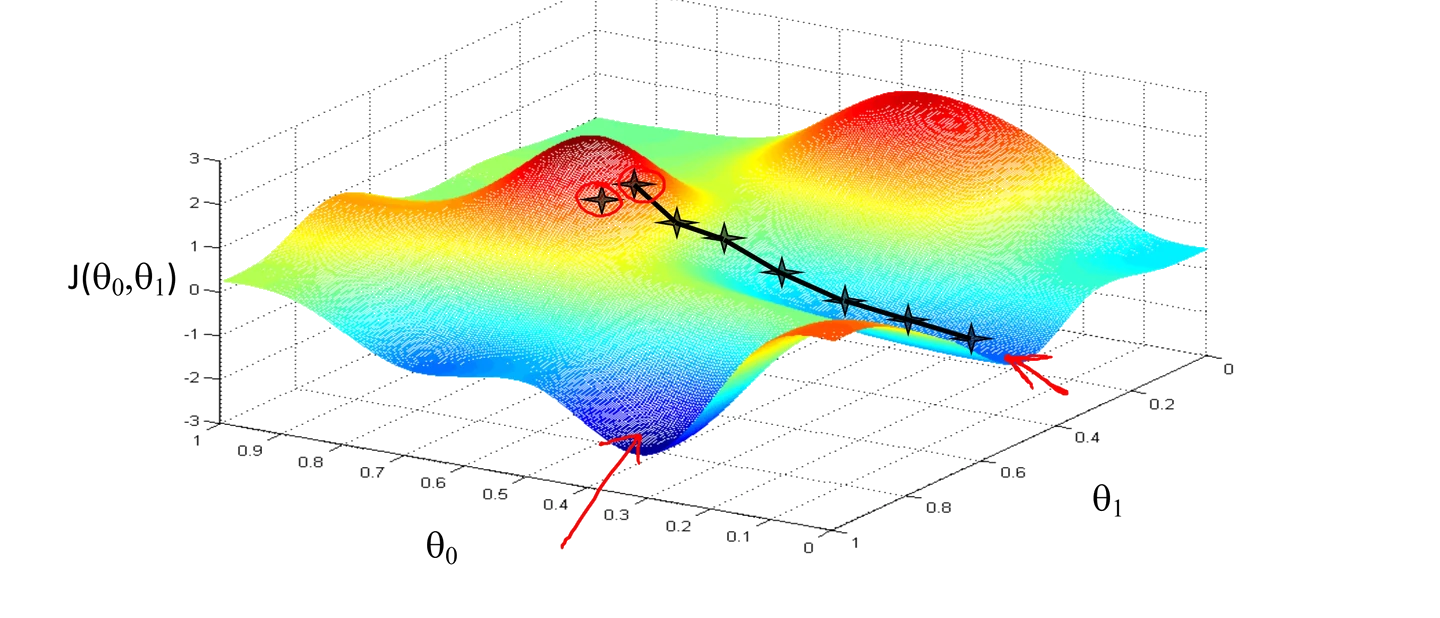
例 1(课件 p.20–21):两次梯度下降为什么停在不同地方?
题面:同一张三维曲面,有两个山峰、两个谷底。p.20 的路径从一处出发走到一个谷底,p.21 起点换了位置,走到另一个谷底。
提示
梯度下降只看脚下的坡。问自己:这张曲面有几个低谷?
解答
这张曲面是非凸的,有两个局部最低点。梯度下降从哪里出发,就沿下坡滚进离得最近的那个谷,所以起点不同、终点不同。这张图演示的是一般函数;线性回归的 J 是凸的碗,没有这个问题。
例 2(课件 p.25–26):两种实现里哪一种是错的?
见下方完整例题。
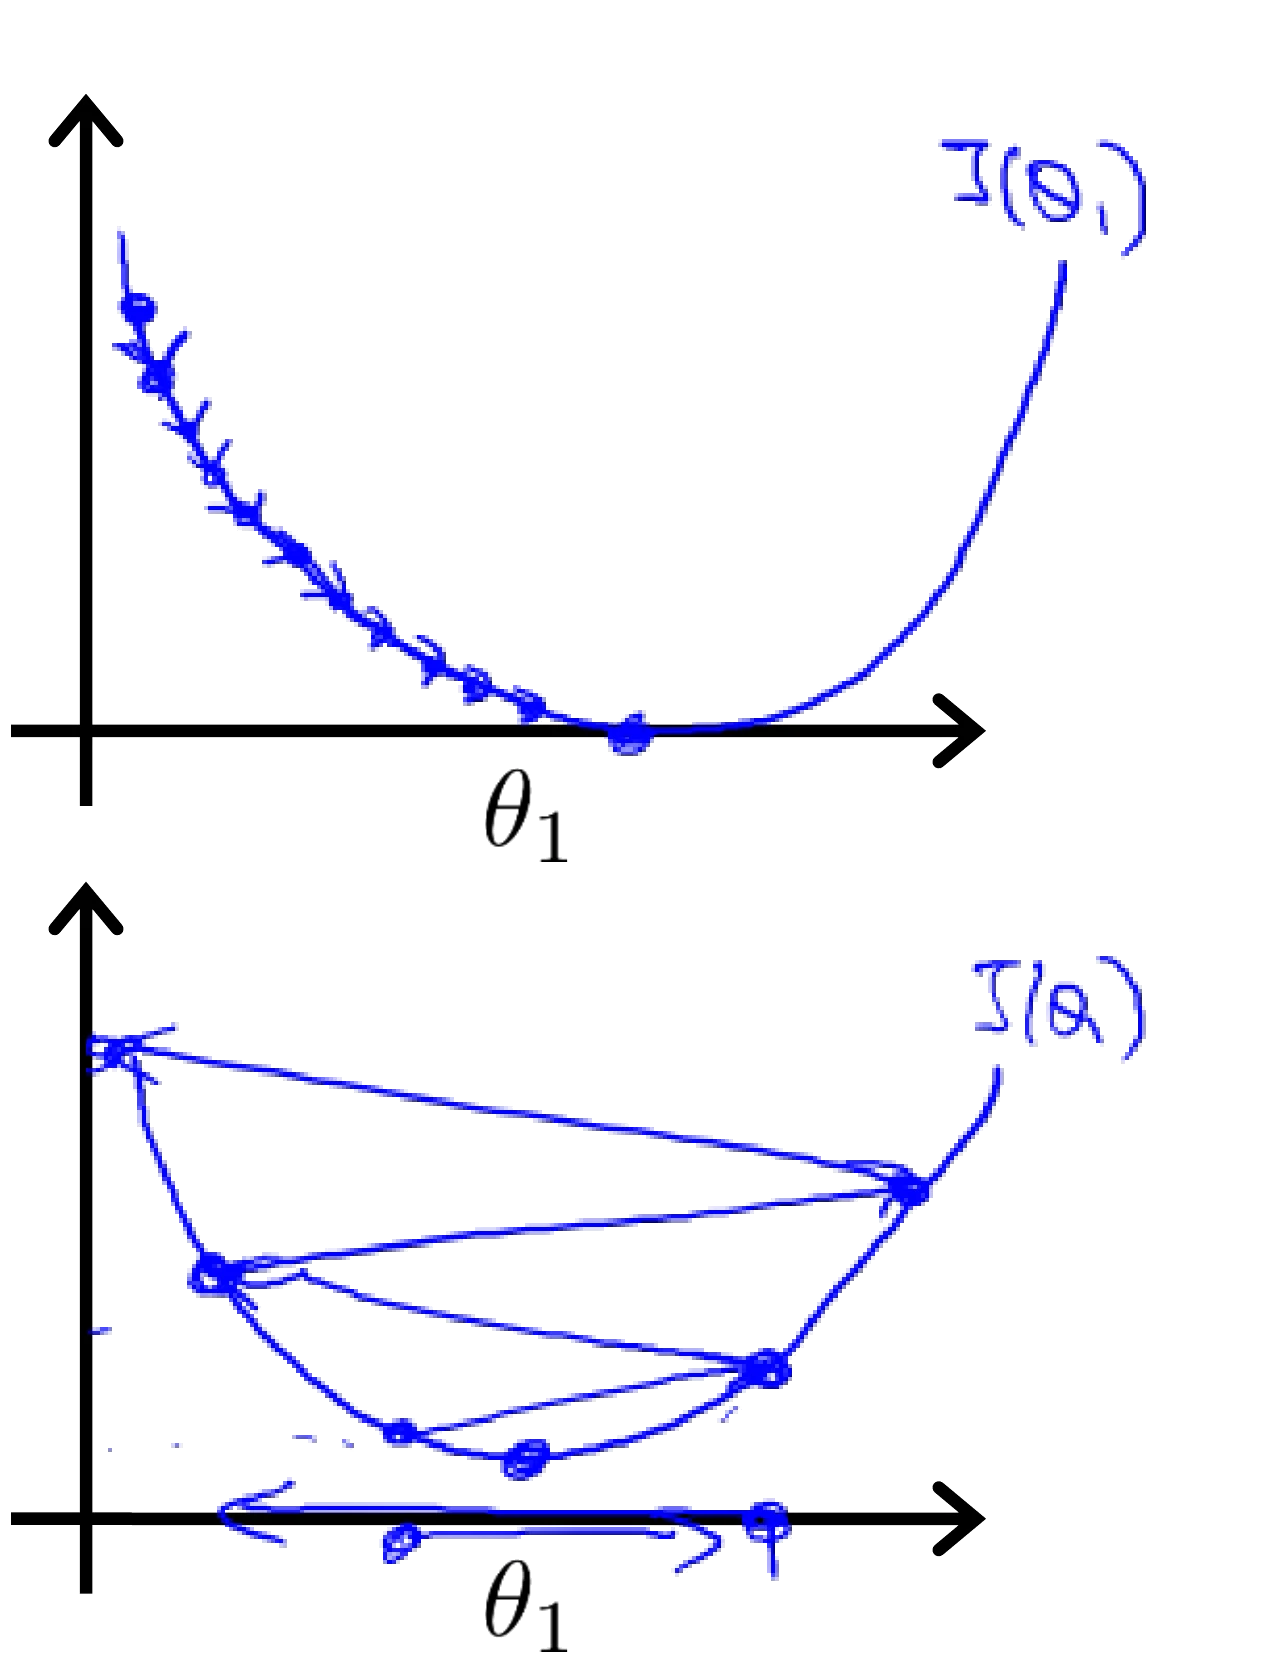
例 3(课件 p.27):学习率 α 太小、太大分别会怎样?
题面:两张手绘的 J(θ₁) 曲线,一张步子密密麻麻,一张每步都跨过碗底。
提示
想一下每步走的距离是 α 乘什么,α 大到一定程度时会落在哪里。
解答
α 太小,每步只走一点,梯度下降很慢,但能走到底。α 太大,会跨过最低点(overshoot),可能不收敛,甚至发散。三点例子里 α = 0.5 就会发散,10 步后 θ₁ 跑到约 −7.9。
完整例题
题面(课件 p.25–26):两种实现梯度下降的代码。A:temp0 := θ₀ − α∂J/∂θ₀;temp1 := θ₁ − α∂J/∂θ₁;θ₀ := temp0;θ₁ := temp1。B:temp0 := θ₀ − α∂J/∂θ₀;θ₀ := temp0;temp1 := θ₁ − α∂J/∂θ₁;θ₁ := temp1。哪个是错的?用三点 (1,1)、(2,2)、(3,3),起点 (0, 0.5),α = 0.1 各算一步,比较结果。
约定:偏导用上一页的两条式子:∂J/∂θ₀ = (1/m)Σeᵢ,∂J/∂θ₁ = (1/m)Σeᵢx⁽ⁱ⁾,eᵢ = θ₀ + θ₁x⁽ⁱ⁾ − y⁽ⁱ⁾。
解法:
- 判断:B 错,错在第三行。算 temp1 时 θ₀ 已经被第二行改成新值。
- A 的第一、二行:在 (0, 0.5) 处误差 −0.5、−1、−1.5,∂J/∂θ₀ = −1,∂J/∂θ₁ = −7/3 ≈ −2.333。temp0 = 0.1,temp1 = 0.5 + 0.2333 = 0.7333。
- A 的结果:(θ₀, θ₁) = (0.1, 0.7333)。误差 −0.1667、−0.4333、−0.7,平方和约 0.706,J ≈ 0.118。
- B 的前两行:temp0 = 0.1,立刻写回,θ₀ = 0.1。
- B 的第三行:在 (0.1, 0.5) 处误差 −0.4、−0.9、−1.4,Σeᵢx⁽ⁱ⁾ = −0.4 − 1.8 − 4.2 = −6.4,∂J/∂θ₁ ≈ −2.133,temp1 = 0.5 + 0.2133 = 0.7133。
- B 的结果:(0.1, 0.7133),J ≈ 0.139,比 A 高。
- 课件评语:A ensures consistency and alignment with optimization theory;B can introduce bias and instability。
要点:两个偏导必须在同一个点上算。判断代码对不对,只看「所有 temp 是否在任何 θ 被改写之前算完」。
答题格式:先指出错在哪一行、为什么;再分两栏写 A、B 的计算过程,最后比较两个结果和 J。
变式题(先自己做)
(1) 改编自课件 p.25–26:三个点不变,起点改成 (θ₀, θ₁) = (0.5, 0.5),α = 0.1。分别用同时更新和顺序更新算一步。 (2) 改编自课件 p.27:三点例子、θ₀ 固定为 0。α 取多少时一步正好落在碗底?α 取多少时开始发散? (3) 自编情境:有人跑梯度下降,发现 J 每一步都在变大。说出两个可能的原因。
提示
(1) 先算起点的三个误差和两个偏导;顺序更新时 θ₁ 的偏导要在新 θ₀ 处重算。(2) 用因子 (1 − 14α/3):等于 0 是什么意思,等于 −1 是什么意思。(3) 一个和 α 有关,一个和更新式的符号有关。
判分点与答案(非官方评分标准)
判分点:① (1) 两种方式的 θ₁ 必须不同,且要写出顺序更新重算的偏导;② (2) 两个 α 都要给出由来;③ (3) 至少答出 α 太大。
(1) 起点误差 0、−0.5、−1。∂J/∂θ₀ = −1.5/3 = −0.5,∂J/∂θ₁ = (0 − 1 − 3)/3 ≈ −1.333。同时更新:(0.55, 0.633)。顺序更新:θ₀ 先变 0.55,误差变成 0.05、−0.45、−0.95,Σeᵢx⁽ⁱ⁾ = 0.05 − 0.9 − 2.85 = −3.7,偏导 ≈ −1.233,θ₁ ≈ 0.623,得 (0.55, 0.623)。
(2) 因子为 0 时一步到底:14α/3 = 1,α = 3/14 ≈ 0.214。因子为 −1 时开始发散:14α/3 = 2,α = 6/14 ≈ 0.43,大于它就发散。
(3) 一是 α 太大,每次跨过碗底都落得更远;二是更新式符号写反成加号,变成梯度上升。顺序更新一般只让方向偏一点,不至于每步都变大。
闪卡自测
1. 什么是同时更新?写出四行代码。
所有新值都用旧参数算完再一起写回。temp0 := θ₀ − α∂J/∂θ₀;temp1 := θ₁ − α∂J/∂θ₁;θ₀ := temp0;θ₁ := temp1(p.25)。
2. 顺序更新错在哪?课件怎么评价?
算 θ₁ 的偏导时 θ₀ 已经是新值,坡度在半新半旧的点上量。课件说它 can introduce bias and instability(p.26)。
3. 从 (0, 0.5)、α = 0.1 出发,同时更新和顺序更新各到哪里?
同时更新到 (0.1, 0.733);顺序更新时 θ₀ 先变 0.1,θ₁ = 0.5 + 0.213 ≈ 0.713,少走一截。
4. α 太小和太大各会怎样?
太小收敛很慢;太大跨过碗底,来回震荡,甚至发散(p.27)。
5. 三点例子里 (θ₁ − 1) 每步乘上什么因子?α = 0.1、0.3、0.5 各是多少?
(1 − 14α/3)。分别是 0.53、−0.4、−1.33(p.27 注解补算)。
6. 因子为负但绝对值小于 1,是什么走法?
每步跳到碗底另一边,但离碗底越来越近,摆动收敛。
7. 线性回归的梯度下降会不会陷入局部最优?
不会。J 是凸的碗,只有一个最低点,任何起点都走到同一处(p.15)。
8. p.20–21 那张多峰曲面说明了什么?能拿来回答线性回归的问题吗?
说明一般非凸函数上起点不同可能走到不同的局部最低点。它不是线性回归的 J,不能拿来回答线性回归会不会陷入局部最优(p.20–21)。
下一讲
梯度下降能把 J 压到碗底,可训练集上误差最小,不等于对新数据预测最准。下一页讲过拟合和正则化,见 L04b-4。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。