L04b-2 梯度下降:沿着坡度一步步走到碗底
先补斜率、导数和偏导数,再一帧一帧手算梯度下降在三点例子上怎么移动,最后推出线性回归的两条更新式。
一句话版
梯度下降是找碗底的办法:在当前位置量一下坡度,往下坡的方向挪一小步,再量、再挪,直到走不动为止。
读之前最好先懂代价函数 J 和那只碗,见 L04b-1。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 斜率 | slope | 往右走一步,高度变多少 |
| 导数 | derivative,记作 dJ/dθ | 曲线在某一点的斜率 |
| 偏导数 | partial derivative,记作 ∂J/∂θⱼ,读「偏 J 偏 θⱼ」 | 别的参数不动,只动一个时的斜率 |
| 梯度 | gradient | 把所有参数的偏导排在一起,指向上坡最陡的方向 |
| α | 读「阿尔法」,学习率 | 每步走多远,由人设定 |
| := | 读「更新为」 | 用右边算出的新值覆盖左边的旧值 |
一个类比:浓雾里下山
你站在山坡上,雾大得只能看清脚下一小块地。你想走到山谷最低处,但看不到谷底在哪。
能做的只有一件事:低头看脚下哪边往下倾斜,就往那边迈一步。迈完再看,再迈。坡陡的时候,一步下降很多;快到谷底时坡变缓,每步下降得也少。地面变平、往哪边都不再下降时,你就到了谷底。
梯度下降就是这个动作的数学版。山的高度是代价函数 J,你站的位置是当前参数 θ,「看脚下的坡」是算导数,「迈一步」是更新参数,步长由学习率 α 决定。
类比在哪里失效:
- 真实的山可能有好几个山谷,走进哪个看运气。线性回归的 J 是一只碗,只有一个底,从哪儿出发都走到同一处。
- 人下山会看坡大概往哪边。梯度下降不用猜,导数是算出来的,正负号直接告诉你往哪走。
从零讲起
1. 先补一块:斜率和导数(补充)
它解决什么问题
梯度下降每一步都要知道「当前位置往哪边是下坡、坡有多陡」。对直线来说这个数就是斜率。可 J 是一条弯曲线,每个位置的陡度都不一样,需要一个办法量出某一个点上的斜率,这就是导数。
从哪来(补充)
导数最直观的意思,就是曲线在某一点切线的斜率。今天常用的 dy/dx 这种写法叫 Leibniz 记号,由 Leibniz 在 1675 年引入。课件里的 ∂J/∂θ 就是从这种写法变来的。
直觉
在曲线上取两个点,连一条直线,这条线叫割线,它的斜率很好算:高度差除以水平差。
让第二个点慢慢往第一个点靠,割线会慢慢转,最后贴着曲线只碰一下,这就是切线。切线的斜率就是导数。
一步一步看
目标:把割线的第二个点一步步挪近 θ₁ = 0.5,看割线斜率怎样朝 −2.33 靠拢,得到这一点的导数。
用上一页的碗 J(θ₁) = (14/6)(θ₁ − 1)²,量 θ₁ = 0.5 这一点的斜率。第一个点固定在 (0.5, 0.58),每一帧把第二个点往它身边挪。
-
第二个点取 θ₁ = 1.5。两点一样高,割线是水平的,斜率 0。这个数离真实坡度差得远。
-
第二个点取 θ₁ = 1,也就是碗底。高度从 0.58 降到 0,水平走了 0.5,斜率约 −1.17。
-
第二个点取 θ₁ = 0.6。水平差只剩 0.1,斜率约 −2.1。
-
再缩到水平差 0.01,斜率约 −2.31。数字稳稳地朝 −2.33 靠拢,这个极限就是 θ₁ = 0.5 处的导数。
怎么算
对 J(θ₁) = (14/6)(θ₁ − 1)² 求导,得 dJ/dθ₁ = (28/6)(θ₁ − 1)。代入 θ₁ = 0.5,得 (28/6) × (−0.5) ≈ −2.33。
意思是:在 θ₁ = 0.5 这一点,θ₁ 往右挪一点点,J 会以大约 2.33 倍的速度往下降。导数是负数,就说明往右是下坡。
判断方向只看正负号:导数为负,参数该变大;导数为正,参数该变小;导数为 0,已经在平地上。
常见误解
以为导数是两个点之间的平均变化
两个点之间的叫割线斜率,是平均变化。导数是第二个点无限靠近时的极限,只属于一个点。上面第 1 帧的割线斜率是 0,可 θ₁ = 0.5 处明明在下坡,差别就在这里。
试一下
用 dJ/dθ₁ = (28/6)(θ₁ − 1),算 θ₁ = 1.5 和 θ₁ = 1 处的导数,各说明什么?
θ₁ = 1.5:(28/6) × 0.5 ≈ 2.33,正数,往右是上坡,该往左走。θ₁ = 1:导数 0,在碗底,已经不用动了。
2. 偏导数(补充)
它解决什么问题
上一个概念只有一个参数 θ₁。线性回归有 θ₀ 和 θ₁ 两个参数,J 是一张曲面,每个方向的坡度不一样。偏导数把问题拆开:一次只看一个参数方向的坡度。
直觉
站在碗形曲面上,先只朝正东看,量东西方向的坡度;再只朝正北看,量南北方向的坡度。两个数分别告诉你 θ₀ 和 θ₁ 各该往哪边调。
算其中一个的时候,另一个参数当成常数,就像它被钉住不动。
一步一步看
目标:从 (0, 0.5) 出发每次只动一个参数,看两个方向的坡度各是多少,哪个更陡。
还是三个点 (1,1)、(2,2)、(3,3),从 (θ₀, θ₁) = (0, 0.5) 出发。
-
先算起点的 J:误差 −0.5、−1、−1.5,平方和 3.5,J = 0.58。
-
钉住 θ₁ = 0.5,只把 θ₀ 从 0 挪到 0.1。误差变成 −0.4、−0.9、−1.4,平方和 2.93,J ≈ 0.49。
-
换一个方向:钉住 θ₀ = 0,只把 θ₁ 从 0.5 挪到 0.6。J ≈ 0.37。
-
两个方向各量一次坡度,整理成表:
只动哪个 挪动量 J 从 0.58 变到 粗略坡度 精确偏导 θ₀ +0.1 0.49 −0.95 −1 θ₁ +0.1 0.37 −2.1 −2.33 -
两个坡度都是负的,所以两个参数都该变大;θ₁ 方向更陡,它该挪得更多。
怎么算
∂J/∂θ₀ 和 ∂J/∂θ₁ 的写法和导数一样,只是 d 换成了 ∂。
意思是:∂J/∂θ₁ 就是把 θ₀ 当成一个固定的数,对 θ₁ 求普通导数。两个偏导排在一起写成 (∂J/∂θ₀, ∂J/∂θ₁),叫梯度,它指向上坡最陡的方向,所以下山要往它的反方向走。
常见误解
以为偏导要把两个参数一起挪
算偏导时只挪一个,其他全部钉住。两个一起挪量到的是斜着走的坡度,既不是 ∂J/∂θ₀ 也不是 ∂J/∂θ₁。
试一下
在起点 (0, 0.5),如果 ∂J/∂θ₀ 是 +1 而不是 −1,θ₀ 该往哪边调?
偏导为正,说明 θ₀ 变大 J 会上升,所以 θ₀ 该变小。参数的调整方向永远和偏导的符号相反。
3. 梯度下降
它解决什么问题
上一页的碗,三个点时能直接写出通式、一眼看出碗底。真实问题里参数可能有几百个,数据有成千上万行,没法把整个碗画出来。梯度下降只需要知道「当前位置的坡度」,就能一步步往碗底走。
从哪来(补充)
一般认为梯度下降由法国数学家 Cauchy 在 1847 年最早提出,Hadamard 在 1907 年又独立提出了类似的方法。维基百科的条目也用了浓雾里下山的比喻:看不到全局,只看脚下哪边最陡,就往那边走。
出处:Wikipedia: Gradient descent
直觉
每一步做同一件事:新位置 = 旧位置 − 步长 × 坡度。
坡度为负(往右是下坡),减一个负数等于往右走;坡度为正,就往左走。坡越陡,坡度的绝对值越大,这一步走得越远;越接近碗底,坡越平,步子自然越来越小,不用人去调。
一步一步看
目标:从 θ₁ = 0.5 出发用 α = 0.1 走三步,看 J 怎样往下降,步长怎样随坡变缓一步比一步短。
三点例子,θ₀ 固定为 0,从 θ₁ = 0.5 出发,学习率 α = 0.1。每一帧青绿的点是当前位置,青绿箭头是这一步。
-
起点 θ₁ = 0.5,J ≈ 0.58。这里的导数是 −2.33,负的,要往右走。
-
第一步:0.5 − 0.1 × (−2.33) ≈ 0.733。J 从 0.58 降到约 0.17。
-
第二步:新位置的导数是 (28/6) × (0.733 − 1) ≈ −1.24,坡已经缓了。0.733 − 0.1 × (−1.24) ≈ 0.858,J 约 0.05。
-
第三步:导数约 −0.66,0.858 − 0.1 × (−0.66) ≈ 0.924,J 约 0.013。
-
三步的步长是 0.233、0.125、0.066,每一步都比上一步短。继续走下去会无限接近 1,但每步只走剩余距离的一部分。
怎么算
θⱼ := θⱼ − α · ∂J/∂θⱼ
意思是:对每个参数 θⱼ,算出 J 对它的偏导,乘上学习率 α,再从原值里减掉。一直重复,直到 J 几乎不再下降。课件的手绘图写成 θ_new = θ_old − α·δJ/δθ,是同一个式子。
常见误解
以为每一步走的距离就是 α
每步走的距离是 α 乘以坡度。α 固定,坡度越来越小,所以步子越来越短。上面三步 α 都是 0.1,步长却一步比一步短,第三步只有第一步的三成左右。
以为更新式里的减号可以换成加号
换成加号就是往上坡走,叫梯度上升,J 会越来越大。找最小值必须用减号。
试一下
同一只碗,从 θ₁ = 1.5 出发,α = 0.1,走一步到哪?
导数 (28/6) × 0.5 ≈ 2.33,正的,往左走。1.5 − 0.1 × 2.33 ≈ 1.267,从右侧碗壁往碗底靠了一步。
4. 代入线性回归:两条更新式
它解决什么问题
更新式 θⱼ := θⱼ − α·∂J/∂θⱼ 对任何可导的 J 都成立。要真的跑起来,得把线性回归的 J 代进去,把两个偏导算成能直接用数据计算的式子。
直觉
J 是一堆「误差的平方」加起来。对平方求导,2 被带下来,正好和 J 前面的 1/2 约掉,剩下误差本身。
再看误差 θ₀ + θ₁x − y 里面:对 θ₀ 求导,θ₀ 的系数是 1;对 θ₁ 求导,θ₁ 的系数是 x。这就是两条式子唯一的差别。
一步一步看
目标:对线性回归的 J 分别求两个偏导、代回更新式,再用三点数据验算,看算出的坡度和前面量的一致。
-
写出 J:(1/2m) Σ (θ₀ + θ₁x⁽ⁱ⁾ − y⁽ⁱ⁾)²。
-
对 θ₀ 求偏导:平方带下 2,和 1/2 约掉;括号里 θ₀ 的系数是 1。得 (1/m) Σ (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)。
-
对 θ₁ 求偏导:同样约掉 2;括号里 θ₁ 的系数是 x⁽ⁱ⁾。得 (1/m) Σ (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)·x⁽ⁱ⁾。
-
代回更新式,就是课件的两条式子:
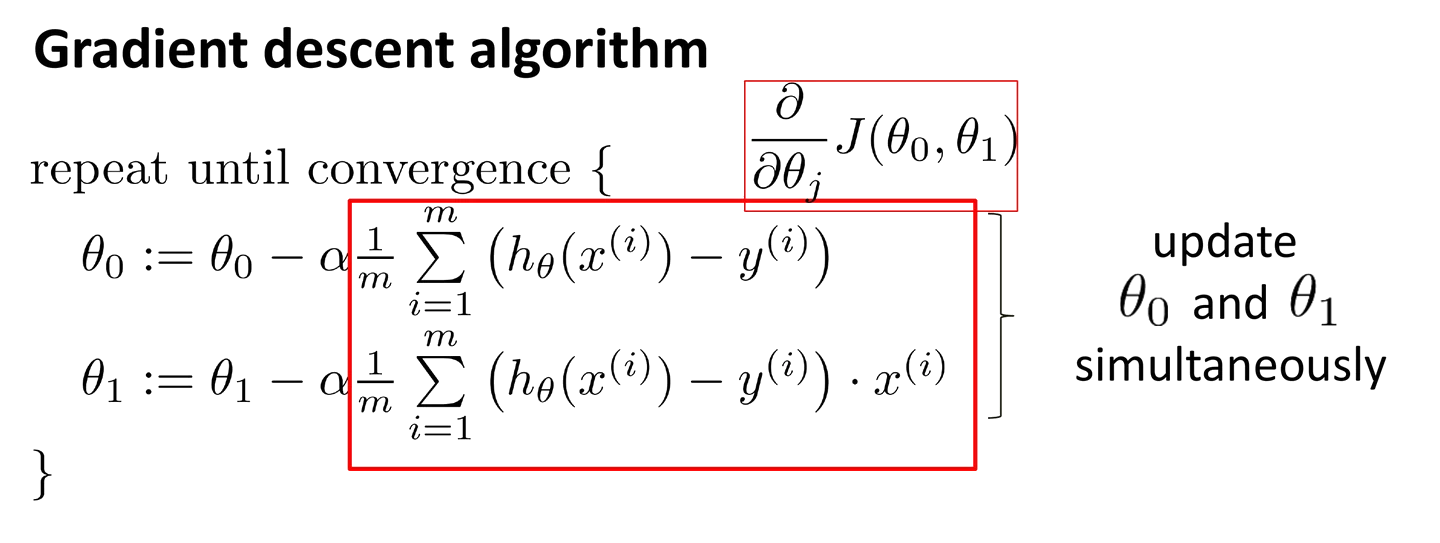
图片来源:COMP5511 Lecture 4 Machine Learning Part I-2, p.23 -
用三点数据验算,起点 θ₀ = 0、θ₁ = 0.5:
点 误差 h − y 误差 × x (1,1) −0.5 −0.5 (2,2) −1 −2 (3,3) −1.5 −4.5 合计 −3 −7 除以 m = 3 −1 −2.33 -
表最后一行就是两个偏导:∂J/∂θ₀ = −1,∂J/∂θ₁ ≈ −2.33,和上一个概念里量出来的坡度一致。
怎么算
θ₀ := θ₀ − α (1/m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)
θ₁ := θ₁ − α (1/m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾) · x⁽ⁱ⁾
意思是:先用当前参数算出每个样本的误差。θ₀ 那条直接把误差求平均;θ₁ 那条先让每个误差乘上自己的 x 再求平均。两个平均数各乘 α,从对应参数里减掉。
常见误解
求和里面还写着平方
求导之后平方已经变成一次项,括号里是误差本身,不再有平方。系数也从 1/2m 变成 1/m,原因同一个:平方带下来的 2 被约掉了。
θ₀ 那条也乘了 x⁽ⁱ⁾
θ₀ 在误差里的系数是 1,所以它的偏导不乘 x。只有 θ₁ 那条乘 x⁽ⁱ⁾。如果约定 x₀ = 1,两条可以统一写成乘 xⱼ⁽ⁱ⁾,但课件是分开写的。
试一下
只有一个样本 (2, 3),θ₀ = 1、θ₁ = 1,算两个偏导。
预测 1 + 2 = 3,误差 0,两个偏导都是 0。这个点已经被直线穿过,参数不用动。
把它们串起来
梯度下降要的东西只有一个:当前位置的坡度。
坡度从导数来。导数是切线的斜率,正负号告诉你往哪边是下坡,大小告诉你坡有多陡。参数不止一个时,就一个一个算偏导,每次只动一个参数、其余钉住。
有了坡度,更新式 θⱼ := θⱼ − α·∂J/∂θⱼ 让参数往下坡挪一步。坡陡步大,坡缓步小,到碗底时坡度为 0,参数自己停下来。
把线性回归的 J 代进去,两个偏导都能直接用数据算出来:θ₀ 那条是误差的平均,θ₁ 那条是误差乘 x 的平均。下一页讲两个细节:两个参数要同时更新,以及 α 取多大才不会出事。
课件里的坑
- [课件有误] p.24 右栏那张外来的推导截图,Now, 下面第三行写成 (1/m)(h_Θ(xᵢ) − y)xᵢ,前两行都有的求和号 Σ 丢了,y 也丢了下标;到 Therefore, 的框里求和号又回来。以 p.23 的两条式子为准(p.24)
- [课件留白] p.24 右栏最终式末尾统一乘 xᵢ,只对 θ₁ 成立;要覆盖 θ₀ 需要约定 x₀ = 1,课件没写这个约定(p.24)
- [记号] p.19 的手绘图把偏导写成 δJ/δθ,p.22 起统一用 ∂,是同一个东西(p.19)
- [课件留白] p.18 说重复更新直到 hopefully 走到最小值;hopefully 指一般函数可能停在局部最低点,线性回归的碗没有这个问题(p.18)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写通用更新式和线性回归的两条更新式;再用三个点、θ₁ = 0.5、α = 0.1 自己算两步梯度下降,写出每一步的导数;最后回查两个最容易错的地方:求和里没有平方,θ₀ 那条不乘 x。
必背
- 导数是曲线在某点切线的斜率:负数说明往右走会下降,正数说明往右走会上升,绝对值越大坡越陡
- 偏导数 ∂J/∂θⱼ:其他参数固定不动,只动 θⱼ 时 J 变化的坡度
- 梯度下降更新式 θⱼ := θⱼ − α·∂J/∂θⱼ:减号让参数往下坡方向走,α 是学习率,「:=」读「更新为」
- 线性回归的两条更新式:θ₀ := θ₀ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾);θ₁ := θ₁ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)·x⁽ⁱ⁾;θ₁ 那条末尾多乘 x⁽ⁱ⁾,系数都变成 1/m
- 三点例子 θ₀ = 0、θ₁ = 0.5、α = 0.1:∂J/∂θ₁ = −7/3 ≈ −2.33,一步后 θ₁ ≈ 0.733;越靠近碗底坡越缓,步子自动变小
课件例题
例 1(课件 p.19):更新式 θ_new = θ_old − α·δJ/δθ 里每一部分是什么意思?
题面:手绘的碗形 J(θ) 曲线,标出当前点和切线,下方写着这条更新式。
提示
分别问自己:δJ/δθ 的正负号代表什么?为什么前面是减号?α 管什么?
解答
δJ/δθ 是当前点切线的斜率,也就是偏导(课件这里用 δ,后面统一写 ∂)。斜率为正说明往右是上坡,减掉它就往左走;斜率为负则往右走,总是走向下坡。α 是学习率,决定每步迈多大。整个式子用新值覆盖旧值,反复执行。
例 2(课件 p.22–23):推出线性回归两条更新式里的偏导
见下方完整例题。
例 3(课件 p.24):找出右栏推导截图里的错误
题面:右栏是一张推导截图,从 ∂J/∂Θ 开始,经过 Now, 下面三行,到 Therefore, 框里的最终式。
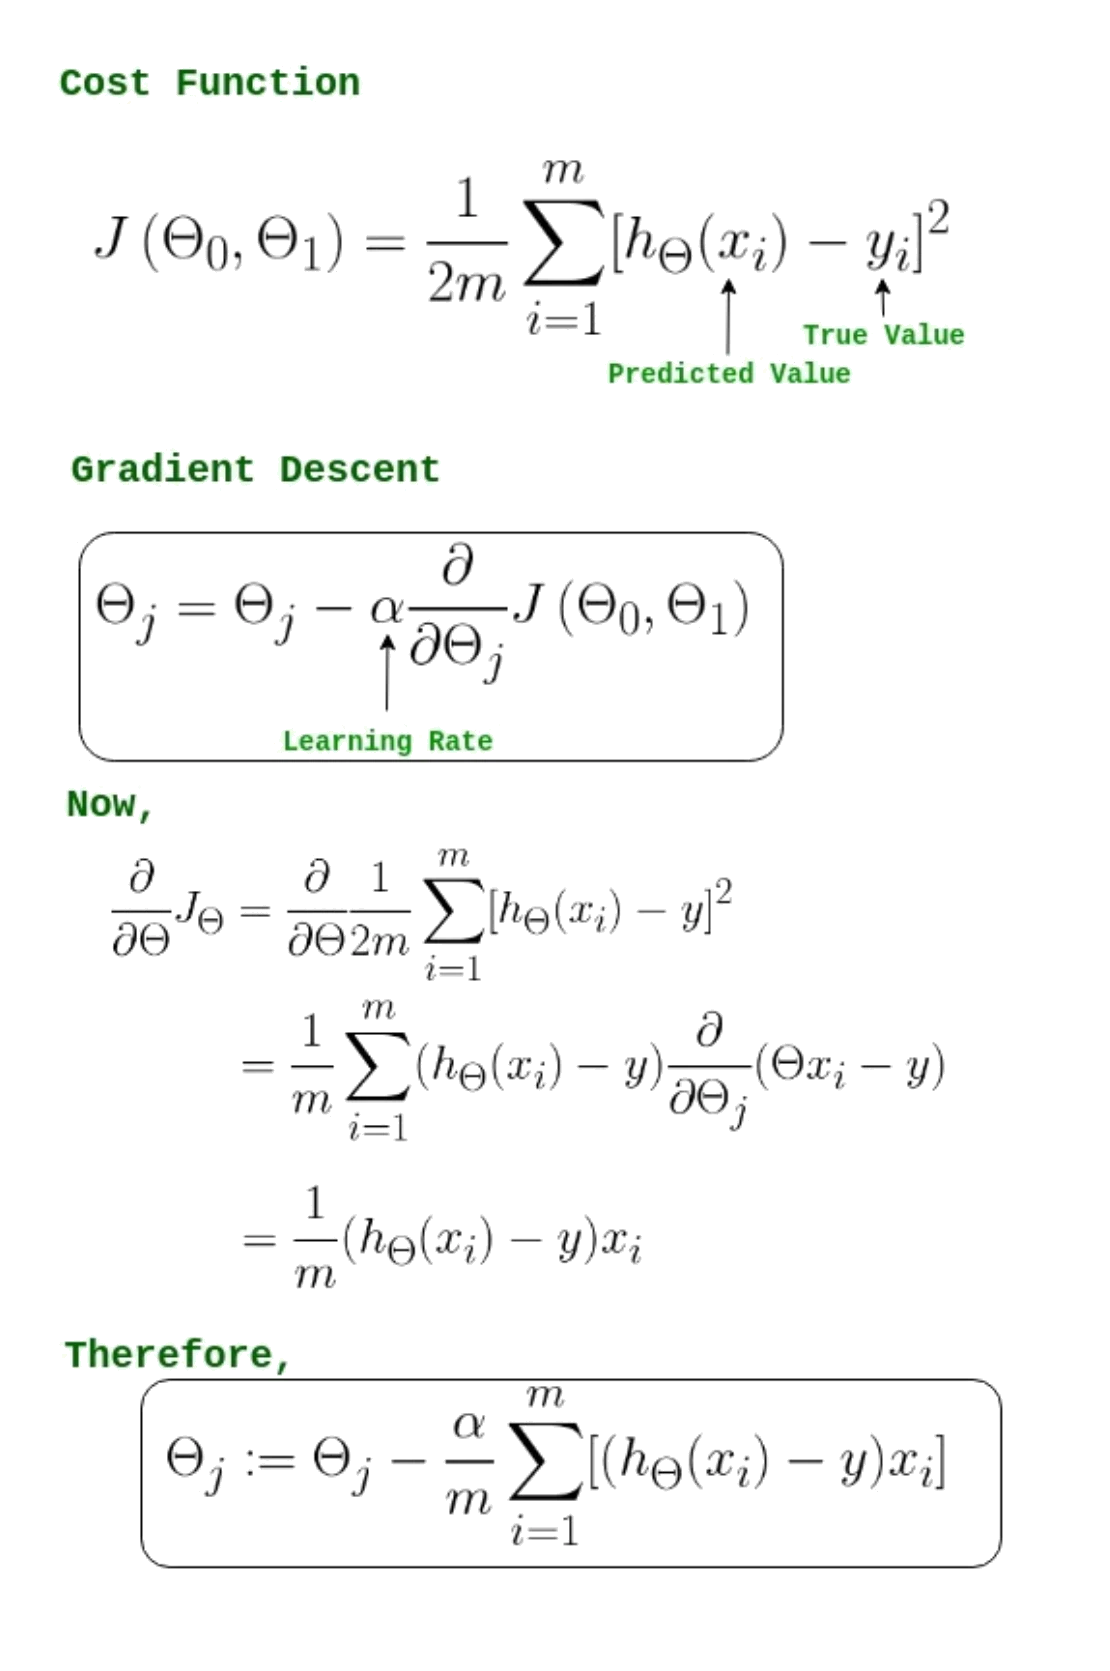
提示
逐行对照求和号 Σ 和下标 i 是否一直都在。
解答
Now, 下面第三行丢了求和号 Σ,y 也丢了下标 i,写成了单个样本的式子;到 Therefore, 框里求和号又回来了。另外最终式统一乘 xᵢ,要对 θ₀ 也成立,得先约定 x₀ = 1,截图没写。考试以 p.23 的两条式子为准。
完整例题
题面(课件 p.22–23):线性回归 J(θ₀, θ₁) = (1/2m) Σ (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²,h_θ(x) = θ₀ + θ₁x。推出 ∂J/∂θ₀ 和 ∂J/∂θ₁,写出两条更新式,并用三个点 (1,1)、(2,2)、(3,3) 在 θ₀ = 0、θ₁ = 0.5 处验算。
约定:误差 eᵢ = h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾ = θ₀ + θ₁x⁽ⁱ⁾ − y⁽ⁱ⁾。
解法:
- 链式法则:J = (1/2m) Σ eᵢ²,所以 ∂J/∂θⱼ = (1/2m) Σ 2eᵢ · ∂eᵢ/∂θⱼ = (1/m) Σ eᵢ · ∂eᵢ/∂θⱼ。
- 对 θ₀:∂eᵢ/∂θ₀ = 1,得 ∂J/∂θ₀ = (1/m) Σ eᵢ。
- 对 θ₁:∂eᵢ/∂θ₁ = x⁽ⁱ⁾,得 ∂J/∂θ₁ = (1/m) Σ eᵢ x⁽ⁱ⁾。
- 代回:θ₀ := θ₀ − α(1/m)Σeᵢ;θ₁ := θ₁ − α(1/m)Σeᵢx⁽ⁱ⁾。
- 验算:误差 −0.5、−1、−1.5。Σeᵢ = −3,∂J/∂θ₀ = −1。Σeᵢx⁽ⁱ⁾ = −0.5 − 2 − 4.5 = −7,∂J/∂θ₁ = −7/3 ≈ −2.33。
- 和单参数结果对比:上一页的通式求导 (28/6)(0.5 − 1) ≈ −2.33,一致。
要点:平方带下来的 2 和 1/2 约掉,所以系数是 1/m、括号里没有平方;θ₁ 那条多乘 x⁽ⁱ⁾,是因为 θ₁ 在误差里的系数是 x⁽ⁱ⁾。
答题格式:先写 eᵢ 的定义,再分别写两个偏导的推导,各一行写出「∂eᵢ/∂θⱼ = ?」,最后写两条更新式。
变式题(先自己做)
(1) 改编自课件 p.11–12、p.23:三个点、θ₀ 固定为 0,从 θ₁ = 0 出发,α = 0.1,走一步梯度下降。新 θ₁ 是多少?J 降了多少? (2) 改编自课件 p.23:两个样本 (1, 2)、(2, 3),θ₀ = 0、θ₁ = 1,求 ∂J/∂θ₀ 和 ∂J/∂θ₁。 (3) 自编情境:有人把 θ₁ 的更新式写成 θ₁ := θ₁ + α(1/m)Σ(h − y)x。从 θ₁ = 0.5 出发,在三点例子上会发生什么?
提示
(1) 先算三个误差和 Σ误差×x,再代更新式;J 可用通式 (14/6)(θ₁ − 1)²。(2) 照完整例题第 5 步列表。(3) 看符号:加号让参数往哪个方向走。
判分点与答案(非官方评分标准)
判分点:① (1) 要写出偏导的值和符号;② (2) 两个偏导要分开写,θ₀ 那条不乘 x;③ (3) 要说出往哪个方向走、J 怎么变。
(1) θ₁ = 0 时误差 −1、−2、−3,Σ误差×x = −1 − 4 − 9 = −14,偏导 −14/3 ≈ −4.67。新 θ₁ = 0 − 0.1 × (−4.67) ≈ 0.467。J 从 14/6 ≈ 2.33 降到 (14/6)(0.533)² ≈ 0.66。
(2) 预测 1、2,误差 −1、−1。∂J/∂θ₀ = (1/2)(−2) = −1;∂J/∂θ₁ = (1/2)(−1 − 2) = −1.5。
(3) 偏导仍是 −2.33,加号让 θ₁ 变成 0.5 + 0.1 × (−2.33) ≈ 0.267,往左离开碗底,J 升到约 1.25。这是梯度上升,每步都往上坡走,会越来越远。
闪卡自测
1. 导数的几何意思是什么?正负号各说明什么?
曲线在某点切线的斜率。负数:往右是下坡;正数:往右是上坡;0:在平地上(p.19)。
2. 割线斜率和导数有什么区别?
割线斜率是两点之间的平均变化;导数是第二个点无限靠近时的极限,只属于一个点。
3. 偏导数 ∂J/∂θ₁ 怎么算?
把其他参数当成固定的数,只对 θ₁ 求普通导数(p.22)。
4. 写出通用的梯度下降更新式,说出每个符号的意思。
θⱼ := θⱼ − α·∂J/∂θⱼ。:= 是更新为,α 是学习率,∂J/∂θⱼ 是坡度,减号让参数往下坡走(p.18、p.19)。
5. 写出线性回归的两条更新式,它们差在哪?
θ₀ := θ₀ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾);θ₁ := θ₁ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)·x⁽ⁱ⁾。唯一差别是 θ₁ 那条末尾多乘 x⁽ⁱ⁾(p.23)。
6. 为什么更新式里的系数是 1/m,括号里没有平方?
对平方求导会带下一个 2,和 J 前面的 1/2 约掉,平方变成一次项(p.22–23)。
7. α 不变,为什么越靠近碗底步子越小?
步长是 α 乘坡度,碗底附近坡度越来越小,步长跟着变小,到碗底坡度为 0 就停下。
8. 三点例子 θ₀ = 0、θ₁ = 0.5、α = 0.1,走一步后 θ₁ 是多少?
∂J/∂θ₁ = −7/3 ≈ −2.33,θ₁ = 0.5 + 0.233 ≈ 0.733(p.22–23)。
9. p.24 那张推导截图错在哪?
Now, 下第三行丢了求和号 Σ 和 y 的下标;最终式统一乘 xᵢ,需要 x₀ = 1 的约定,截图没写(p.24)。
下一讲
两个参数一起走时,更新的先后顺序会不会影响结果?α 取太大会怎样?下一页讲同时更新和学习率,见 L04b-3。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。