L09d 动态路由与胶囊网络:权重 c 怎么一轮轮调出来
胶囊层的第四步:b 从 0 开始,每轮用 softmax 得到权重 c,算出输出 v,再把每个输入和 v 的内积加回 b。和 v 方向一致的输入越分越多,输出最后落在一团意见一致的输入中间。这一页手算三轮路由,再看几层胶囊怎么叠成胶囊网络。
一句话版
胶囊层加权求和用的权重 c 不靠训练,每次前向计算时现算:先让所有输入平分,算出输出 v,再看每个输入和 v 有多一致,一致的下一轮多分一点。这样反复几轮就是动态路由。
把一层普通卷积、几层胶囊、一个全连接解码器接起来,就是课件里的胶囊网络。
先认识这几个词
读之前要记得上一页的 û、c、s、squash,还要会算向量内积和 softmax。
| 词 | 写法 | 一句人话 |
|---|---|---|
| 动态路由 | dynamic routing | 一轮轮调整权重 c 的循环 |
| b_ij | 路由 logit | 还没 softmax 的权重,从 0 开始累加 |
| softmax | 归一化指数 | 把一组数变成加起来为 1 的正数 |
| agreement | 一致程度 | 内积 û_i · v_j,越大越一致 |
| K | 迭代轮数 | 路由循环跑几轮 |
| 胶囊网络 | CapsNet | 由胶囊层叠起来的网络 |
一个类比:小组讨论定方案
三个人给出各自的方案,组长先把三人意见平均,得到一个初稿。然后看谁的方案和初稿最接近,下一轮给他更多话语权,重新汇总。
几轮下来,和大多数人方向一致的意见分量越来越重,跑偏的那个人话语权越来越小,最终方案落在主流意见中间。
类比在哪里失效:
- 小组讨论里人会改主意。û 在路由过程中不变,变的只有权重 c。
- 组长判断「接近」靠感觉。路由用内积来量,而且是把内积累加进 b,不是每轮重算。
- 讨论可以一直开到大家满意。路由只跑固定的 K 轮,原论文用的是 3 轮。
从零讲起
1. 动态路由算法
它解决什么问题
上一页 Step 2 的加权和 s_j = Σ c_ij û_i 里,权重 c_ij 还没定。全取一样太粗糙:方向跑偏的输入会把输出拉歪。需要一个办法,让和大家一致的输入多说话。
直觉
先平分,算出一个输出 v。拿每个 û 和 v 做内积:方向一致,内积大;方向偏离,内积小甚至为负。把内积加到 b 上,下一轮 softmax 时 b 大的拿到更大的 c。
输出由输入加权得到,权重又由输出决定,这个回路就是课件图里从 v_j 绕回 c 的那支箭头。
一步一步看
目标:用三个二维的 û 手算三轮路由,看权重 c 怎样从平分变成偏向一团。
-
课件的算法是一个循环:初始化 b = 0,然后每轮 softmax、算 s 和 v、更新 b。
-
取 û_1 = (2, 1)、û_2 = (2, 0)、û_3 = (−1, 2),一个输出胶囊。第 1 轮 b 全是 0,c 都是 1/3,s = (1, 1),v ≈ (0.471, 0.471)。内积 û · v ≈ (1.414, 0.943, 0.471),加到 b 上。
-
第 2 轮:c = softmax(b) ≈ (0.497, 0.310, 0.193),s ≈ (1.420, 0.883),v ≈ (0.625, 0.389)。û_3 和 v 的内积只有 0.153,b 拉开差距。
-
第 3 轮:b ≈ (3.054, 2.194, 0.624),c ≈ (0.662, 0.280, 0.058),v ≈ (0.734, 0.313),长度 0.797。
-
三轮对比:跑偏的 û_3 权重 0.333 → 0.193 → 0.058;û_1、û_2 合计 0.667 → 0.807 → 0.942。
| 轮 | c(û_1, û_2, û_3) | v | ‖v‖ |
|---|---|---|---|
| 1 | 0.333, 0.333, 0.333 | (0.471, 0.471) | 0.667 |
| 2 | 0.497, 0.310, 0.193 | (0.625, 0.389) | 0.737 |
| 3 | 0.662, 0.280, 0.058 | (0.734, 0.313) | 0.797 |
怎么算
初始化 b_ij = 0;每轮:c_·j = softmax(b_·j),s_j = Σ_i c_ij û_i,v_j = squash(s_j),b_ij ← b_ij + û_i · v_j
意思是:b 是累加的分数,每轮把「这一轮的一致程度」加进去;c 是把分数换成加起来为 1 的比例。课件对固定的输出 j,在所有输入 i 之间做 softmax。
上面这个例子里 û_2 单个的权重从 1/3 降到 0.280,因为 û_1 更长,内积更大,抢走了更多份额。
常见误解
以为路由时 W 或 û 也在更新
一次前向计算里,路由只改 b 和 c,û 固定不变。W 是靠反向传播在训练中更新的,和路由的循环是两回事。
以为 b 每轮重新等于内积
b 是累加的:b ← b + û · v。第 3 轮的 b 是前两轮内积之和,所以差距会越拉越大。
试一下
只有两个输入,b = (1, 0),softmax 后 c 是多少?(e ≈ 2.718)
c_1 = 2.718 / (2.718 + 1) ≈ 0.731,c_2 ≈ 0.269。
2. 动态路由学到了什么
它解决什么问题
算法会算了,还要能回答课件的问题:What does dynamic routing learn? 也就是说这个循环跑完,输出向量和输入向量之间是什么关系。
直觉
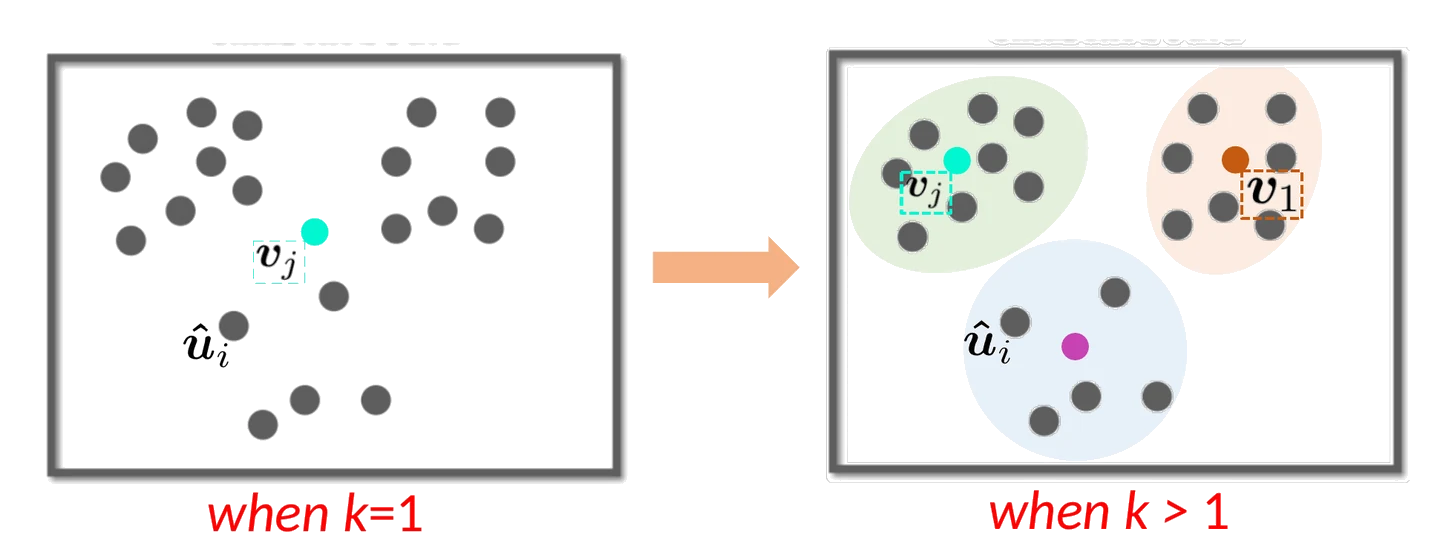
每轮输出 v 都向「和自己一致的那些 û」靠近一点,跑偏的 û 越来越没话语权。几轮之后 v 落在一团彼此一致的 û 中间,很像聚类里的簇中心。
有好几个输出胶囊时,每个输出各自吸住一团输入,输入就被分成了几团。
一步一步看
目标:读懂课件右下的两张小图,再对照路由动画,看权重怎样从平均变成集中。
-
课件右下:k = 1 时 v 落在一堆散乱的 û 中间;k > 1 时点分成 3 团,每团里有一个输出 v。红框结论:输出向量倾向于聚类输入向量。
图片来源:COMP5541 Lecture 9 课件, p.20 -
课件后面放了一段路由动画,共 10 帧:下层 20 个红色胶囊,上层 10 个蓝色胶囊。
-
第一帧每个下层胶囊和所有上层胶囊之间的线一样细,权重全部相等。
-
轮数增加,线开始有粗有细。到最后一帧,每个下层胶囊基本只剩一支粗箭头,指向一个上层胶囊。
-
上一节的手算也是同一个现象:û_3 的权重一路掉到 0.058,v 靠向 û_1、û_2 这一团。
| 动画帧 | 线的样子 | 权重 c |
|---|---|---|
| Routing: 0 | 所有连线一样细 | 全部相等 |
| 中间几帧 | 有粗有细 | 开始拉开 |
| Routing: 9 | 每个下层胶囊只剩一支粗箭头 | 集中到一个上层胶囊 |
怎么判断
看一个输入最后归哪个输出:比 b 或 c,谁大归谁。
意思是:路由跑完,c 大说明这个输入和那个输出方向一致。动画是按原论文的方向画的,每个下层胶囊在上层之间分配,所以最后能「挑出一个父亲」;课件公式在输入之间分配,读法是每个输出挑出一团输入。
常见误解
以为动态路由是在训练时学一组固定的 c
c 每来一个新样本都重算,不同的图片得到不同的 c。所以叫「动态」。
以为路由轮数越多越好
轮数多了 c 会越来越极端,接近只选一个,计算也更贵。原论文实验用 3 轮。
试一下
一个 û 和 v 方向正好相反,内积为负。它的 b 会怎样?
每轮 b 加上一个负数,越来越小,softmax 后 c 越来越接近 0。
3. 胶囊网络:把胶囊层叠起来
它解决什么问题
一层胶囊只能做一次「部件到整体」的推断。要从像素一路推到「这是数字 7」,需要先用卷积提底层特征,再叠几层胶囊,最后还得有办法训练整个网络。
从哪来(补充)
原论文的 CapsNet 是 Conv1 → PrimaryCaps → DigitCaps 三层,后面接 3 层全连接的重构解码器。重构损失只是辅助,主损失是 margin loss,课件只画了重构这一路。出处:arXiv: Dynamic Routing Between Capsules。
直觉
结构和前面的卷积自编码器同一个思路:编码器压缩,解码器还原,损失比较输入和输出。区别在编码器里:卷积之后接的是胶囊层,层与层之间用动态路由传信息,取代了 max-pooling。
一步一步看
目标:按课件结构图,从输入的数字 7 走到重构出来的 7,说出每一段做什么。
-
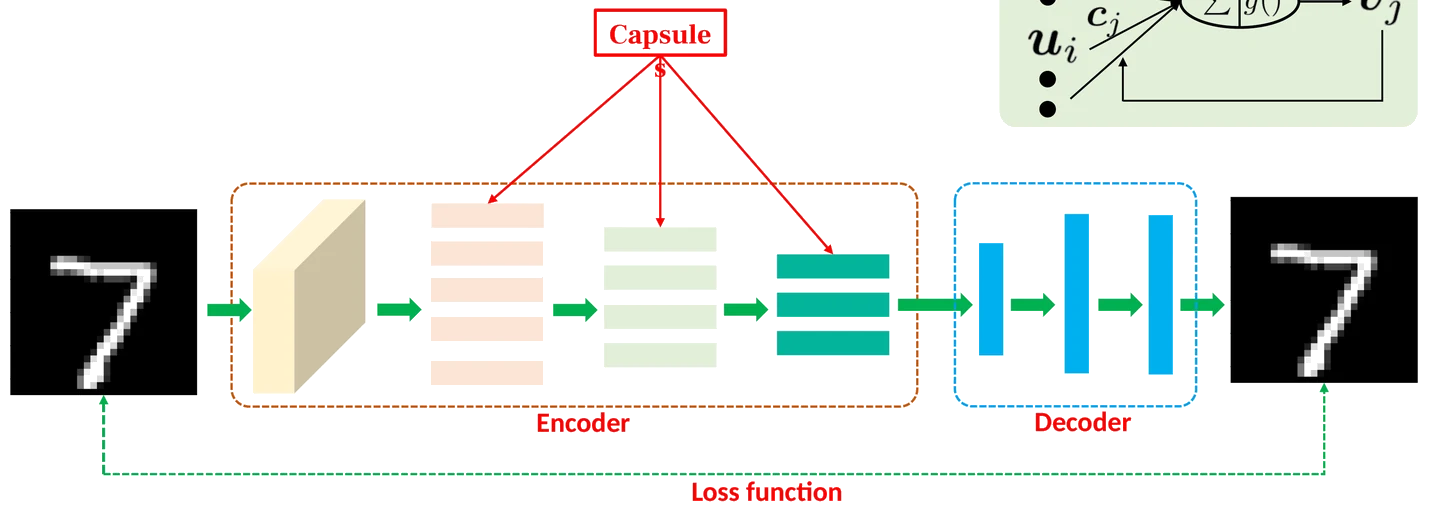
课件图:橙色虚线框是编码器,蓝色虚线框是解码器,绿色虚线连接输入和输出,标 Loss function。
图片来源:COMP5541 Lecture 9 课件, p.22 -
卷积块:从像素里提出底层特征。
-
三层胶囊:横条数 5 → 4 → 3 逐层变少,相邻两层之间做动态路由。
-
解码器:三层全连接,从最后一层胶囊的输出还原出图像。
-
损失:比较输入和重构出来的图,用重构误差训练。
怎么判断
问一个网络是不是胶囊网络,看层间怎么传信息:用向量输出,并且用动态路由分配权重,就是胶囊层。
意思是:卷积层和全连接层在胶囊网络里照样会用;区分点在中间那几层用 routing-by-agreement 代替了 max-pooling。
常见误解
以为胶囊网络完全不用卷积
课件图和原论文都在最前面放了卷积层,先从像素提底层特征,胶囊层接在它后面。
以为课件的重构损失就是原论文的全部训练目标
原论文主损失是 margin loss,重构损失只是辅助。课件只画了重构这一路。
试一下
课件胶囊网络和卷积自编码器最大的结构差别在哪?
编码器里卷积之后接的是胶囊层,层间用动态路由;卷积自编码器全是卷积层,靠步长下采样。
把它们串起来
动态路由回答了权重 c 怎么来:b 从 0 开始,每轮 softmax 得到 c,按上一页的加权和与 squash 算出 v,再把每个 û 和 v 的内积加到 b 上。和 v 方向一致的输入权重越来越大,跑偏的越来越小。
跑完几轮,输出落在一团意见一致的输入中间,所以课件说输出向量会「聚类」输入向量。
把一层卷积、几层胶囊、一个全连接解码器接起来,用重构误差训练,就是课件里的胶囊网络。它用路由代替 max-pooling,想保住部件和整体之间的相对位置。
课件里的坑
- [方向] 课件的 softmax 对固定的输出 j,在所有输入 i 之间做,c_1j + … + c_Ij = 1。原论文对固定的输入 i,在上一层所有胶囊 j 之间做,c_ij = exp(b_ij) / Σ_k exp(b_ik)。按论文,一个输入把自己的输出按比例分给各个上层胶囊;按课件,一个输出在各个输入之间分配。只有一个输出胶囊时,论文写法每个 c 恒为 1,路由不起作用,本页手算例子按课件写法。作答按课件写,知道论文写法即可。
- [方向] p.23 的路由动画按论文的方向画:每个下层胶囊最后只剩一支粗箭头指向一个上层胶囊,和 p.19 公式的方向不同。
- [排版] p.19 的 Compute the capsule agreement 几个字和公式叠在一起,不影响内容。
- [留白] p.27 Take-home 第 4 条 How to build a capsule network: stack multiple layers 后面是「???」,没写完。按 p.22:一层卷积提特征,叠几层胶囊层(层间动态路由),最后接全连接解码器重构输入。
- [简化] p.22 只画了重构损失,原论文主损失是 margin loss。
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写动态路由的四行算法;再手算一轮,从 b = 0 开始算出 c、s、v 和新的 b;最后用一句话回答「动态路由学到了什么」。
必背
- Step 4 动态路由:b 初始化为 0;每轮 c = softmax(b),算 s_j、v_j,再 b_ij ← b_ij + û_i · v_j;跑 K 轮后返回 v_j。
- 完整胶囊层:û_i = W_i u_i → s_j = Σ c_ij û_i → v_j = squash(s_j),c_ij 由动态路由求。
- 内积 û_i · v_j 大表示输入和输出方向一致(agreement),下一轮这个输入的权重 c 变大。
- 动态路由学到的:输出向量会「聚类」输入向量,k > 1 时 v 落在一团方向一致的 û 中间。
- 胶囊网络用 routing-by-agreement 代替 max-pooling 在层间传信息(p.25 Q2 选 D)。
- 课件的胶囊网络:卷积块 → 多层胶囊(层间动态路由)→ 全连接解码器重构输入,用重构误差训练。
课件例题
例 1(课件 p.19、p.20):写出完整的胶囊层算法
题面:按课件 Summary,写出从输入胶囊 u 到输出胶囊 v_j 的完整算法。
提示
先是线性变换,再是初始化,然后一个 For K iterations 的循环,最后返回。
解答
Linear Transformation:û_i = W_i u_i。Initialization:所有 b_ij = 0。For K iterations do:① c_·j = softmax(b_·j);② s_j = Σ_i c_ij û_i,v_j = squash(s_j);③ b_ij ← b_ij + û_i · v_j。Return v_j。
例 2(课件 p.20):What does dynamic routing learn??
题面:课件右下两张小图分别是 k = 1 和 k > 1。动态路由学到了什么?
提示
对比两张图里 v 的位置:一个在乱点中间,一个在各团中间。
解答
输出向量倾向于聚类输入向量。每轮和 v 方向一致的 û 拿到更大的 c,v 更靠向它们;几轮后每个 v 落在一团彼此一致的 û 中间,像簇中心。
例 3(课件 p.25 Q2):什么机制取代了 max-pooling
题面:In Capsule Neural Networks, what mechanism replaces traditional max-pooling operations to transmit information between layers? A. global average pooling;B. self-attention matrix multiplication;C. convolutional stride expansion;D. dynamic routing-by-agreement。
提示
这一讲的 Step 4 叫什么?
解答
D。原论文摘要写的就是用 routing-by-agreement 取代 max-pooling 的路由。A 和 C 仍是池化或下采样;B 是注意力机制。
例 4(课件 p.27):capsule layer 怎么工作、capsule network 怎么搭
题面:Take-home 第 3、4 条:How does capsule layer work? How to build a capsule network(课件第 4 条写着 stack multiple layers ???)?
提示
第 3 条的关键词是 dynamic routing;第 4 条看课件的胶囊网络结构图。
解答
胶囊层:输入向量乘 W 得 û,按 c 加权求和得 s,squash 得 v,c 由动态路由一轮轮求出。胶囊网络:一层卷积提特征,后面叠几层胶囊层,层间做动态路由,最后接全连接解码器重构输入,用重构误差训练。
完整例题
自编情境。一个输出胶囊,两个输入 û_1 = (3, 0)、û_2 = (0, 1),按课件写法路由两轮。(a) 第 1 轮的 c、s、v。(b) 更新后的 b。(c) 第 2 轮的 c,并说明权重偏向谁。
- 第 1 轮 b = (0, 0),c = (0.5, 0.5),s = (1.5, 0.5)。
- ||s||² = 2.5,||s|| ≈ 1.581,系数 2.5 / 3.5 ≈ 0.714。
- v ≈ 0.714 × (1.5, 0.5) / 1.581 ≈ (0.677, 0.226)。
- 内积:û_1 · v ≈ 3 × 0.677 = 2.031,û_2 · v ≈ 0.226,b ≈ (2.031, 0.226)。
- 第 2 轮 c = softmax(b):e^2.031 ≈ 7.62,e^0.226 ≈ 1.25,c ≈ (0.859, 0.141)。
答案:(a) c = (0.5, 0.5),s = (1.5, 0.5),v ≈ (0.677, 0.226);(b) b ≈ (2.031, 0.226);(c) c ≈ (0.859, 0.141),偏向更长、和 v 更一致的 û_1。
要点:内积同时受方向和长度影响,长的 û 更容易拿到大权重。
答题格式:每轮按 b → c → s → v → 内积 → 新 b 的顺序列表,保留三位小数。
变式题(先自己做)
(1) 改编自课件 p.19:一个输出胶囊有 4 个输入,第 1 轮每个 c 是多少? (2) 改编自课件 p.19:按原论文写法,只有一个上层胶囊时 c 是多少?路由还有没有作用? (3) 自编情境:b = (2, 2, 0),c 是多少?(e² ≈ 7.389)
提示
(1) b 全是 0。(2) 原论文对每个输入 i 在上层胶囊之间做 softmax。(3) 直接代 softmax。
判分点与答案(非官方评分标准)
判分点:① 初始 b = 0 时 c 平分;② 分清课件和论文的 softmax 方向;③ softmax 算对。
- (1) 1/4 = 0.25。
- (2) 每个 c 恒为 1,权重不随轮数变,路由不起作用。
- (3) 分母 7.389 × 2 + 1 = 15.778,c ≈ (0.468, 0.468, 0.063)。
闪卡自测
1. 动态路由的初始化?
所有 b_ij = 0(p.19)。
2. 每轮第一步?
c = softmax(b)(p.19)。
3. b 怎么更新?
b_ij ← b_ij + û_i · v_j,内积累加(p.19)。
4. agreement 指什么?
û_i 和 v_j 的内积,越大越一致(p.19)。
5. 第 1 轮的 c 是多少?
b 全 0,每个 c 都是 1/I(I 是输入个数)。
6. 动态路由学到了什么?
输出向量倾向于聚类输入向量(p.20)。
7. 课件和原论文的 softmax 方向差在哪?
课件对固定的 j 在输入 i 之间做;论文对固定的 i 在上层胶囊 j 之间做。
8. 原论文路由几轮?
3 轮。
9. 胶囊网络用什么代替 max-pooling?
dynamic routing-by-agreement(p.25 Q2)。
10. 课件胶囊网络的结构?
卷积块 → 三层胶囊 → 全连接解码器,用重构误差训练(p.22)。
下一讲
这一讲到这里结束。下一讲是无监督学习的第二部分,讲 VAE 和 GANs;整门课的笔记都在 课程首页,复习时可以按讲次回看。
下一讲的通俗笔记上完课会补,先回 COMP5541 课程页。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。