L09c 胶囊层:向量进、向量出,变换、加权和与 squash
胶囊把一个神经元的单个数换成一个向量:长度表示某个东西在不在,方向表示它长什么样。这一页按课件的前三步走:用矩阵 W 变换输入向量,按权重 c 加起来,再用 squash 把长度压进 0 和 1 之间,每一步都手算一遍。
一句话版
普通神经元收几个数、吐一个数。胶囊收几个向量、吐一个向量,向量的长度说「这个东西在不在」,方向说「它长什么样」。
胶囊层前三步:每个输入向量先乘一个可学的矩阵,再按权重加起来,最后用 squash 把长度压进 0 和 1 之间。权重怎么定是下一页的动态路由。
先认识这几个词
读之前最好会算向量的长度和矩阵乘向量。
| 词 | 写法 | 一句人话 |
|---|---|---|
| 胶囊 | capsule | 输出一个向量的「神经元」 |
| 输入胶囊 u_i | 第 i 个输入向量 | 下一层送上来的向量 |
| 变换矩阵 W | 可学的参数 | 把 u 变成 û 的矩阵 |
| û_i | 变换后的输入 | 第 i 个输入对输出的「预测」 |
| 耦合系数 c_ij | coupling coefficient | 第 i 个输入在加权和里占多少 |
| s_j | 加权和 | 所有 û 按 c 加起来的向量 |
| squash | 挤压函数 | 方向不变,把长度压到 0 和 1 之间 |
| 输出胶囊 v_j | 第 j 个输出向量 | squash 之后的结果 |
一个类比:几位目击者描述同一辆车
一位目击者只说「看到车了,八成把握」,这是一个数,像神经元。另一位说「看到一辆车,往东开,红色,八成把握」,这是一组数,像胶囊:把握程度对应向量长度,往哪开、什么颜色对应方向。
几位目击者各自的说法先换算到同一个地图坐标上(Step 1 的 W),再按每人的可信度加权汇总(Step 2 的 c),最后把汇总的把握程度压成 0 到 1 之间(Step 3 的 squash)。
类比在哪里失效:
- 目击者的话要人去理解。胶囊的向量只是几个数,每一维代表什么没有人规定,是训练学出来的。
- 换算坐标用的是固定规则。W 是可学的参数,训练前它也不知道怎么换算。
- 可信度通常事先知道。c 是在算的过程中由输出反过来调出来的,下一页会算。
从零讲起
1. 神经元和胶囊:从一个数到一个向量
它解决什么问题
CNN 里一个神经元只输出一个数,表示某个特征强不强。max-pooling 再在一块区域里只留最大的那个数,「鼻子在哪、朝哪个方向」这类位置关系就丢了。于是 CNN 不容易判断鼻子、嘴相对脸的位置对不对。胶囊想把这些信息留下来。
从哪来(补充)
胶囊网络和动态路由出自 Sara Sabour、Nicholas Frosst、Geoffrey E. Hinton 的 Dynamic Routing Between Capsules,发表于 NIPS 2017。摘要里写:胶囊是一组神经元,活动向量的长度表示实体存在的概率,方向表示实体的参数。出处:arXiv: Dynamic Routing Between Capsules。
直觉
把一个数换成一个向量,相当于一个单元同时报告两件事。长度回答「有没有」,方向回答「是什么样」:位置、角度、粗细都可以塞进方向里。
鼻子转了个角度,表示鼻子的那个胶囊长度不变,方向跟着转。上一层看方向就知道鼻子和嘴的相对位置还对不对。
一步一步看
目标:对照课件的对比图,看清神经元和胶囊在输入、计算、输出三处的差别。
-
课件左边是神经元,右边是胶囊。下方的框里 g() 旁边打了一个红色问号,后面几页回答它。
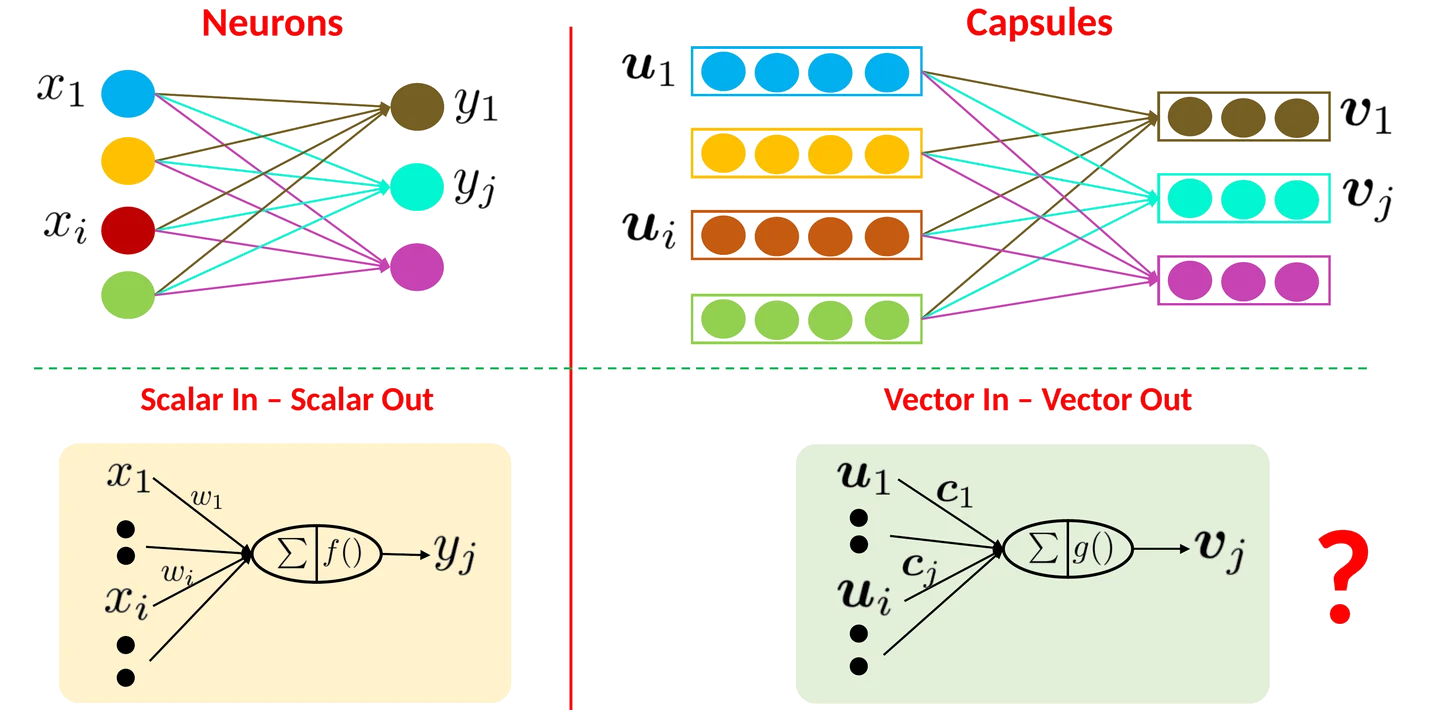
图片来源:COMP5541 Lecture 9 课件, p.15 -
输入:神经元收 4 个数 x;胶囊收 4 个向量 u,每个 4 维。
-
计算:神经元算 Σ w_i x_i 再过激活 f;胶囊先加权求和,再过 g。
-
输出:神经元出一个数 y;胶囊出一个 3 维向量 v,长度和方向各有含义。
| 神经元 | 胶囊 | |
|---|---|---|
| 输入 | 几个数 x | 几个向量 u |
| 计算 | f(Σ w_i x_i) | g(Σ c_ij û_i) |
| 输出 | 一个数 | 一个向量 |
| 输出的含义 | 特征强不强 | 长度:在不在;方向:什么样 |
怎么判断
长度:||v|| 在 0 和 1 之间,读成「这个实体出现的概率」。方向:v / ||v||,读成「实体的参数」。
意思是:判断「有没有」只看长度,判断「是什么样」只看方向。这种读法出自原论文摘要,课件正文只说 squash 把长度压到 0 和 1 之间。
常见误解
以为胶囊就是把几个神经元的输出排成一列,没有新东西
形式上确实是几个数排成向量,新东西在用法:长度和方向分工表示「在不在」和「什么样」,层与层之间按向量的一致程度分配权重(下一页的动态路由)。
以为向量越长代表实体越大
长度表示实体出现的概率,和大小无关。大小如果要表示,会落在方向里的某几维。
试一下
两个胶囊输出 v = (0.6, 0) 和 v' = (0, 0.6),它们代表的实体出现概率谁大?
一样大,长度都是 0.6。两者方向不同,说明实体的参数(比如角度)不同。
2. Step 1:用矩阵 W 变换输入向量
它解决什么问题
输入胶囊 u 是低一层的部件,比如「鼻子」。上一层的胶囊是整体,比如「脸」。要从鼻子的位置推出脸应该在哪,需要一次换算,这次换算就是乘一个矩阵 W。换算后的 û 才能和别的部件的预测放在一起比较、相加。
直觉
每个 W 记住一条「部件到整体」的关系:鼻子在这儿、朝这个方向,那么脸应该在那儿、朝那个方向。W 是可学的,训练会把这些关系学出来。
一步一步看
目标:用一个 3×4 的 W 把 4 维 u 变成 3 维 û,并算出共享和不共享各要多少参数。
-
课件的两条要求:变换后向量维数一致;变换要带可学的参数。左下是不共享(每对 i、j 一个 w_ij),右下是课件简化后的共享版(每个输入一个 w_i)。
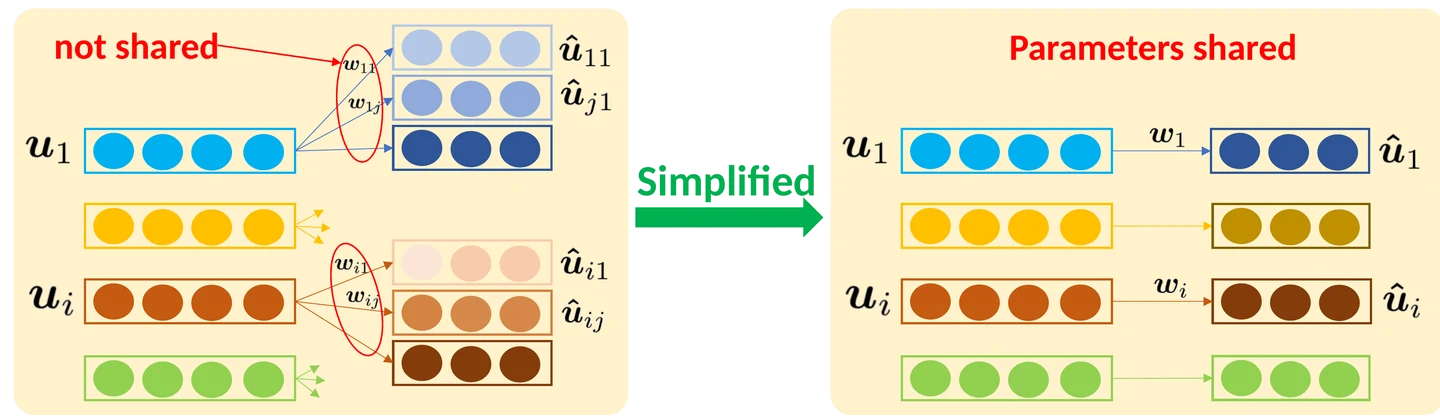
图片来源:COMP5541 Lecture 9 课件, p.17 -
取 u = (1, 0, 2, 1),W 三行是 (1, 0, 0, 1)、(0, 1, 1, 0)、(1, 1, 0, 0)。
-
每一行和 u 对应相乘再加:1·1 + 1·1 = 2,0 + 2 = 2,1 + 0 = 1,所以 û = (2, 2, 1)。
-
参数量:一个 W 有 3 × 4 = 12 个数。4 个输入、3 个输出,不共享要 12 个 W,共 144 个数;共享只要 4 个 W,共 48 个数。
怎么算
不共享:û_j|i = W_ij u_i;课件简化的共享版:û_i = W_i u_i
意思是:不共享时,输入 i 对每个输出 j 各做一次预测,用各自的 W_ij;共享时一个输入只做一次变换,所有输出共用。原论文用的是不共享的 W_ij。
W 的形状是「输出胶囊维数 × 输入胶囊维数」。课件图里输入 4 维、输出 3 维,所以 W 是 3×4。
常见误解
以为「Keep the vector dimension the same」是指 û 和 u 维数一样
课件图里 u 是 4 维、û 是 3 维,明显变了。合理读法是:所有 û 维数相同,并且和输出胶囊 v 一样,这样下一步才能相加。
以为共享参数是胶囊网络的标准做法
课件图上箭头写着 Simplified,是为了讲课简化。原论文每一对(输入 i,输出 j)都有自己的 W_ij。
试一下
同一个 W,u 换成 (0, 1, 0, 1),û 是多少?
第一行 0 + 1 = 1,第二行 1 + 0 = 1,第三行 0 + 1 = 1,û = (1, 1, 1)。
3. Step 2 加权和、Step 3 squash
它解决什么问题
每个输入都给出了一个预测 û,输出胶囊要把它们汇总成一个向量,这是 Step 2。汇总出的 s 长度可能是 5,也可能是 0.3,没法直接当概率读,Step 3 要把长度压进 0 和 1 之间,同时不改方向。
直觉
加权和就是投票:每个 û 按自己的权重 c 投一票,加起来得到 s。
squash 像一个软开关:s 很长时压到接近 1,很短时压到接近 0,中间平滑过渡。方向原封不动,所以「实体是什么样」的信息不受影响。
一步一步看
目标:手算 s = (3, 4) 和 s = (0.3, 0.4) 两个向量的 squash,看长短向量各被压成多少。
-
课件这一页:Step 2 是 s_j = Σ c_ij û_i,c_ij 被红框圈着打了问号;Step 3 是 squash 公式。底部红框写 How to compute C_ij? 答案是 Dynamic routing,下一页讲。
-
取 s = (3, 4),长度 √(9 + 16) = 5,远大于 1。
-
长度系数 25 / 26 ≈ 0.9615,单位方向 (0.6, 0.8),v ≈ (0.577, 0.769)。
-
换成短向量 s = (0.3, 0.4),长度 0.5,系数 0.25 / 1.25 = 0.2,v = (0.12, 0.16),长度只剩 0.2。
-
把系数画成长度的函数,就是一条从 0 升起、越来越贴近 1 的曲线。
| 输入长度 ‖s‖ | 0.5 | 1 | 2 | 5 |
|---|---|---|---|---|
| 输出长度 ‖v‖ | 0.2 | 0.5 | 0.8 | 0.9615 |
怎么算
Step 2:s_j = Σ_i c_ij û_i
Step 3:v_j = ||s_j||² / (1 + ||s_j||²) · s_j / ||s_j||
意思是:后半截 s_j / ||s_j|| 是长度为 1 的方向,前半截是新长度。新长度只由旧长度 n 决定,等于 n² / (1 + n²),n 越大越接近 1,永远到不了 1;n 接近 0 时它比 n 本身还小得多。
常见误解
以为 squash 就是把向量除以自己的长度(归一化成长度 1)
除以长度后所有向量长度都是 1,「在不在」的信息就没了。squash 保留长短的差别,只是压进 0 和 1 之间:长度 5 变成约 0.96,长度 0.5 变成 0.2。
以为 c_ij 和普通神经元的权重 w 一样,靠反向传播学
W 靠反向传播学;c_ij 不是参数,每次前向计算时由动态路由现算出来。
试一下
s = (0, 2),squash 后 v 是多少?
长度 2,系数 4 / 5 = 0.8,方向 (0, 1),v = (0, 0.8)。
把它们串起来
胶囊把神经元的一个数换成一个向量,长度表示实体在不在,方向表示实体什么样。这样部件的位置、角度能往上传,max-pooling 丢掉的东西保住了。
一层胶囊的前三步:每个输入向量 u 乘一个可学的矩阵 W,得到对输出的预测 û;所有 û 按权重 c 加起来得到 s;squash 不改方向,把 s 的长度压进 0 和 1 之间,得到输出 v。
剩下的问题是权重 c 怎么来。课件在 squash 那一页的红框里已经给了答案:动态路由,下一页一轮一轮地算。
课件里的坑
- [矛盾] p.17 写 Keep the vector dimension the same,图里 u 是 4 维、û 是 3 维。按「所有 û 维数相同、并且和输出 v 相同」理解,下一步才能相加。
- [记号] p.17 下标不统一:u_1 一行写 û_11、û_j1,u_i 一行写 û_i1、û_ij。读的时候统一成「输入 i 对输出 j 的预测」就行。
- [简化] p.17 右下的 Parameters shared 是课件简化,原论文每一对(i, j)都有自己的 W_ij。
- [排版] p.18 右图标签写成「Squash(」,少了右括号,p.20 同样。
- [留白] 长度表示「实体出现的概率」这句课件正文没写,只出现在 p.26 Q3 的选项里,出自原论文摘要。
课后 10 分钟:考点复习
这 10 分钟怎么用:先说出神经元和胶囊在输入、输出上的差别;再默写三步公式;最后手算一次 squash,长短各一个向量。
必背
- 神经元:标量进、标量出,y = f(Σ w_i x_i);胶囊:向量进、向量出(Vector In – Vector Out)。
- 胶囊输出向量的长度表示它代表的实体出现的概率,方向表示实体的参数(p.26 Q3 选 D)。
- Step 1:用可学的矩阵变换输入向量,û_i = W_i u_i;变换后的 û 维数相同。
- Step 2:加权和 s_j = Σ c_ij û_i;权重 c_ij 由 Step 4 动态路由给出。
- Step 3:squash,v_j = ||s_j||² / (1 + ||s_j||²) · s_j / ||s_j||,方向不变,长度压到 0 和 1 之间。
- 胶囊网络想解决 CNN 难以表示部件和整体相对关系的问题(p.26 Q4 选 D)。
课件例题
例 1(课件 p.15):g() 和权重是什么
题面:p.15 的胶囊示意图里,u_1 … u_i 带权 c 进 Σ,再过 g() 得到 v_j,旁边一个红色问号。g() 是什么函数?权重 c 怎么来?
提示
往后翻到 p.18,Step 3 和底部红框各回答一半。
解答
g() 是 squash:方向不变,把长度压到 0 和 1 之间。权重 c 由动态路由求出(p.19 的 Step 4)。p.21 重复这张图时问号去掉了。
例 2(课件 p.18):squash 做了什么、c_ij 怎么求
题面:写出 squash 公式并说明它保留什么、改变什么;回答底部红框的 How to compute C_ij?
提示
公式拆成两半:一半是方向,一半是长度。
解答
v_j = ||s_j||² / (1 + ||s_j||²) · s_j / ||s_j||。保留方向 s_j / ||s_j||,把长度从 ||s_j|| 改成 ||s_j||² / (1 + ||s_j||²),落在 0 和 1 之间。c_ij 用动态路由求:b 从 0 开始,每轮 c = softmax(b),按 v 和 û 的内积更新 b。
例 3(课件 p.26 Q3):胶囊向量的长度表示什么
题面:What does the length (norm) of a capsule’s vector output represent? A. reconstruction loss gradient magnitude;B. total input channels;C. spatial scale / bounding box;D. the estimated probability that the entity represented by the capsule is present in the image。
提示
squash 把长度压到 0 和 1 之间,什么量天然在这个范围里?
解答
D。长度表示实体出现的概率,方向表示实体的参数。A、B 和胶囊输出无关;C 这类空间信息放在方向里,不在长度里。
例 4(课件 p.26 Q4):胶囊网络要解决 CNN 的什么问题
题面:Which major limitation of CNNs do Capsule Networks aim to solve regarding spatial hierarchies? A. excessive memory;B. cannot process colour channels;C. no fully-connected output layers;D. inability to properly model part-whole relationships (e.g., nose and mouth relative to a face) invariant to viewpoint changes。
提示
题干说 spatial hierarchies,想想 max-pooling 丢了什么。
解答
D。max-pooling 只留「有没有」,丢了部件之间的相对位置。胶囊用向量记位置、方向,用 W 学部件到整体的关系;原论文讨论部分说这种关系与视角无关,能推广到新视角。A、B、C 都不是 CNN 的结构性问题。
完整例题
自编情境。一个输出胶囊 j 有两个输入,变换后 û_1 = (2, 0)、û_2 = (0, 2),权重 c_1j = 0.75、c_2j = 0.25。(a) 算 s_j。(b) 算 v_j 和它的长度。(c) 如果两个权重都是 0.5,v_j 的长度变大还是变小?
- s_j = 0.75 × (2, 0) + 0.25 × (0, 2) = (1.5, 0.5)。
- ||s_j||² = 2.25 + 0.25 = 2.5,||s_j|| ≈ 1.581。
- 系数 2.5 / 3.5 ≈ 0.714,这就是 v_j 的长度。
- v_j ≈ 0.714 × (1.5, 0.5) / 1.581 ≈ (0.677, 0.226)。
- 权重都是 0.5 时 s_j = (1, 1),||s_j||² = 2,长度系数 2 / 3 ≈ 0.667,比 0.714 小。
答案:(a) (1.5, 0.5);(b) v ≈ (0.677, 0.226),长度约 0.714;(c) 变小,约 0.667。
要点:两个方向不同的 û 平均分配时互相抵消一部分,s 变短;权重偏向一方时 s 更长,输出胶囊更「确信」。
答题格式:先写 s,再写 ||s||²,再写系数,最后写 v;每步保留三位小数。
变式题(先自己做)
(1) 改编自课件 p.17:输入胶囊 8 维、输出胶囊 16 维,一个 W 有多少个数? (2) 改编自课件 p.18:s 的长度是 3,squash 后 v 的长度是多少? (3) 自编情境:要让 v 的长度正好是 0.5,s 的长度应该是多少?
提示
(1) W 的形状是「输出维数 × 输入维数」。(2) 代 n² / (1 + n²)。(3) 解 n² / (1 + n²) = 0.5。
判分点与答案(非官方评分标准)
判分点:① W 形状写对;② squash 只用长度算系数;③ 方程解对。
- (1) W 是 16 × 8,共 128 个数。
- (2) 9 / 10 = 0.9。
- (3) n² = 1 + n² 的一半,n² = 1,n = 1。
闪卡自测
1. 神经元和胶囊的输入输出各是什么?
神经元标量进、标量出;胶囊向量进、向量出(p.15)。
2. 胶囊输出向量的长度表示什么?
它代表的实体出现的概率(p.26 Q3)。
3. 方向表示什么?
实体的参数,比如位置、角度。
4. Step 1 做什么?
用可学的矩阵 W 变换输入向量,û_i = W_i u_i(p.17)。
5. 课件的共享参数和原论文有什么不同?
课件简化成每个输入一个 W_i;原论文每对 (i, j) 一个 W_ij(p.17)。
6. Step 2 的公式?
s_j = Σ c_ij û_i(p.18)。
7. squash 公式?
v_j = ||s_j||² / (1 + ||s_j||²) · s_j / ||s_j||(p.18)。
8. squash 改变什么、保留什么?
保留方向,把长度压到 0 和 1 之间(p.18)。
9. ||s|| = 1 时 v 的长度?
1 / 2 = 0.5。
10. c_ij 怎么求?
动态路由(p.18 红框,p.19 Step 4)。
11. 胶囊网络想解决 CNN 的什么问题?
难以表示部件和整体的相对关系,而且这种关系要不随视角变(p.26 Q4)。
下一讲
下一页 L09d 讲 Step 4 动态路由:b 从 0 开始,一轮一轮更新权重 c,再看几层胶囊怎么叠成胶囊网络。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。