L01b KNN 分类:量距离,问最近的几个邻居
从零讲清两点之间的距离怎么算、KNN 分类的四步怎么走、K 取多少会改变答案。
一句话版
KNN 不总结规律。来一个新样本,就在旧样本里找离它最近的 K 个,看它们是什么,照着报。
上一页 L01a 说过,KNN 是课里唯一的非参数模型。这一页讲它怎么做分类。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| KNN | K-Nearest Neighbors,K 近邻 | 找 K 个最像的老样本,看它们的答案来猜新样本 |
| 特征 | feature | 描述一个样本的数字,比如面积、楼龄 |
| 特征空间 | feature space | 把每个样本的特征当坐标画出来的空间 |
| 距离度量 | distance metric | 算两个样本「差多远」的公式,由使用者自己定 |
| 分类 | classification | 输出一个类别,比如 cat 或 dog |
| 投票 | majority vote | 数一数 K 个邻居里哪个标签最多,就报哪个 |
| N、K | 两个字母 | N 是训练样本总数,K 是每次挑出来参考的邻居个数 |
一个类比:刚搬家,问最近的三户邻居
刚搬进一个小区,想知道楼下哪家早餐店好吃。你不去研究口味规律,直接敲开离你家最近的三户门问。两户说东门那家,一户说西门那家,你就去东门。
这就是 KNN 分类的全部动作。「最近」要先定义:按楼层算,还是按门牌号算?定法不同,问到的人就不同。问几户就是 K。人少了容易碰上口味古怪的,人多了会问到隔壁楼去。
类比在哪里失效:
- 你只问三户就完事。最基础的 KNN 要先把全小区每一户的距离都算一遍、排好序,再挑最近的 K 户。
- 人能凭常识判断「楼层近」比「门牌号近」更有意义。算法只认你写下的那条距离公式,公式荒唐它也照算。
- 邻居的答案带着各自的理由。KNN 拿到的只有标签本身,它不知道邻居为什么这么答。
从零讲起
1. 先补一块:两点之间的距离(补充)
它解决什么问题
KNN 的每一步都绕着「谁离谁近」转。要回答这个问题,得先把「近」变成一个能算的数。
一个样本有几个特征,就可以看成几维空间里的一个点。两个样本像不像,就变成两个点离得远不远。这一节讲两种最常用的量法。
从哪来(补充)
我们熟悉的直线距离叫欧氏距离(Euclidean distance),来自勾股定理。距离公式最早由 Alexis Clairaut 在 1731 年发表,后来 Cauchy 把它推广到三维以上。出处:Wikipedia: Euclidean distance。
另一种叫曼哈顿距离,也叫 taxicab、city block 或 L1 距离。Karl Menger 在 1952 年的一本小册子里给它起了 taxicab 这个名字。出处:Wikipedia: Taxicab geometry。
直觉
从家到超市,鸟飞过去走的是直线,这是欧氏距离。人在棋盘一样的街区里只能横着走、竖着走,走的是横向和纵向路程之和,这是曼哈顿距离。
两种量法都合理,只是回答的问题不一样。KNN 用哪一种,由使用者决定。
一步一步看
目标:用横差 3、纵差 4 的两点分别算欧氏距离和曼哈顿距离,再推到四维,看两种距离怎么算、差在哪。
-
在平面上画两个点 P 和 Q。从 P 到 Q,横向差 3,纵向差 4。
-
欧氏距离走斜边。横向差和纵向差是直角三角形的两条直角边,斜边长 √(3² + 4²) = √25 = 5。
-
曼哈顿距离沿着格子走,先横后竖,路程是 3 + 4 = 7。
-
换到四维,做法不变。下表是点
[5,5,5,5]和[0,3,3,3]逐维相减的结果:维度 第 1 维 第 2 维 第 3 维 第 4 维 差 5 2 2 2 差的平方 25 4 4 4 -
欧氏距离是平方加起来再开根号,√37 约为 6.08。曼哈顿距离是差直接加起来,等于 11。
怎么算
两个点 p = (p₁, p₂, …, pₙ) 和 q = (q₁, q₂, …, qₙ):
欧氏距离 d(p, q) = √((p₁ − q₁)² + (p₂ − q₂)² + … + (pₙ − qₙ)²)
意思是:每一维各自相减,平方,全部加起来,最后开根号。二维时就是勾股定理,斜边² = 直角边² + 直角边²;多一维就多加一项平方。
曼哈顿距离 d(p, q) = |p₁ − q₁| + |p₂ − q₂| + … + |pₙ − qₙ|
意思是:每一维各自相减取绝对值,直接加起来,不平方也不开根号。
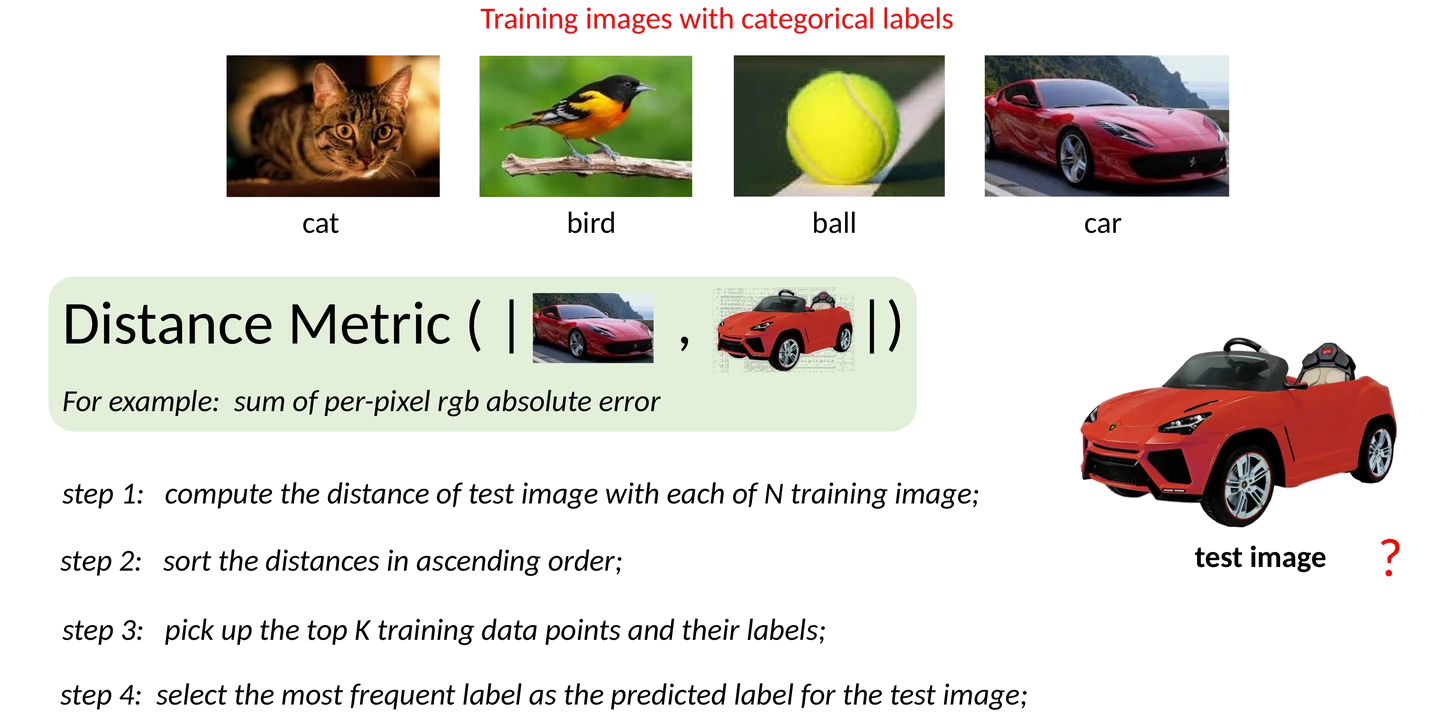
课件的图片分类例子里,距离是「逐像素 RGB 绝对误差之和」:每个像素的红、绿、蓝三个值各自相减取绝对值,再全部加起来。按上面的定义,这就是曼哈顿距离(L1),只是维度很多,每个像素占三维。
常见误解
以为 KNN 只能用欧氏距离
课件原话是 Distance Metric; You define it!。欧氏、曼哈顿都可以,图片例子用的就是曼哈顿。定法不同,挑出来的邻居可能不同,答案也可能不同。
开根号可以省掉,所以欧氏距离和平方和是一回事
只比大小、挑最近的点时,省掉开根号不改变排序,可以这么偷懒。要报出距离的具体数值时,不能省。
试一下
点 (1, 1) 和点 (4, 5) 的欧氏距离和曼哈顿距离各是多少?
横向差 3,纵向差 4。欧氏距离 √(9 + 16) = √25 = 5,曼哈顿距离 3 + 4 = 7。
2. KNN 分类的四步
它解决什么问题
手里有一堆带标签的老样本,来了一个没有标签的新样本,怎么给它猜一个标签?KNN 的回答很直接:看离它最近的几个老样本是什么,就猜什么。
它背后的假设是课件原话 The nearest data points in feature space have similar properties:特征空间里离得近的点性质相似。
从哪来(补充)
KNN 的做法由 Evelyn Fix 和 Joseph Hodges 在 1951 年提出,后来 Thomas Cover 做了扩展,他和 Hart 在 1967 年发表了论文 Nearest neighbor pattern classification。出处:Wikipedia: k-nearest neighbors algorithm。
直觉
KNN 没有训练这一步,或者说训练就是把数据存下来。所有功夫都花在预测时:每来一个新样本,都要和全部 N 个老样本比一遍。
所以 KNN 定性是三条:非参数模型、监督学习方法、分类和回归都能做。这一页讲分类,回归在 L01c。
一步一步看
目标:用五个训练点和 K = 3 走完算距离、排序、取近邻、投票四步,看测试点为什么判成 cat。
平面上有 5 个训练点:A、C、E 是 dog,B、D 是 cat。测试点「?」在 (4, 4),取 K = 3。
-
算距离:测试点到全部 5 个训练点各算一次欧氏距离。
-
排序:把 5 个距离从小到大排好。
-
取前 K 个:K = 3,取排在最前面的 B、D、A,连同它们的标签。
-
投票:三个邻居里 cat 两票、dog 一票,预测 cat。
怎么算
把四步写成一行:
预测标签 = K 个最近邻居的标签里出现次数最多的那个
意思是:先用距离把全部训练点排队,只看排在最前面的 K 个,再在这 K 个里数票。上面的例子里,邻居是 B、D、A,标签是 cat、cat、dog,cat 有 2 票,所以预测 = cat。
预测一次要算多少个距离?训练集有 N 个点,就要算 N 次距离,再排一次序。课件给的朴素实现每次都这么做,所以 KNN 训练开销约等于零,代价全压在预测时。
做回归时,前三步一字不改,只把第 4 步的「数票」换成「取平均」,见 L01c。
常见误解
以为 KNN 有一个训练阶段在学东西
KNN 没有训练出来的参数。它的「模型」就是那份被完整存下来的训练集,所以它是非参数模型。
以为每次预测只用看 K 个点
最后投票只看 K 个,但为了知道哪 K 个最近,第 1 步要和全部 N 个点各算一次距离。课件的朴素实现就是这样。
试一下
同样五个点,把 K 改成 1,预测什么?
只看最近的 B,B 是 cat,预测 cat。
3. K 取多少
它解决什么问题
K 是 KNN 里唯一要人拍板的数。它不从数据里学,由使用者选定,所以叫超参数。K 取不同的值,同一个测试点可能得到不同的答案。
从哪来(补充)
二分类时取奇数 K 可以避免票数打平,这是 KNN 的通行做法。出处:Wikipedia: k-nearest neighbors algorithm。
直觉
问邻居这件事,问一户太冒险,碰上口味怪的就全错。问全小区等于没问,只是在数哪家店的粉丝多,跟你住哪儿没关系了。合适的 K 落在中间。
一步一步看
目标:让 K 从 1 加到 5 重新数票,看偶数 K 会平票,K 取满后测试点在哪里已经不起作用。
还用上一节的五个点,排好序是 B cat 1、D cat 2、A dog 3、E dog 4.24、C dog 5。
-
K 从 1 往上加,每次多取一个邻居,重新数票:
K 取到的邻居 票数 预测 1 B cat 1 cat 2 B、D cat 2 cat 3 B、D、A cat 2 : dog 1 cat 4 B、D、A、E cat 2 : dog 2 平票 5 全部 cat 2 : dog 3 dog -
K = 4 时两类各两票,没法决定。这就是偶数 K 在二分类里的麻烦。
-
K = 5 时把所有点都取了,预测变成「训练集里哪类多就报哪类」,测试点在哪里已经不起作用。
怎么判断
选 K 时问三句:
- 数据里噪声多不多?多的话 K 不能太小,否则一个标错的点就能带偏结果。
- K 会不会大到把远处不相关的点也拉进来?K 一直加到 N,就退化成数整体多数。
- 是不是二分类?是的话优先取奇数,避开平票。
常见误解
以为偶数 K 一定平票
偶数 K 只是可能平票。上表里 K = 2 时两个邻居都是 cat,没有平票;K = 4 才平。
以为 K 越大越稳
K 大了确实不容易被单个噪声点带偏,但远处的点也会混进来。极端情况 K = N,测试点的位置完全不起作用。
试一下
一个三分类问题,K = 3,三个邻居分别是 cat、dog、bird。会发生什么?
三类各一票,平票。奇数 K 只能保证二分类不平票,类别多了仍可能打平,要另定规则,比如选最近那个邻居的标签。
把它们串起来
KNN 的定性有三条:非参数、监督学习、分类回归都能做。它没有训练出来的参数,整个训练集就是模型。
整条链从一个假设出发:特征空间里离得近的点性质相似。有了这个假设,就必须先定义「近」,所以距离度量是关键步骤,而且只能由使用者来定。欧氏距离走直线,曼哈顿距离沿格子走,课件的图片例子用的是后者。
距离定好以后,四步里前三步全是机械动作:算距离、排序、取前 K 个。第 4 步数票。K 由人选,它决定数谁的票,K 变了答案可能就变。
课件里的坑
- [课件留白] p.49 的图片例子只给了四张训练图和距离定义,没有具体像素值,这题考的是步骤顺序,不考算数
- [补充] p.49 的四步是朴素暴力搜索。「每次遍历全部 N 点」是这个实现的性质,实际的库会用 KD-tree、Ball-tree 等索引加速。答题按课件写,但别把它当成算法的固有下限
- [补充] p.55 的 demo 取 K = 2,二分类出现平票,代码靠排序顺序隐式打破平局,这不是有意设计的规则
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写欧氏距离和曼哈顿距离的公式,再默写 KNN 四步。然后把下面的「完整例题」盖住答案自己算一遍,再做「变式题」。最后回查两个最容易错的地方:以为 K 是从数据里学出来的、以为偶数 K 一定平票。
必背
- KNN 是非参数、监督、可做分类也可做回归的方法;核心假设是特征空间中相邻的点性质相似。
- KNN 四步:算距离 → 距离升序排序 → 取前 K 个点及其标签 → 汇总;分类取最频繁的标签(投票),回归取 K 个邻居标签的均值或加权均值,只差第 4 步。
- 欧氏距离是各维差的平方和再开根号,曼哈顿距离(L1)是各维差的绝对值之和;逐像素 RGB 绝对误差之和就是 L1 距离。
- KNN 的关键步骤是距离度量的选择,它由使用者定义(Distance Metric; You define it!),距离决定了谁算邻居。
- K 是使用者选定的超参数:K 太小对噪声敏感,K 太大会把远处不相关的点拉进来;二分类取偶数 K 可能平票,所以习惯取奇数。
课件例题
例 1(课件 p.49):用四步给一张测试图分类
题面:训练集是四张带标签的图,分别是 cat、bird、ball、car,共 N = 4 张。来了一张测试图。两张图的距离定义为逐像素 RGB 绝对误差之和,也就是每个像素的红绿蓝三个值各自相减取绝对值,再全部加起来。按 KNN 的四步写出分类过程。
提示
不用真的算像素。按「算距离、排序、取前 K、投票」四步依次写,每步说清对谁做、做几次。
解答
- step 1:用给定的距离公式,算测试图和四张训练图各自的距离,一共算 4 次。
- step 2:把这 4 个距离从小到大排序。
- step 3:取排在最前面的 K 张训练图,连同它们的标签。
- step 4:数这 K 个标签里哪个出现最多,作为预测结果。K = 1 时就是离得最近那张图的标签。
- 要点:课件没有给具体的像素值,这题考的是步骤顺序和「每预测一张都要和全部 N 张比一遍」。这个距离是 L1 距离,逐维差的绝对值之和。
例 2(课件 p.55 demo):四点小题,K 取 1、2、3
见下方完整例题。
完整例题
题面:训练集四个点:[2,2,2,2]→cat、[4,4,4,4]→dog、[1,2,1,1]→cat、[0,3,3,3]→dog。测试点 [5,5,5,5],欧氏距离。K = 1、K = 2、K = 3 分别预测什么?
约定:欧氏距离 = 各维差的平方和再开根号;平票时如实写平票,不自己补规则。
解法:
- 到
[4,4,4,4]:四维各差 1,√(1+1+1+1) = 2,标签 dog。 - 到
[2,2,2,2]:四维各差 3,√(9+9+9+9) = √36 = 6,标签 cat。 - 到
[0,3,3,3]:差 5、2、2、2,√(25+4+4+4) = √37 ≈ 6.08,标签 dog。 - 到
[1,2,1,1]:差 4、3、4、4,√(16+9+16+16) = √57 ≈ 7.55,标签 cat。 - 升序排序:dog(2) < cat(6) < dog(6.08) < cat(7.55)。
- K = 1:只看 dog(2),预测 dog。
- K = 2:取前两个,dog、cat,票数 1:1 打平。demo 代码靠排序的稳定性隐式选了排在前面的 dog,这不是有意设计的规则。
- K = 3:取前三个,dog、cat、dog,票数 2:1,预测 dog。
要点:K = 2 的平票正好暴露偶数 K 在二分类里的问题,所以实践中习惯取奇数 K。
答题格式:先列出四个距离及其标签,再写升序排序,最后对每个 K 写出取到的邻居、票数和预测。
变式题(先自己做)
改编自课件 p.55。同样四个训练点,把测试点换成 [1,1,1,1],仍用欧氏距离。
(1) K = 1、K = 2、K = 3 分别预测什么? (2) K 加到 4 会发生什么?
提示
四个距离重算一遍,排序时留意这次的顺序和例题不一样。第二问不用算,回头看排序里两类各有几个。
判分点与答案(非官方评分标准)
判分点:① 展示四个距离及排序;② 三个 K 值要分别作答;③ 第二问要答出平票,并说出「偶数 K 不一定平票,但 K 加到 N 就退化成整体多数类」。
- 到
[1,2,1,1]:差 0、1、0、0,√1 = 1,cat。 - 到
[2,2,2,2]:四维各差 1,√4 = 2,cat。 - 到
[0,3,3,3]:差 1、2、2、2,√13 ≈ 3.61,dog。 - 到
[4,4,4,4]:四维各差 3,√36 = 6,dog。 - 升序:cat(1) < cat(2) < dog(3.61) < dog(6)。
- K = 1 → cat;K = 2 → cat、cat,预测 cat,这次没有平票;K = 3 → cat、cat、dog,票数 2:1,预测 cat。
- K = 4 → cat、cat、dog、dog,2:2 平票。对比例题:偶数 K 只是可能平票;K 一直加到训练集规模 N,投票就退化成「训练集里哪类多选哪类」,测试点的位置完全不起作用了。
闪卡自测
1. KNN 的三条定性是什么?
非参数模型、监督学习方法、分类和回归都能做(p.48)。
2. 写出 KNN 分类的四个步骤。
算距离(和全部 N 个训练点) → 距离升序排序 → 取前 K 个点及其标签 → 投票取最频繁的标签(p.49)。
3. 欧氏距离和曼哈顿距离怎么算?课件图片例子用的是哪一种?
欧氏:各维差的平方和开根号。曼哈顿:各维差的绝对值之和。课件的逐像素 RGB 绝对误差之和是曼哈顿距离,也叫 L1 距离(p.49)。
4. KNN 的核心假设是什么?
特征空间里离得近的点性质相似,课件原话 The nearest data points in feature space have similar properties(p.48)。
5. KNN 的关键步骤是哪一步?为什么是它?
距离度量的选择。排序、取前 K、投票都是机械动作,唯独距离由使用者定义,课件原话是 Distance Metric; You define it!,它决定了谁算邻居,也就决定了全部结果(p.50、p.52)。
6. K 取得过小和过大分别有什么问题?二分类时为什么建议 K 取奇数?
K 太小对噪声敏感,K 太大会把远处不相关的点也拉进来(p.52)。K 取偶数时二分类可能出现票数打平,demo 里 K = 2 就打成了 1:1,只能靠排序顺序隐式决定,所以习惯取奇数(p.55)。
7. KNN 的训练时间和预测时间各是什么量级?和线性回归相比是怎样的对照?
KNN 训练开销约等于零(只是把数据存下来),预测时要和全部 N 个训练点各算一次距离。线性回归正好相反,训练要做优化、预测只是代入公式(p.43、p.49)。
下一讲
下一页 L01c KNN 回归与局限:标签从类别换成数值,第 4 步怎么改;特征尺度为什么必须先统一;KNN 的四问怎么答。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。