L01a 机器学习的地图:学习、推断、参数与非参数
从零讲清机器学习的两个阶段、三层坐标,以及参数模型和非参数模型的分界。
一句话版
机器学习让程序自己从带答案的例子里总结规则。总结出来的东西要么压成几个数字,要么干脆就是那堆例子本身。
这一页是整门课的地图。后面的 KNN 讲在 L01b 和 L01c。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 机器学习 | Machine Learning,缩写 ML | 不手写规则,让程序从带答案的例子里自己总结规则 |
| 标签 | label | 一条数据的标准答案,比如「这张图是 cat」 |
| 模型 | model | 学完之后留下来、能拿去做预测的那个程序 |
| 学习 / 推断 | Learning / Inferring | 先看数据攒本事,再拿本事回答没见过的新问题 |
| 范式 | paradigm | 按「数据带着什么样的答案」给方法分的大类 |
| 参数 | parameter | 模型里靠数据学出来的那几个数,比如直线的斜率和截距 |
| N | 一个字母 | 训练样本的总条数 |
一个类比:两家卖二手房的中介
小区门口开着两家中介。
A 家的老板信公式。成交记录他全看过,看完只留下一张纸条:单价约等于 a×地段分 + b×面积 + c×楼龄。客户来问价,他量三个指标,代入,报数。原始记录早扔了。
B 家的老板信记录。每一笔成交都抄进一本厚簿子,一条不删。客户来问,他把簿子里的记录逐条和眼前这套比一遍「像不像」,挑出最像的三套,取成交价的平均数报出去。他从不总结规律,全部本事就是这本簿子。
两家都在做机器学习。看记录、攒本事的那段时间叫学习(Learning)。客户上门、当场报价的那一下叫推断(Inferring)。两家的区别只在本事存在哪里:A 存在三个系数里,B 存在整本簿子里。
顺着这个场景还能看清两件事。A 的纸条上永远是三个系数,喂多少条记录都一样,这叫参数模型(parametric)。B 的簿子越记越厚,模型大小跟着数据量涨,这叫非参数模型(non-parametric)。另外,A 报价快、B 报价慢,因为 B 每接一单都要把整本簿子翻一遍。
类比在哪里失效:
- 真中介翻簿子会先按小区缩小范围。最基础的 KNN 不走捷径,每次预测都和全部 N 条记录各比一次。
- 两个中介都有成交价可看,所以都属于有标准答案的那一类学习。地图上还有没有答案、只有奖励的学习,这个场景装不下。
- A 的纸条形式是老板自己先定的,换个形式就是换了模型。真实的参数模型也一样,函数的形状由人选,数据只负责把系数填上。
从零讲起
1. 学习与推断:学的是一个函数
它解决什么问题
写程序的老办法是人把规则一条条写死。认猫这种事,规则写不出来:猫有各种颜色、姿势和角度,没人能列全。
机器学习换了个做法。人只负责准备一堆带答案的例子,程序自己从例子里总结规则,再拿规则去回答新问题。这里要分清两个阶段,否则后面每一讲都会把「训练」和「预测」混在一起。
从哪来(补充)
「机器学习」这个词出现得很早。1959 年,IBM 的员工 Arthur Samuel 提出了 machine learning 这个说法。出处:Wikipedia: Machine learning。
直觉
学习阶段像备考:把带答案的练习题做一遍,总结出解题方法。推断阶段像上考场:拿到一道没见过的题,用总结出的方法作答。
总结出来的方法就是模型。它本质上是一个函数:塞进去一张图,吐出来一个词。课件写的是 f(图片) = “Cat”、g(音频) = “Hello”。
一步一步看
目标:用房价例子走一遍学习和推断,看出学完只留下 w 和 b,推断只靠这条直线。
拿最简单的例子走一遍:用房子的面积预测成交价,模型是一条直线。
-
学习之前,手里只有四套带标签的房子。横坐标是特征(面积),纵坐标是标签(成交价)。
-
学习:先选定「模型是一条直线」,再在所有直线里挑最贴近这四个点的那一条。灰线是没被选中的候选,青绿线是选中的。
-
推断:来了一套没见过的房子,量出面积,在直线上读出对应的价格,就是预测。
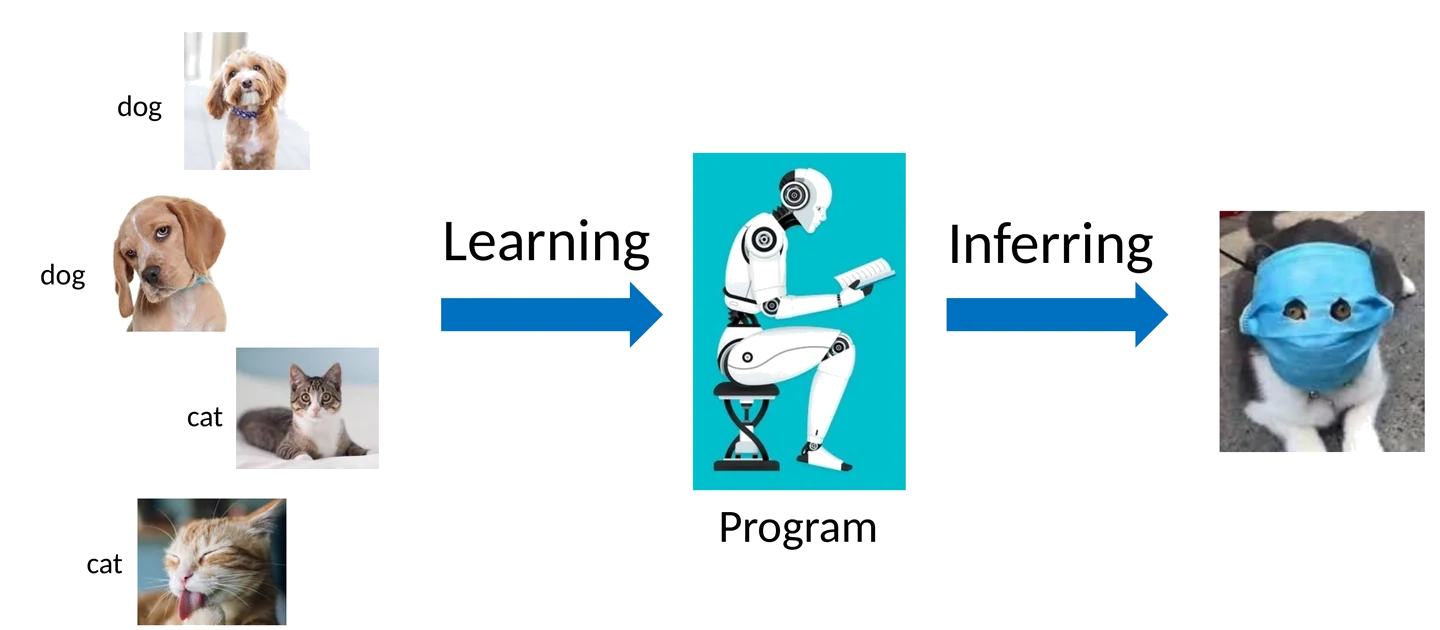
课件用的是图片分类的版本,结构完全一样:
| 阶段 | 输入 | 输出 | 别名 |
|---|---|---|---|
| Learning | 带标签的训练数据 | 一个模型 | training、fitting |
| Inferring | 没见过的样本 | 预测标签 | inference、prediction、testing |
怎么算
上面那条直线写成公式:
y = w·x + b
意思是:拿到面积 x,先乘一个系数 w,再加一个常数 b,得到的 y 就是预测价格。w 管「面积每多一点,价格涨多少」,b 管整体抬高或压低多少。
两个阶段在公式上的分工:
- 学习阶段:x 和 y 都是已知的(训练数据),未知的是 w 和 b,要从数据里求出来。
- 推断阶段:w 和 b 已经求好、固定不动,只有新的 x 是新给的,代入就得到 y。
同一个公式,两个阶段里「谁已知、谁未知」正好倒过来。后面每一讲换的只是 f 的形状:线性回归里是直线,神经网络里是一层套一层的计算。
常见误解
拿训练集上的准确率当成绩
模型见过这些数据,答对不说明它学会了规律,可能只是背下来了。评估泛化能力,要用没参与训练、也没参与挑选模型的数据。
以为 testing 和 inference 是一回事
课件把 testing 列成 Inferring 的别名。更严格的说法是:inference 指运行模型产生预测,用在训练数据上也可以;testing 指拿预测结果去打分的评估环节。
试一下
手机相册自动把照片按人脸分组,你给其中一组标上「妈妈」,之后新拍的照片也自动认出妈妈。哪一步是学习,哪一步是推断?
根据已有的照片(加上你给的名字)调整识别模型,是学习。新照片拍完、模型判断「这是妈妈」,是推断。推断时模型本身不变。
2. 三层坐标:范式、任务、算法
它解决什么问题
机器学习的方法名目很多。第一次看到一个新方法,很难说清它和别的方法是什么关系。课件给了一张三层地图,任何方法都能在上面找到位置,以后学到新算法就往格子里放。
从哪来(补充)
三种范式在教科书里有标准说法。监督学习是「老师」给出示例输入和期望输出;无监督学习不给标签,让算法自己在输入里找结构;强化学习是程序和一个动态环境交互,按得到的奖励调整行为。出处:Wikipedia: Machine learning。
直觉
三层各问一个问题。
- 范式(Paradigm)问:你拿到的数据带着什么样的答案?
- 任务(Tasks)问:你要输出什么?类别、数值,还是分组?
- 算法(Algorithms)问:你用什么工具去做?
三层互相独立。同一个工具可以出现在不同范式里,就像同一把螺丝刀能修桌子也能修椅子。
一步一步看
目标:按范式、任务、算法三层依次给问题定位,看出算法这一层不决定范式。
-
看数据带的答案,先定范式。判断只看一个问题:监督信号是什么形式。
-
再看要输出什么,定任务。输出类别是分类,输出连续数值是回归,没有答案只想分组是聚类。
-
最后选工具,定算法。课件把三层填成下面这张表:
Paradigm Tasks Algorithms Supervised Learning Classification、Regression KNN, linear models, DNNs … Semi/Unsupervised Learning Clustering、Semi-sup Learning、Generative Model K-means, PCA, DNNs … Reinforcement Learning 课件留空,L12 展开 -
注意 DNNs(深度神经网络)在监督和无监督两栏里都出现了。算法这一层不决定范式。
怎么判断
拿到一个场景,按顺序问三句:
- 数据有没有答案?答案全不全?是标签还是奖励?这一句定范式。
- 要的输出是类别、数值,还是分组?这一句定任务。
- 用的是什么方法?这一句定算法,它和前两句无关。
常见误解
按算法难度或数据量划分范式
范式只看监督信号的形式。标签齐全是监督,没有标签是无监督,部分有标签是半监督,只有延迟奖励是强化学习。数据多少、算法多复杂,都不改变范式。
以为神经网络只能做监督学习
同一个神经网络配上标签就是监督学习,配上「把输入原样还原」的目标就是自编码器(autoencoder),属于无监督。算法和范式是两个独立维度。
试一下
一个下棋程序自己和自己下,只在每盘结束时知道输赢。它属于哪个范式?
强化学习。它没有每一步的正确答案,只有一盘下完才拿到的输赢信号,这是延迟奖励。
3. 参数模型与非参数模型
它解决什么问题
数据变多时,模型要不要跟着变大?这个问题决定了训练要花多少力气、预测要花多少时间、要存多少东西。课件用它把模型分成两类:参数模型(Parametric)和非参数模型(Non-parametric)。
从哪来(补充)
统计学里对非参数模型的定义是:模型的结构不事先指定,由数据决定;参数个数是灵活的,模型规模通常随数据增长。k-NN 就是常举的例子。出处:Wikipedia: Nonparametric statistics。
直觉
回到两家中介。A 家只留一张纸条,纸条上永远是三个系数,这是参数模型。B 家留整本簿子,成交越多簿子越厚,这是非参数模型。
课件说非参数模型有「无限个参数」。这句话的意思是参数个数没有上限,会随数据一起涨,不是真的有无穷多个数。
一步一步看
目标:给两类模型各喂小数据和大数据,看参数模型的参数个数不变,非参数模型存的东西跟着变多。
-
给两类模型各喂一份小数据,再各喂一份大数据,看模型框的大小。
-
参数模型那一栏:数据多了,w 和 b 的值学得更准,个数不变。
-
非参数模型那一栏:数据多了,存下来的东西直接变多。
-
把两类模型的代价摆在一起(线性模型对朴素 KNN):
Parametric Non-parametric 训练开销 大,要做优化 约等于零,只是存下来 预测开销 小,代入公式 大,要和全部训练点比距离 存储 只存参数 存整个训练集 假设强度 强,先设定了函数形态 弱,不预设形态
怎么判断
问一句:把训练数据翻一倍,模型要存的东西会不会跟着变多?
- 不会,个数在看到数据之前就定死了:参数模型。课件的例子是 Linear Regression、PCA(主成分分析,一种压缩数据维度的方法)、NN(神经网络)。
- 会,模型规模随数据涨:非参数模型。课件的例子是 KNN、Gaussian Processes(高斯过程)。
常见误解
以为 K 就是 KNN 的参数
K 是超参数,由人选定,不从数据里学。KNN 真正的「模型」是那份被完整存下来的训练集。
把代价表推广到所有非参数方法
上面的表只是线性模型和朴素 KNN 的对比。高斯过程也是非参数模型,它就有不小的训练开销。
试一下
一个模型把每个类别所有训练样本的平均值存下来,预测时看新样本离哪个平均值最近。类别个数固定为 3。它更像参数模型还是非参数模型?
更像参数模型。不管训练数据有多少条,它只存 3 个平均值,存的东西不随数据量增长。
把它们串起来
这一页只做一件事:给出机器学习的坐标系,再把「训练到底在训练什么」讲清楚。
起点是两个阶段。学习阶段把数据变成模型,推断阶段用模型回答新问题,模型就是一个函数。后面所有内容都在回答同一个问题:这个函数长什么样、怎么从数据里得到它。
坐标系是三层加一刀。横着看是范式、任务、算法三层:范式看监督信号,任务看输出,算法是工具。竖着再切一刀,分成参数模型和非参数模型。参数模型先定好函数的形状,训练只是把几个系数调准;非参数模型不定形状,数据本身就是模型。
KNN 在这张地图上位置特殊:它是全课唯一一个非参数模型,后面讲的几乎全是参数模型。线性回归在调 w 和 b,KNN 只是把数据存下来。下一页就从 KNN 开始。
课件里的坑
本讲这部分课件未发现错误。有几处是有意留白,需要自己补上:
- [课件留白] p.42 的 Reinforcement Learning 一行 Tasks 与 Algorithms 两栏都是空的,留到 L12 展开
- [课件留白] p.43 只给了 finite / infinite set of parameters 这个定义,没解释 infinite 指什么,答题时要翻译成「模型复杂度随数据量增长」
- [补充] p.40 的表把 testing 列成 Inferring 的别名。严格说 inference 是运行模型产生预测,也可以用在训练数据上;testing 是评估过程,评估泛化时才要求用没参与训练的数据
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三样:Learning 与 Inferring 的输入输出、Paradigm / Tasks / Algorithms 三层坐标、参数与非参数的代价对照表。再把下面的「变式题」做一遍。最后回查两个最容易错的地方:以为 K 是 KNN 的参数、按算法难度划分范式。
必背
- Learning 的输入是带标签的训练数据、输出是一个模型,别名 training / fitting;Inferring 的输入是没见过的样本、输出是预测标签,别名 testing / prediction。
- ML 的三层坐标是 Paradigm(范式)/ Tasks(任务)/ Algorithms(算法);三个范式是 Supervised、Semi/Unsupervised、Reinforcement。
- 划分范式的依据是监督信号的形式,不按算法难度也不按数据量;同一个 DNN 在监督与无监督两栏里都出现。
- Parametric 是有限个参数(Linear Regression、PCA、NN),Non-parametric 是参数集合无界(KNN、Gaussian Processes),实质区别是模型复杂度是否随数据量增长。
- 参数模型的参数维数预先固定;非参数模型的复杂度可随数据增长,KNN 保留训练数据;KNN 训练开销约等于零,预测时要和全部 N 个训练点各算一次距离(课件给的朴素实现)。
课件例题
本讲课件没有例题出现在这一部分:p.40–43 只有回路图、地图表和参数 / 非参数的定义表。本讲的例题都在 KNN 部分(p.49–55),见 L01b 和 L01c。这部分一般出概念选择题和判断题,典型问法是「下面哪个是非参数模型」「划分监督与无监督的依据是什么」「DNN 只能用于监督学习,对还是错」,下面的完整例题就是这种题型。
完整例题
题面(自编情境,按本部分课件的考法出):判断下面四个说法的对错,错的改正。
(a) 只要训练数据量足够大,任何问题都应该归为监督学习。 (b) 线性回归喂 100 万条数据时,要学的参数比喂 100 条时多。 (c) KNN 里的 K 是它从数据里学出来的参数。 (d) 同一个深度神经网络既可以用在监督学习里,也可以用在无监督学习里。
解法:
- 先找每一句考的是哪张表。(a) 考范式的划分依据,(b)(c) 考参数与非参数,(d) 考算法和范式的关系。
- (a) 错。划分范式只看监督信号的形式:数据有没有标签、标签全不全、是不是只有奖励。数据量多少不改变范式。改正:数据带完整标签才是监督学习。
- (b) 错。线性回归是参数模型,参数个数在看到数据之前就定死了,一维时就是
w和b两个。数据多了,参数的值会学得更准,个数不变。 - (c) 错。K 是超参数,由使用者选定。KNN 没有训练出来的参数,它的模型就是存下来的整个训练集,所以它是非参数模型。
- (d) 对。算法和范式是两个独立维度,课件地图上 DNNs 同时出现在监督和无监督两栏。配上标签是监督学习,配上重构输入的目标是自编码器。
要点:四句里只要出现「数据量」「算法难度」这类词来定范式,基本就是错的;出现「参数个数随数据变」,先问它是参数模型还是非参数模型。
答题格式:每句先写对或错,错的写一句理由,再写改正后的说法。
变式题(先自己做)
自编情境。给下面三个场景各判断:属于哪个范式、哪个任务,用到的模型是参数模型还是非参数模型。
(1) 用一万张带「猫 / 狗」标签的照片训练神经网络做识别。 (2) 一堆没有标签的客户消费记录,用 K-means 分成几组。 (3) 用 KNN 根据面积和楼龄估计二手房价格。
提示
先看数据带不带答案定范式,再看输出是类别、数值还是分组定任务,最后问「数据翻倍时模型要不要变大」定参数与否。K-means 学的是几个组中心的位置。
判分点与答案(非官方评分标准)
判分点:① 三个场景都要给出范式、任务、参数类型三项;② 范式的理由必须落在「有没有标签」;③ KNN 那一问要说出模型就是训练集。
- 监督学习,分类任务,神经网络是参数模型。
- 无监督学习,聚类任务。K-means 要学的是 K 个组中心,个数事先定好,按地图归在参数一侧。课件没有直接给 K-means 定性,这里按「参数个数是否随数据增长」的定义推断。
- 监督学习,回归任务,KNN 是非参数模型,数据越多它存的东西越多。
闪卡自测
1. Learning 和 Inferring 的输入输出分别是什么?为什么训练集上的准确率不能拿来评价模型?
Learning:输入训练数据(图 + 标签),输出一个程序 / 模型,别名 training、fitting。Inferring:输入一个没见过的样本,输出预测标签,常称 inference、prediction;testing 另指评估环节。inference 指运行模型生成预测,也可用于训练样本;评估泛化时才必须使用未参与训练和选择的数据(p.40)。
2. 课件说机器学习要学的是什么?
一个函数 f,比如 f(图片) = “Cat”、g(音频) = “Hello”。后面每一讲换的只是 f 的形态,学习就是在一个函数族里挑出最合适的那一个(p.41)。
3. 三层坐标是哪三层?为什么 DNNs 会同时出现在监督和无监督两栏里?
Paradigm(拿到什么数据)/ Tasks(要输出什么)/ Algorithms(用什么工具)。算法和范式是两个独立维度,同一个神经网络配上标签就是监督学习,配上重构目标就是自编码器(p.42)。
4. 划分监督 / 半监督 / 无监督 / 强化学习的依据是什么?
监督信号的形式:标签齐全是监督,部分有标签是半监督,没有标签是无监督,只有延迟的奖励信号是强化学习。不按算法难度、也不按数据量分(p.42)。
5. 地图上监督学习对应哪两个任务?无监督一栏列了哪几个任务?
监督:Classification、Regression。Semi/Unsupervised:Clustering、Semi-sup Learning、Generative Model。强化学习一行课件留空(p.42)。
6. 「非参数模型有无限个参数」该怎么理解?KNN 的「参数」到底是什么?
实际含义是模型复杂度不固定、随训练数据量增长。KNN 没有训练出来的参数,它把整个训练集背下来当模型本身,数据越多模型越大,所以参数集合无界(p.43)。
7. 各举两个 Parametric 和 Non-parametric 的例子。
Parametric:Linear Regression、PCA、NN。Non-parametric:KNN、Gaussian Processes(p.43)。
8. 参数模型和朴素 KNN 在训练开销、预测开销、存储、假设强度四项上怎么对照?
参数模型训练大、预测小、只存参数、假设强;朴素 KNN 训练约等于零、预测要和全部训练点比距离、存整个训练集、假设弱。这个对照不能推广到所有非参数方法,例如高斯过程也有训练开销(p.43)。
下一讲
下一页 L01b KNN 分类:地图上那个把整本簿子当模型的算法,先讲距离怎么算,再讲四步怎么走。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。