T07a 做一个论文检索工具(上):余弦相似度和先定死的检索设置
论文检索工具的前半程:查询和论文都变成向量,用余弦相似度排序;在写代码之前,先让 agent 画架构、问清检索设计,再把模型、编码时机、打分、条数、同分和空查询逐条写死。
一句话版
这节课用 vibe coding 从零做一个本地论文检索工具:输入一句话,后端把它和每篇论文都变成向量,按相似度排好序返回,你在网页上收藏论文、导出阅读清单。本页是前半程,讲排序靠的那个分数怎么算,以及写代码之前怎样把检索设置一条条定死。搭后端、做前端和写测试在下一页 T07b。
先认识这几个词
读之前最好先看过上一节 T06a,知道怎样给 agent 写清楚提示词。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 向量检索 | vector search | 把文字变成一串数字,按数字之间有多接近来找相关的东西 |
| 嵌入 | embedding | 模型把一段文字变成的那串数字,意思相近的文字,向量方向也相近 |
| 点积 | dot product | 两个向量对应位置相乘再相加得到的一个数 |
| 余弦相似度 | cosine similarity | 量两个向量方向有多一致的分数,1 是方向完全相同,0 是毫不相干 |
| L2 归一化 | 读作 L-two | 把向量按比例缩放到长度为 1,方向不变 |
| 双编码器 | dual encoder | 查询和论文各自单独编码成向量,再拿两个向量比 |
题目地图
| 顺序 | 题目 | 阶段 | 考什么 | 主要失分点 |
|---|---|---|---|---|
| 0 | 余弦相似度手算 | 原理 | 点积、长度、相除 | 忘了除以长度,只比点积 |
| 1 | 步骤 1:画出后端架构 | Set the goal | 目标、数据、环境、产出格式写全 | 没要求 agent 先等许可就让它改文件 |
| 2 | 步骤 2:问清检索设计 | Refine the plan | 列出还没定的决定 | 只问一句「怎么做」,漏掉同分和空查询 |
| 3 | 步骤 3:写死检索设置 | Refine the plan | 模型、编码时机、打分、条数、同分、空查询 | 写了点积却忘了先归一化 |
四道题是一条线。第 0 题先把排序靠的那个分数算明白,第 1 到 3 题是四个阶段里的前两个:先说清要做什么,再把还没定的设计逐项定下来。课件花在这两个阶段上的篇幅比写代码还多,理由写在步骤 2 那张表里:这些事在计划里改只是一句话,代码写完再改要动好几处。
概念卡
1. 余弦相似度:只看方向
人话定义:把查询和论文都看成从原点出发的箭头。余弦相似度量的是两支箭头的夹角有多小,夹角越小分数越接近 1,垂直时为 0,方向相反时为 −1。算法是两个向量的点积除以两者长度的乘积,除以长度这一步把箭头的长短抵消掉了。
例子:课件里查询是「Python 列表索引怎么工作」,记作 (1, 0)。讲列表索引的论文 A 是 (3, 4),讲课堂反馈的论文 B 是 (0, 1)。A 和查询的夹角小,算出 0.60;B 和查询垂直,算出 0.00。所以 A 排在前面。
常见误解
以为分数高是因为向量长 → 长短在公式里被除掉了。把 (3, 4) 放大成 (6, 8),方向没变,和查询的余弦还是 0.60。
试一下
查询 q = (1, 0),论文 C 的向量是 (0, 5)。C 和查询的余弦相似度是多少?
答案
0。点积 1 × 0 + 0 × 5 = 0,分子是 0,结果就是 0,和 C 有多长无关。C 与查询垂直,算毫不相关。
回讲义:L05a-1 无监督学习与距离
2. L2 归一化:点积和余弦变成一回事
人话定义:L2 归一化是把向量的每个数都除以它的长度,缩放成长度为 1 的向量,方向不变。两个向量长度都是 1 时,余弦公式的分母就是 1 × 1,只剩分子的点积。
例子:(3, 4) 的长度是 5,归一化后是 (0.6, 0.8)。它和 (1, 0) 的点积是 0.6,和直接算余弦得到的 0.60 一样。课件的设置里写「先归一化,再用点积打分」,验收表里写「按余弦分数排序」,说的是同一个数。
常见误解
以为点积和余弦随便换着用 → 只有两边都归一化过才相等。漏了归一化,长一点的论文向量会凭长度拿高分,排序就变了。
试一下
向量 (6, 8) 归一化以后是什么?
答案
长度是 √(36 + 64) = 10,每个数除以 10,得到 (0.6, 0.8),和 (3, 4) 归一化的结果一样。
回讲义:L05a-1 无监督学习与距离
3. 双编码器:查询和论文各编各的
人话定义:课件用的模型叫双编码器。两段文字各自送进同一个编码器,再经过池化压成一个向量,最后用余弦相似度比较这两个向量。查询走一边,论文文本走另一边,互相不用一起算。
例子:课件那张图来自 Sentence-BERT 论文:句子 A 和句子 B 分别过 BERT 和 pooling,得到 u 和 v,再算 cosine-sim(u, v)。放到这个工具里,句子 A 是你的查询,句子 B 是论文的标题加摘要。论文这一边和查询无关,所以可以在启动时提前算好、存起来,每次查询只编码查询那一句。
常见误解
以为每来一个查询都得把所有论文重新编码 → 双编码器的好处正好是论文向量能提前算。课件专门举了反例:每次搜索都重编全部 120 篇,每个查询就要多等 120 次编码。
试一下
用户连着搜了三次。按课件的设置,论文一共要编码几轮?
答案
一轮,在启动时。三次搜索各自只编码查询那一句,论文向量一直复用内存里那一份。
回讲义:L08f NCF 与 NeuMF
逐题拆解
课件给的材料包里有三样东西:一份说明、一份论文数据 data/papers.json、一张前端参考截图。论文数据有 120 篇英文论文,全是为实验造的,分 12 个主题、每个主题 10 篇。每篇有七个字段:paper_id、title、authors、year、abstract、topic、synthetic。
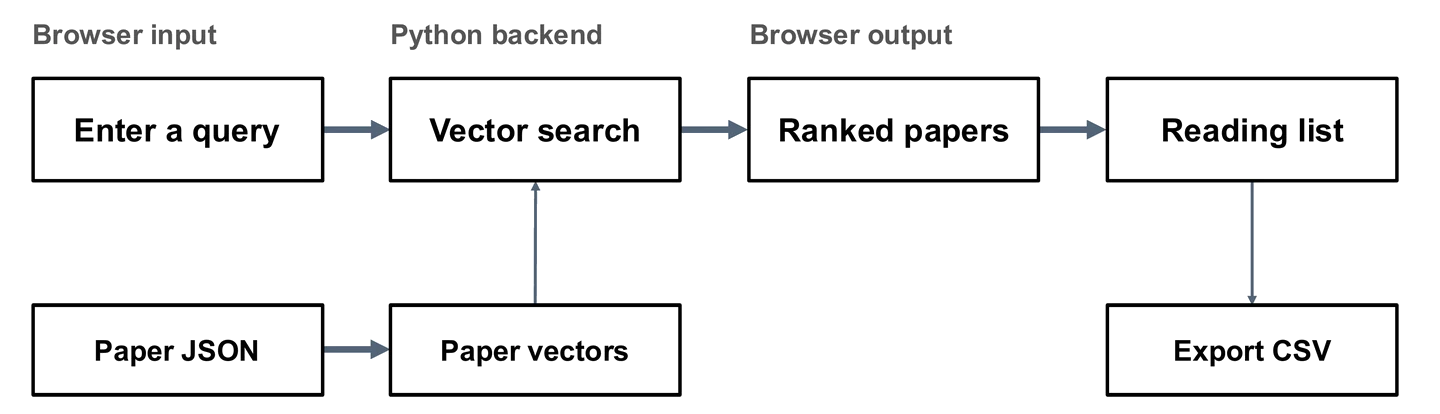
课件给出的简化版工具长这样:浏览器里输入查询,Python 后端做向量检索,论文数据先变成论文向量,结果回到浏览器排好序,收藏进阅读清单,最后导出 CSV。
先看全局:四个阶段
课件把整个开发过程分成四个阶段,后面六个步骤各属于其中一个,每页顶部都有一条进度条标出当前阶段。本页走前两个阶段,后两个在下一页。
一步一步看
目标:按顺序走一遍四个阶段,看每个阶段交出什么、对应后面哪几个步骤。
-
Set the goal:先说清要做什么、有什么限制,对应步骤 1。
-
Refine the plan:把还没定的检索设置逐项问清、逐项定下,对应步骤 2 和 3。
-
Build:照批准的计划写后端和前端,交出能跑的结果,对应步骤 4 和 5。
-
Test and revise:写测试拿证据,再根据结果回到前面改,对应步骤 6。
第 0 题:余弦相似度手算
查询 q = (1, 0)。论文 A「Python, List Indexing」的玩具向量是 (3, 4),论文 B「Classroom Feedback」是 (0, 1)。分别算出 q 和 A、q 和 B 的余弦相似度,并排序。
一步一步看
目标:按公式把分子、分母分开算,看清除以长度这一步怎样把向量长短抵消掉。
-
先算分子,也就是点积:对应位置相乘再相加。
-
再算分母:两个向量各自的长度相乘。
-
分子除以分母,得到 A 的分数。
-
同样算 B,再把两个分数比一比。
提示
公式是 cos(q, d) = (q · d) / (‖q‖₂ × ‖d‖₂)。‖(3, 4)‖ 用勾股定理算,3、4、5 是一组整数。
解答
cos(q, A) = (1 × 3 + 0 × 4) / (1 × 5) = 3 / 5 = 0.60。
cos(q, B) = (1 × 0 + 0 × 1) / (1 × 1) = 0.00。
A 排在 B 前面。课件特别说明这些是方便手算的玩具向量,真实演示用的是 120 篇论文、模型输出的长向量。
步骤 1:画出后端架构
这一步属于 Set the goal。你让 agent 先画一张后端草图,说清论文数据怎样经过嵌入流到检索接口,并且改文件前先等你点头。课件给的提示词是:
I'm building a local paper search tool with a reading list and CSV export.
I have 120 records in data/papers.json and will use Python 3.11 in .venv.
Sketch the backend. Show how paper data flows through embeddings to the search API.
Use one diagram and up to three bullets. Wait for my go-ahead before editing.
这段提示词把上一节学的几项都写到了。目标是本地检索加阅读清单加 CSV 导出,数据是那 120 条记录和文件路径,环境是 Python 3.11 和 .venv 虚拟环境。产出格式限成一张图加最多三条要点,最后一句要求先看方案再动手。
方法与验收:agent 交回的应该是一张数据流图,大意是论文数据 → 嵌入 → 检索接口,外加不超过三条要点。检查它有没有已经改了文件,改了就说明最后那句没起作用。
步骤 2:问清检索设计
这一步属于 Refine the plan。草图有了,可检索怎么做还没定。课件列了三个还没定的决定,以及 agent 自己拿主意时可能出的岔子:
| 还没定的决定 | agent 可能这样选 | 在演示里的后果 |
|---|---|---|
| 嵌入模型 | 选一个要 GPU 才能跑的模型 | 演示在 CPU 上起不来 |
| 论文向量 | 每次搜索都把 120 篇重新编码 | 每个查询都要多等 120 次编码 |
| 返回条数 | 每次把 120 篇全返回 | 你还得自己从 120 篇里翻 |
这些事在计划阶段改,只是改一句话;代码写完再改,要动好几处。所以课件让你先问 agent 要一份检索设计。快速版只有一句:
What design decisions do you need me to make before you start coding?具体版逐项点名:
Recommend a small embedding model that runs on CPU for these 120 papers
and tell me what text to embed. Tell me when to compute the paper vectors
and where to keep them. Suggest how to score and rank matches, how many
to return, and how to handle ties and blank queries.
Give me one recommendation for each decision.
提示
把具体版提示词按句拆开,每一句问的是哪一个决定?再和上面表格的三行对一对,看具体版多问了哪些。
解答
具体版问了八件事:用哪个模型(小、CPU 能跑),嵌入哪段文本,什么时候算论文向量,存在哪里,怎么打分,怎么排序,返回几条,同分和空查询怎么处理。表格里的三个决定(模型、论文向量、返回条数)都在里面,多出来的是嵌入文本、打分排序、同分、空查询。最后一句「每个决定只给一个推荐」让你拿到的是能直接拍板的答案,省得再从一堆选项里挑。
步骤 3:写死检索设置
还是 Refine the plan。拿到推荐以后,你把设置写成确定的几条交给 agent:
Use sentence-transformers/all-MiniLM-L6-v2 on CPU.
Batch-encode each title and abstract as one text at startup.
L2-normalize the paper vectors and keep them in memory.
Trim each query and return HTTP 400 if it is blank.
Encode it with the same model and normalize its vector.
Score every paper with a dot product.
Return up to 10 results by descending score, then by ascending paper_id for ties.
Update the backend plan with these settings. Wait for my approval.
翻成人话:模型用 all-MiniLM-L6-v2,在 CPU 上跑。启动时把每篇的标题和摘要拼成一段一起编码,归一化后放在内存里。查询先去掉首尾空格,空了就返回 HTTP 400;不空就用同一个模型编码、归一化,和每篇论文算点积。最多返回 10 条,分数从高到低,同分时 paper_id 小的在前。
一步一步看
目标:用四篇玩具论文走一遍打分、排序、同分、截断,看同分规则怎样让顺序固定下来。
这里用的是本页自编的玩具编号和向量,查询仍是 (1, 0),分数按余弦算。
-
每篇论文和查询各算一个分数。D02 和 D05 方向相同,分数一样。
-
按分数从高到低排。D03 第一,D04 最后,中间两篇同分,只靠分数分不出先后。
-
同分按 paper_id 升序,D02 排在 D05 前面。
-
最后截取前 10 条;如果查询去掉空格后是空的,直接返回 400,前面几步都不做。
方法与验收:agent 更新后的计划里,模型、嵌入文本、编码时机、存放位置、打分方式、返回条数、同分规则、空查询处理这几项都要写明,然后停下来等你批准。对照步骤 2 那张三行表格看:要 GPU 的模型、每次重编、全部返回这三个岔子都被堵上了。
课件里的坑
- [读图提醒] 课件封面写的是 Tutorial 2,它在本学期的 tutorial 材料里排第七份,本站记作 T07,分成 T07a、T07b 两页。课件右下角印的页码和实际页序一致。
- [读图提醒] p.9 的标题写「1. Draft the architecture」,顶部进度条高亮的是 Set the goal;p.10–12 属于 Refine the plan。步骤编号和阶段不是一一对应,一个阶段可以包含好几个步骤。
- [课件留白] p.12 写「Score every paper with a dot product」,p.15 写「by cosine score」。同一页已经要求把论文向量和查询向量都做 L2 归一化,所以两个说法是同一个分数;自己实现时漏掉归一化,两者就不等了。
- [课件留白] p.6 用的是二维玩具向量,页底也注明「方便手算」。真实模型输出的向量长得多,见下面的补充。
- [课件留白] 课件没写日期。本站按课件生成时间把它放在第 11 周,和上一节同一周,以课程公告为准。
- [补充] p.7 的图出自 Nils Reimers 和 Iryna Gurevych 2019 年的论文 Sentence-BERT。论文摘要写道:用 BERT 在 10,000 句话里找最相似的一对,约需 65 小时;SBERT 先把每句单独编码成向量再比余弦,缩到约 5 秒。这就是双编码器能提前算好论文向量的好处。出处:ACL Anthology
- [补充] p.12 选的 all-MiniLM-L6-v2 会把句子和段落映射成 384 维的向量。模型卡还写明,超过 256 个 word piece 的输入默认会被截掉,摘要很长时尾部不参与编码。出处:Hugging Face 模型卡
- [补充] 余弦相似度的取值范围是 −1 到 1,方向相同为 1、正交为 0、相反为 −1;两个向量都是单位长度时,它就等于点积。出处:Wikipedia: Cosine similarity
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,用自己的话说一遍:一个查询进来,后端怎样给 120 篇论文打分并排出前 10。然后用 3 分钟读必背 5 条,重点是第 2 条的公式关系和第 5 条的五个设置;中间 4 分钟默写完整例题;最后 3 分钟做变式题,先自己写再展开对照。
必背
- 余弦相似度 cos(q, d) = (q · d) / (‖q‖₂ × ‖d‖₂),只看两个向量的方向,取值在 −1 到 1 之间,越接近 1 越相似
- 向量做过 L2 归一化(长度变成 1)以后,点积就等于余弦相似度,所以课件前面写 dot product、后面写 cosine score 是同一个分数
- 双编码器把查询和论文文本各自经过同一个编码器和池化得到一个向量,再用余弦相似度比较两个向量
- 论文向量在启动时批量编码一次并留在内存,每次查询只编码查询本身;每次都重编全部论文会让每个查询多等全部论文的编码
- 检索设置要在计划阶段定死:CPU 上能跑的小模型、嵌入标题加摘要、最多返回 10 条、同分按 paper_id 升序、空查询返回 HTTP 400
完整例题
题面:查询向量 q = (1, 0)。四篇论文的向量是 D02 (6, 8)、D03 (4, 3)、D04 (0, 1)、D05 (3, 4)。按课件的检索设置(归一化后点积打分、分数降序、同分按 paper_id 升序)写出返回顺序和每篇的分数。
解法:
- 归一化:D02 长度 10 → (0.6, 0.8);D03 长度 5 → (0.8, 0.6);D04 长度 1 → (0, 1);D05 长度 5 → (0.6, 0.8)。q 长度本来就是 1。
- 打分:和 q 算点积,只剩第一个数。D02 = 0.6,D03 = 0.8,D04 = 0,D05 = 0.6。
- 按分数降序:D03 0.80 最高,D04 0.00 最低,D02 和 D05 都是 0.60。
- 同分处理:paper_id 升序,D02 在 D05 前。
- 结果:D03 0.80 → D02 0.60 → D05 0.60 → D04 0.00。只有 4 篇,不到 10 条的上限,全部返回。
自查:不归一化直接算点积,D02 会得 6、D05 得 3,D02 凭长度排到 D03 前面,这就是漏了归一化的后果。再看同分那两篇顺序是不是按编号定的。
答题格式:先写归一化后的向量,再逐篇写分数,最后一行写顺序,并注明同分用了哪条规则。
变式题(先自己做)
改编自课件 p.6、p.10、p.12。
(a) 查询 q = (3, 4),论文 d = (4, 3)。算 cos(q, d)。
(b) 有人把检索设置写成「每次搜索时把所有论文和查询一起编码,再用点积打分,返回全部结果」。按课件的设置,指出至少三处问题。
提示
(a) 两个向量长度都是 5。(b) 对照课件那张三行表格,再看设置里的「归一化」「最多 10 条」「同分」「空查询」。
判分点与答案(非官方评分标准)
判分点:① (a) 分子分母各自算对;② (b) 至少点出三处,每处说清后果。
(a) 点积 3 × 4 + 4 × 3 = 24,长度都是 5,cos = 24 / (5 × 5) = 24/25 = 0.96,方向很接近。
(b) 第一,每次搜索重编所有论文,每个查询都要多等全部论文的编码;应在启动时编码一次存进内存。第二,点积前没有归一化,长向量会凭长度拿高分,点积也就不等于余弦。第三,返回全部结果,用户还得自己从全部论文里翻;应最多返回 10 条。另外没写同分规则和空查询处理,顺序可能每次不同,空查询也没有被拒绝。
闪卡自测
1. 简化版工具从输入到导出经过哪几步?
浏览器输入查询 → Python 后端向量检索(论文 JSON 先变成论文向量)→ 浏览器显示排好序的论文 → 收藏进阅读清单 → 导出 CSV(p.4)。
2. p.6 里 A 和 B 的余弦相似度各是多少?
A:(1 × 3 + 0 × 4) / (1 × 5) = 0.60;B:(1 × 0 + 0 × 1) / (1 × 1) = 0.00(p.6)。
3. 双编码器的三个要点是什么?
两个输入(句子 A 是查询,句子 B 是论文文本);两个向量(编码器加池化,每个输入一个向量);一个相似度分数(用余弦比较两个向量)(p.7)。
4. 说出 vibe coding 四阶段和各自的产出。
Set the goal:目标和约束;Refine the plan:选项、反馈和决定;Build:改动和能跑的结果;Test and revise:证据和下一处修改(p.8)。
5. 步骤 1 的提示词交代了哪些信息?
目标(本地论文检索、阅读清单、CSV 导出)、数据(data/papers.json 里 120 条记录)、环境(Python 3.11、.venv)、产出格式(一张图加最多三条要点),以及改文件前先等许可(p.9)。
6. 课件说检索设置不定下来,agent 可能在哪三处出岔子?
选要 GPU 的模型,演示在 CPU 上起不来;每次搜索重编 120 篇,每个查询多等 120 次编码;每次返回全部 120 篇,还得自己翻(p.10)。
7. 课件写死的检索设置有哪些?
all-MiniLM-L6-v2 跑在 CPU;启动时把标题和摘要批量编码,L2 归一化后放内存;查询去空格,空就返回 HTTP 400,否则同一模型编码并归一化;点积打分;最多 10 条,分数降序,同分 paper_id 升序(p.12)。
8. 为什么设置里写点积,验收表里写余弦分数,两者却不矛盾?
设置要求论文向量和查询向量都做 L2 归一化,长度都是 1,余弦公式的分母变成 1,只剩点积(p.12、p.15)。
下一步
设置定好、计划批准以后,就进入 Build 和 Test and revise:搭后端接口、照截图做前端、写测试量 Recall@10,接着看 T07b。这一页的余弦相似度想往深里看,回 L09a 看「先检索再生成」怎样把这种向量检索接到大模型上。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。