L05a-1 无监督学习与距离:没有标准答案时,先说清什么叫「像」
从零讲无监督学习:标签拿掉以后还剩什么、两点之间的距离怎么算、为什么同一批点能分出好几种组,以及聚类算法交出来的两种结果:分组表和树。
一句话版
无监督学习手里只有数据、没有答案。聚类就是把「彼此像」的数据放进同一组,而「像」要先用一个距离公式说清楚,说法一换,分组就跟着变。
这一页从零讲四件事:标签拿掉后还剩什么,两点之间的距离怎么算,为什么同一批点能有好几种分法,聚类算法交出来的结果长什么样。具体的 K-means 算法放在下一页 L05a-2。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 标签 | label,记作 y | 每条数据配的「正确答案」,比如这套房是 house 还是 townhouse |
| 无监督学习 | unsupervised learning | 只有数据 x、没有标签 y 的学习 |
| 聚类 | clustering | 把像的数据放进同一组 |
| 簇 | cluster | 聚类分出来的一组 |
| 欧氏距离 | Euclidean distance | 两点之间拉一根直线量出来的长度 |
| ‖x − y‖²₂ | 读作「x 减 y 的二范数的平方」 | 欧氏距离再平方 |
| 平坦式 / 层次式 | flat (partition) / hierarchical | 一种交出分组表,一种交出一棵树 |
一个类比:给一抽屉没贴标签的照片分相册
你翻出一抽屉旧照片,没有一张写了日期或人名。你要把它们分成几本相册。
你可以按人分,也可以按地点分,还可以按年代分。三种分法都说得通,没有哪一种是「标准答案」。你得先决定「什么样的两张算像」,比如「同一个人出镜就算像」,分法才定得下来。
聚类就是在做这件事。照片是数据,「什么算像」就是距离公式,分出来的相册就是簇。
类比在哪里失效:
- 你看照片时会凭感觉换标准。算法不会,距离公式一旦定下,它就只按这个公式比远近。
- 相册分几本可以边分边改。不少聚类算法要求一开始就给定组数,K-means 就是这样。
从零讲起
1. 无监督学习:只有数据,没有答案
它解决什么问题
前几讲的回归和分类,每条数据都带着正确答案,算法照着答案学。可很多时候根本没人去标答案:网上的新闻每天几万篇,顾客的购物记录堆成山,没人逐条写上「这属于哪一类」。
无监督学习要回答:没有答案的时候,能不能从数据本身找出点结构来。
直觉
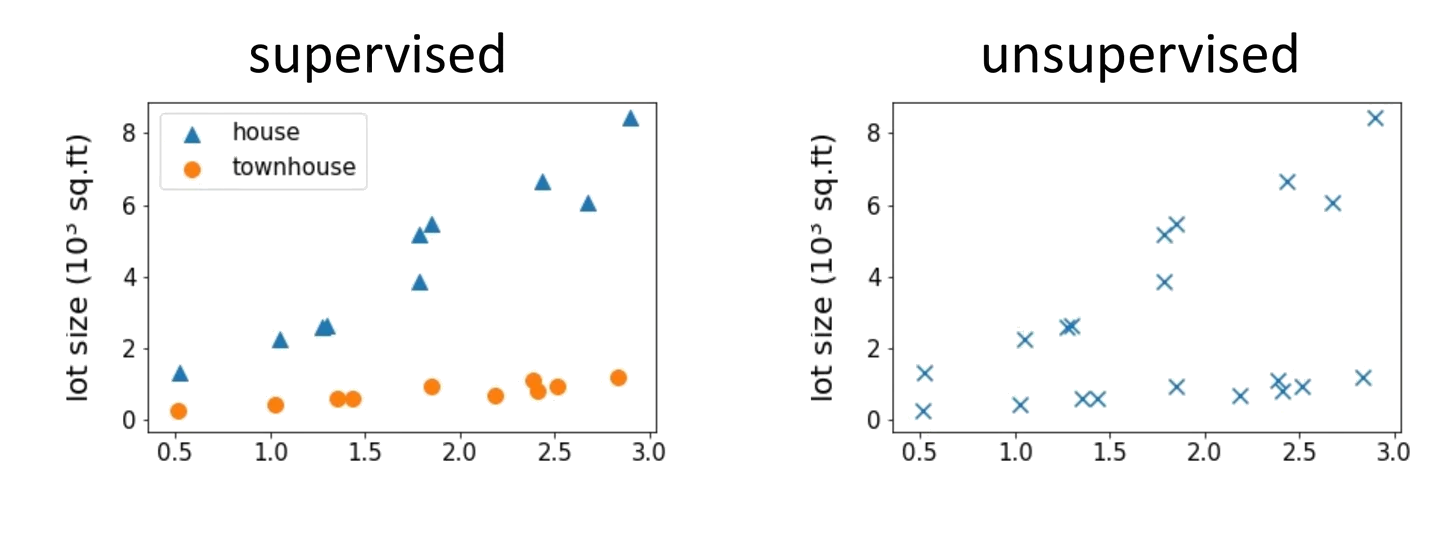
同一批房产数据画在图上,左边给每个点标了类别,三角形是 house,圆圈是 townhouse。右边把类别擦掉,所有点画成一样的叉。
左边你知道每个点是谁。右边你只能看出「这几个点挤在一起,那几个点挤在另一处」。无监督学习只能从右边这种图出发。
一步一步看
目标:把监督学习数据里的 y 全部擦掉,看算法只凭 x 能找出两团,起名和判断有没有意义却还要靠人。
-
监督学习的数据是一对一对的:(x, y),x 是特征,y 是答案。
-
把 y 全部擦掉,只剩 x⁽¹⁾, x⁽²⁾, …, x⁽ⁿ⁾。上标是第几条数据,n 是总条数。
-
算法看右图,能发现左下一团、右上一团。这「两团」就是它找出来的结构。
-
它不知道左下那团叫 house。给每团起名字、判断分得有没有意义,还得靠人来看。
怎么判断
拿到一个任务,问一句:训练数据里有没有标准答案 y?
- 有,算法照着答案学,是监督学习。
- 没有,算法只能自己找结构,是无监督学习。聚类是其中最常见的一种。
再问一句:结果好不好有没有客观判据?无监督学习没有。课件给目标加了个限定词 vaguely-posed,意思是这个目标本身就定义得很模糊。
常见误解
以为无监督学习就是「不需要数据」
它照样要数据,只是不要标签。课件原话是 Requires data, but no labels。
以为聚类结果一定有意义
课件把优点和风险并排写:在你不知道自己要找什么的时候它有用,但也可能得到一堆没意义的结果,原文是 gibberish。分组好不好,最后得靠人看。
试一下
下面两个任务,哪个是无监督学习?(a) 用一万封标好「垃圾 / 正常」的邮件训练过滤器;(b) 把一万封没标过的邮件自动分成几堆,看看都在聊什么。
(b) 是无监督学习。(a) 每封邮件都带答案,是监督学习里的分类;(b) 没有答案,只能按内容像不像来分堆,是聚类。
2. 先补一块:两点之间的距离(补充)
它解决什么问题
聚类要把「像」的放一起。电脑不懂「像」,只会算数。所以得先把「像」翻译成一个能算的数:两条数据离得越近,就越像。
本讲用的是欧氏距离,学过勾股定理就能算。
直觉
平面上两个点,横着差一段、竖着差一段。这两段是直角三角形的两条直角边,两点连线是斜边。斜边多长,两点就隔多远。
一步一步看
目标:用 P(1, 1) 和 Q(4, 5) 按坐标相减、平方相加再开根号,算出两点的欧氏距离是 5。
拿 P(1, 1) 和 Q(4, 5) 两个点来算。
-
横坐标相减:4 − 1 = 3。
-
纵坐标相减:5 − 1 = 4。
-
两个差各自平方再相加:3² + 4² = 9 + 16 = 25。这就是距离的平方。
-
开根号:√25 = 5,这是距离本身。
怎么算
课件写的是 dist(x, y) = ‖x − y‖²₂。
意思是:x 和 y 各有好几个坐标,对应坐标相减、各自平方、全部加起来。写成式子,两个坐标时是 (x₁ − y₁)² + (x₂ − y₂)²,坐标更多时就继续往后加。
这里有两个 2,含义不同。右下角的 2 说「按欧氏的办法量长度」,右上角的 2 说「量完再平方」。
为什么取平方、不开根号?比大小的时候,开不开根号结论一样。25 比 9 大,5 也比 3 大。省掉根号算得更快。另一个好处要到 L05b-1 才看得到:平方的形式求导以后,最好的中心恰好是平均值。
常见误解
以为聚类只能用欧氏距离
课件说欧氏距离平方只是一种选择,原文是 one option。用什么距离由人来定,换一种距离,分组可能完全不同。
以为取平方以后「谁更近」会变
不会变。平方对非负数保持大小顺序,比远近时取不取平方结论一样。会变的是数值本身,所以题目问「距离」还是「距离平方」要看清。
试一下
算 A(2, 2) 到 B(5, 6) 的距离平方和距离。
横差 3,竖差 4。距离平方 = 9 + 16 = 25,距离 = 5。
点 A(0, 0),B(3, 0),C(2, 2)。A 离 B 近还是离 C 近?
A 到 B:3² + 0² = 9。A 到 C:2² + 2² = 8。8 比 9 小,A 离 C 更近。
3. 聚类:同一批点,能分出好几种组
它解决什么问题
有了距离,下一个问题是:把数据分成几组、怎么分。这一节讲清一件事:没有标签时,分法不唯一。这就是课件说目标「模糊」的具体样子。
直觉
一批点,左边是两小撮,右边是上下两行。你可以说「一共三组」,也可以说「两组」,还可以说「四组」。每一种都有道理,因为没人告诉你哪种是对的。
想让答案唯一,得先替算法做两个决定:什么算像,以及要分几组。
一步一步看
目标:把同一批点按三种圈法分成 3、2、4 组,看没有标签时分法为什么不唯一,要先定义相似。
-
只画点,不画圈。左边两小撮挨得不远,右边两行也挨得不远。
-
第一种圈法:左边两小撮各一组,右边整体一组,共 3 组。
-
第二种圈法:左边合成一组,右边一组,共 2 组。
-
第三种圈法:左边两组,右边拆成上下两行,共 4 组。
-
三种都说得通。课件随后给出出路:先定义相似,比如用距离平方。距离定了,「谁离谁近」才有确定答案。
怎么判断
拿到一个聚类结果,问两句:
- 用的是什么距离?换一种距离,结果可能完全不同。课件原话说结果「极度依赖」这个选择,英文是 crucially dependent。
- 分几组是谁定的?这一点算法通常不替你决定。
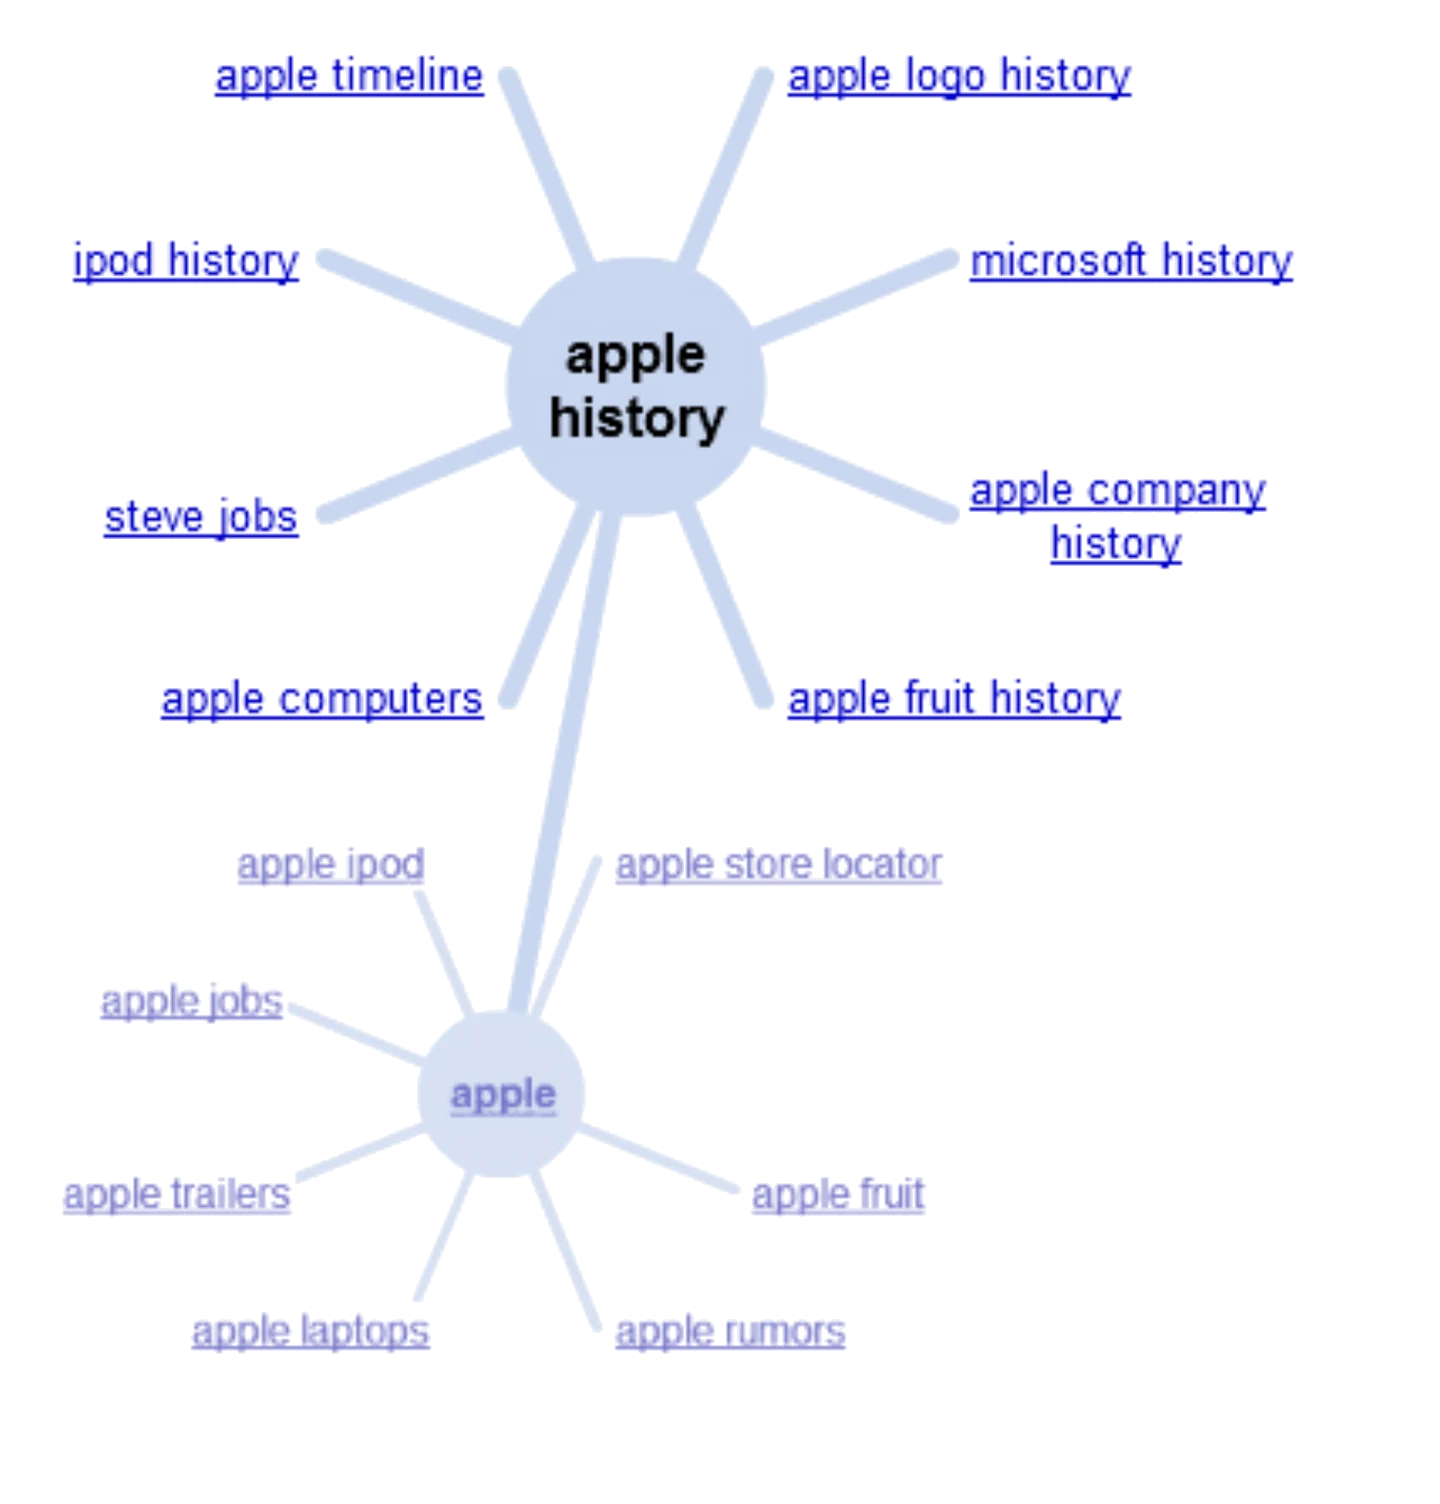
「相似」也不一定是几何上的直线距离。搜索词「apple」周围有 apple ipod、apple store locator、apple fruit 这些查询。按「哪些查询常一起出现、点了同样的结果」来算像不像,就能把 apple 拆成找公司、找产品、找水果几个意图簇。
常见误解
以为三种圈法里总有一种是「对」的
没有标签就没有对错判据。三种都说得通,选哪种取决于你定的距离和组数,以及这个分组拿去做什么用。
试一下
一维数据 1、2、3、10、11、12。分成 2 组和分成 6 组,各怎么分?哪种更「合理」?
2 组:{1, 2, 3} 和 {10, 11, 12}。6 组:每个数自成一组。数学上两种都合法;按「同组的要近、不同组的要远」,2 组更合理,因为 3 和 10 之间有一大段空隙。6 组等于没分。
4. 聚类算法交出的两种结果:分组表和树
它解决什么问题
聚类算法很多,课件用一张表把它们分成两大类。分类依据是「交出来的东西长什么样」。知道这一点,看到任何一个算法名字都能先归类。
直觉
平坦式像发座位表:每个人坐几号桌,一张表写完,桌子之间没有关系。
层次式像家谱:先是几个人凑成小家,小家再合成大家族,一层套一层。想要几组,就在家谱的某个高度横着切一刀。
一步一步看
目标:对照平坦式交出的分组表和层次式交出的树,看在树上横切一刀怎样分出几组,两大类各有哪些算法。
-
平坦式(flat,也叫 partition):交出一张表,每个点属于哪一组。组数一般要事先定。
-
本讲的 K-means 属于这一类,同类还有 Mixture of Gaussian 和 Spectral Clustering。
-
层次式(hierarchical):交出一棵树。最下面每个点自成一组,越往上合并得越多。
-
在树的某个高度横切一刀,切到几根竖线,就分成几组。下图在那个高度切出 {a b}、{c d e}、{f} 三组。
-
层次式按建树方向又分两种:自底向上合并(bottom up,叫凝聚 agglomerative),自顶向下拆分(top down,叫分裂 divisive)。
| 大类 | 交出什么 | 成员 |
|---|---|---|
| 平坦式 | 一张分组表 | K-means、Mixture of Gaussian、Spectral Clustering |
| 层次式 | 一棵树 | 自底向上凝聚、自顶向下分裂 |
怎么判断
看输出:
- 输出是「每个点属于第几组」,是平坦式。
- 输出是一棵树,能在不同高度切出不同粒度,是层次式。课件里的语言谱系树、犬科物种谱系树、基因表达热图左边那棵树,都是层次式的输出。
凝聚和分裂容易记反。agglomerate 是「聚成一团」,从单个点往上合并;divide 是「切开」,从一整团往下拆。
常见误解
以为层次式也要事先给定组数
不用。它交出整棵树,你想分几组,事后在对应高度横切一刀就行。这是它相对平坦式的主要方便之处。
把凝聚和分裂的方向记反
凝聚是自底向上,从每个点自成一组开始不断合并;分裂是自顶向下,从全部点一组开始不断拆。
试一下
新闻聚合网站把几十家媒体对同一事件的报道归成一条。它交出的是分组表还是树?
分组表:每篇报道属于哪个事件。事件之间不需要谁包含谁,属于平坦式的输出形态。
把它们串起来
无监督学习只有数据,没有答案。它要找的「结构」,最常见的就是分组,也就是聚类。
分组之前,得先把「像」变成能算的数。课件用欧氏距离的平方:坐标相减、平方、相加。距离一定,谁离谁近就确定了。
可距离只是人选的一种说法。同一批点能圈成 3 组、2 组或 4 组,换一种距离也可能分得完全不一样。所以聚类的结果由两样人为的选择决定:距离和组数。
聚类算法按输出分两类。平坦式交一张分组表,层次式交一棵树、事后横切。下一页的 K-means 是平坦式里最常用的一个。
课件里的坑
- [限定词] 课件给无监督学习的目标加了括号 vaguely-posed,目标本身是模糊的,这是考点(p.2)
- [记号] 本讲样本数写作 n,上一讲线性回归用 m,p.22 的复杂度又写 N,三个指同一件事。答题跟着题面给的符号走(p.2、p.22)
- [one option] 欧氏距离平方只是相似度的一种选择,别写成「聚类就是用欧氏距离」(p.6)
- [三页连看] p.4–6 是同一张幻灯片的三次动画,单看一页看不出它在讲「分法不唯一」(p.4–6)
- [谱系树里的数字] 语言树上红色数字是推定的分化年代,黑色小字是统计支持度,课件没解释,知道「树上的数字不止一种」即可(p.13)
- [外群] 犬科谱系树最下面的熊、熊猫、象海豹、海象不属于犬科,是给整棵树定根用的外群(p.14)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先在纸上随手点 6 个点,自己圈出两种不同的分法;再算一遍 P(1,1) 到 Q(4,5) 的距离平方;然后过一遍课件例题和完整例题,每题先说结论再看解答;最后做变式题。
必背
- 无监督学习的数据只有 x 没有标签,目标是找数据自身的结构,课件明确标注这个目标是模糊定义的、没有客观对错判据
- 「相似」的一种选择是欧氏距离的平方 dist(x, y) = ‖x − y‖²₂;聚类结果极度依赖所选的距离度量
- 聚类算法分两大类:平坦式(K-means、Mixture of Gaussian、Spectral Clustering)输出一张分组表,层次式(自底向上凝聚、自顶向下分裂)输出一棵可在任意高度横切的树
- 聚类在不知道要找什么时有用,风险是可能得到一堆没意义的结果(gibberish),课件把两句并排写
- 「相似」不一定是几何距离:搜索词聚类按查询的共现或点击行为,把多义词 apple 拆成几个意图簇
课件例题
例 1(课件 p.2):两张房产散点图差在哪?
题面:同一批房产数据,纵轴是 lot size。左图标 supervised,三角形是 house、圆点是 townhouse;右图标 unsupervised,所有点画成同一种叉。
提示
两张图的点位置一样吗?差的是哪样东西?
解答
数据一模一样,差别只在有没有标签。左图知道每个点是哪类,右图只有 x⁽¹⁾…x⁽ⁿ⁾,算法只能自己找结构。
例 2(课件 p.4–6):同一批点,三页画了三种圈法,哪种对?
见下方完整例题。
例 3(课件 p.7、p.12–14):下面几样东西各属于平坦式还是层次式?
题面:K-means、Spectral Clustering、自底向上合并、语言谱系树、犬科物种谱系树。
提示
看输出:一张分组表,还是一棵树?
解答
K-means、Spectral Clustering 是平坦式,输出分组表。自底向上合并是层次式里的凝聚法。两张谱系树都是层次式的输出,在不同高度横切就得到不同粒度的分组,不用事先定簇数。
例 4(课件 p.15):搜索词「apple」为什么能被聚成几簇?
题面:图上两个节点 apple history 和 apple,周围是 apple ipod、apple store locator、apple fruit 等相关查询。
提示
搜 apple 的人都想找同一样东西吗?这里的「像」怎么算?
解答
同一个词背后有不同意图:找公司、找产品、找水果。把查询按意图分组就是聚类。这里的「相似」来自查询的共现或点击行为,不是几何坐标上的直线距离。
完整例题
课件 p.4–6 是同一张幻灯片的三次动画,合起来回答「聚类的目标为什么模糊、怎样让它变得可算」。
题面:同一批点分成左右两部分,左边是两小撮,右边是上下两行。p.4 左边画两个小圈、右边一个大椭圆;p.5 左右各画一个大椭圆;p.6 左边两个小圈、右边拆成上下两个扁椭圆。三种圈法各分成几组?哪种对?要让算法给出确定的分法,需要先定什么?
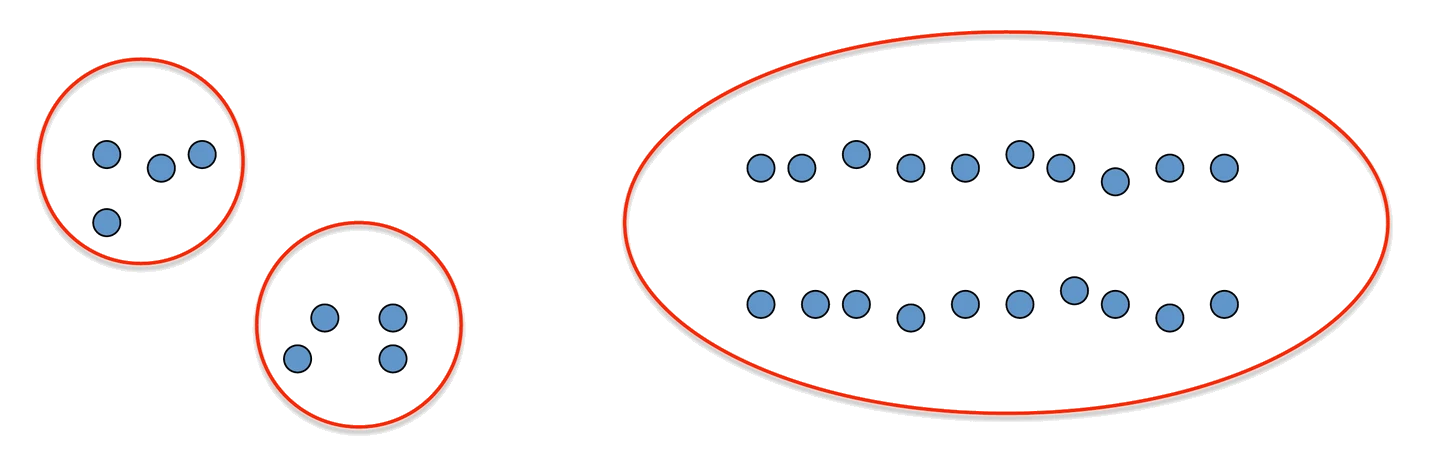
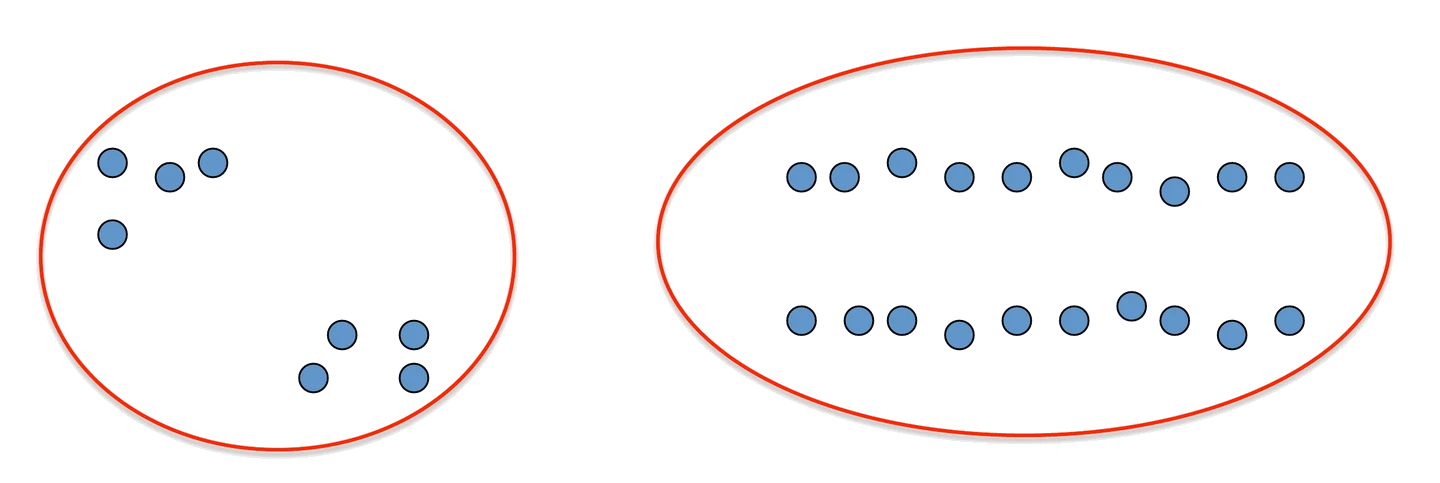
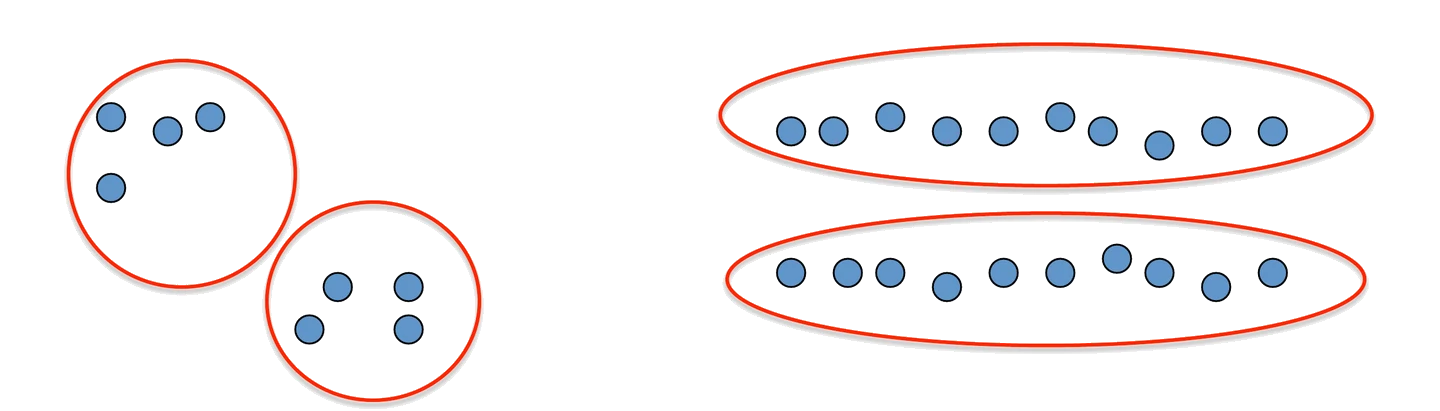
- 数组数:p.4 是 2 + 1 = 3 组,p.5 是 1 + 1 = 2 组,p.6 是 2 + 2 = 4 组。
- 判断哪种对:三种都说得通。左边两小撮可以看成两组,也可以看成一组;右边两行同理。没有标签,就没有依据说哪种错,这正是 p.2 那句 vaguely-posed 的图示。
- 课件给的出路:先定义「相似」。一种选择是欧氏距离的平方小,dist(x, y) = ‖x − y‖²₂(p.6)。
- 定下来之后:距离定了,「哪些点更近」就有了确定的答案,算法才能动手。但 p.6 紧接着说,结果极度依赖这个选择:换一种度量,分组可能完全不同。
- 组数也要另外定:即使距离定了,分 2 组、3 组还是 4 组仍要人决定。平坦式要事先给出组数,层次式可以事后在树上横切。
这道题的结论要单独记:聚类的结果由两样人为选择决定,距离度量和组数,算法本身不提供「标准答案」。
答题格式:先数组数,再说「三种都说得通」的理由,最后写出课件的距离公式和「极度依赖」那句。只写「p.6 对」会被判错。
变式题(先自己做)
自编情境:三个点 A = (1, 2)、B = (4, 6)、C = (1, 5)。(a) 用欧氏距离的平方,算 A 到 B、A 到 C 的距离,A 和谁更像?(b) 改用不取平方的欧氏距离,结论会变吗?(c) 一张犬科物种谱系图属于平坦式还是层次式输出?若想事后再决定分几类,该选哪一类算法?
提示
(a) 坐标分别相减、平方、相加。(b) 平方是单调的,比大小时取不取根号有影响吗?(c) 回想「任意高度横切一刀」那句。
判分点与答案(非官方评分标准)
判分点:① (a) 两组距离平方都写出;② (b) 说出排序不变的理由;③ (c) 分类与理由都对。
(a) A 到 B:(4 − 1)² + (6 − 2)² = 9 + 16 = 25。A 到 C:(1 − 1)² + (5 − 2)² = 0 + 9 = 9。A 和 C 更像。
(b) 不变。不取平方时距离是 5 和 3,大小关系一样。平方只是省掉根号,不改变「谁更近」。
(c) 层次式,它输出一棵树。层次式不必事先定簇数,想分几类就在对应高度横切一刀。
闪卡自测
1. 无监督学习和监督学习在输入上差在哪?为什么课件说它的目标 vaguely-posed?
无监督学习只有 x⁽¹⁾…x⁽ⁿ⁾,没有标签。「有意思的结构」没有客观判据,同一批点课件给出 3 组、2 组、4 组三种分法(p.2、p.4–6)。
2. 课件给的相似度公式是什么?为什么取平方?
dist(x, y) = ‖x − y‖²₂,欧氏距离的平方。取平方一是比大小时根号多余,二是平方可导且求导后解出的最优中心恰好是算术平均(p.6、p.23)。
3. 聚类的优点和风险,课件各用哪句话写的?
优点是 useful when don’t know what you’re looking for,风险是 can get gibberish,也就是可能得到一堆没意义的结果。两句并排写(p.3)。
4. 默写算法分类表:两大类各叫什么、各有哪些成员。
Partition / Flat:K-means、Mixture of Gaussian、Spectral Clustering。Hierarchical:bottom up 凝聚、top down 分裂(p.7)。
5. 层次聚类相比平坦聚类,多了什么方便?
不必事先定簇数。它输出一棵树,想分几类就在对应高度横切一刀(p.12)。
下一讲
下一页 L05a-2 讲平坦式里最常用的 K-means:先挑 K 个中心,每个点归给最近的那个,中心挪到自己那批点的平均位置,重复到没有点换组。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。