L05b-1 K-means 的目标与收敛:一定会停,但不一定停在对的地方
从零讲 K-means 在压低什么:先看一组数的平方和为什么在平均处最小,再看两步循环怎样轮流压低距离平方和、为什么一定停,以及起点不好时为什么会卡在明显错的分法上。
一句话版
K-means 的两步循环在压低一个具体的数:每个点到所属中心的距离平方,全部加起来。两步轮流把它往下压,从不让它变大,所以一定会停。
可停在哪取决于起点。起点不好,算法会停在一个明显不对的分法上,自己走不出来。这一页从「为什么中心要取平均」讲起,一路讲到它为什么会卡住。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 目标函数 | objective function | 算法想压到最低的那个数 |
| 误差平方和 | SSE,sum of squared errors | 每个点到所属中心的距离平方,全部加起来 |
| 偏导 | partial derivative | 只让一个变量动、别的不动时的变化率 |
| 交替优化 | alternating optimization | 两组变量轮流固定一组、调另一组 |
| 局部最优 | local optimum | 周围的小改动都只会更差,但不一定是全局最好 |
| 启发式算法 | heuristic | 通常能给出不错的解,但不保证最好 |
一个类比:下山只肯往下走的人
一个人在起雾的山里找最低点。他看不远,只认一条规矩:每一步都不能比现在高。他先沿东西方向挪到最低处,再沿南北方向挪到最低处,来回交替。
这个人一定会停下来,因为他一直在往下走,山又不是无底的。可他停的地方可能只是一个小坑。真正的谷底在山梁另一边,要过去得先往上爬一段,而他的规矩不许他爬。
K-means 就是这个人。东西、南北两个方向,对应「调分组」和「调中心」两步。
类比在哪里失效:
- 山是连续的,人每步可以挪很小一点。K-means 的分组是离散的,一个点要么在这组、要么在那组。
- 真人站在小坑里看一眼地图,就知道该翻过去。K-means 没有地图,只会做两种小动作。
从零讲起
1. 先补一块:一组数的平方和,在平均处最小(补充)
它解决什么问题
上一页的更新步说:中心挪到组员的平均位置。为什么偏偏是平均,不是中位数,也不是最中间那个点?
这一节先在一条数轴上把这件事讲透。下一节会看到,它就是 K-means 更新步的来历。
直觉
数轴上有几个点,你要放一个中心 c,代价是每个点到 c 的距离平方之和。c 放得太左,右边的点距离很大;放得太右,左边的点吃亏。
平方会把远的距离放大得很厉害,所以 c 不能偏向任何一边太多。平衡点正好落在平均处。
一步一步看
目标:把中心放在不同位置算三个数的距离平方和,看出最小值正好落在平均值 3 上。
拿三个数 1、2、6 来算。它们的平均是 (1 + 2 + 6) / 3 = 3。
-
中心放在 c = 0:1 + 4 + 36 = 41。
-
中心放在 c = 2:1 + 0 + 16 = 17。
-
中心放在 c = 3:4 + 1 + 9 = 14。
-
中心放在 c = 4:9 + 4 + 4 = 17。
-
中心放在 c = 6:25 + 16 + 0 = 41。
-
画出来是一条开口向上的抛物线,最低点在 c = 3,就是平均值。左右两边对称地往上翘。
怎么算
把代价写成 f(c) = Σ (x − c)²,对 c 求导:f′(c) = −2 Σ (x − c)。
意思是:导数等于零的地方,Σ (x − c) = 0,也就是所有点在 c 左右的「偏差」正好抵消。把它展开,Σ x = n · c,于是 c = (Σ x) / n,正是平均值。
如果代价换成距离的绝对值,不取平方,最优的 c 就变成中位数。平方让远处的点说话更大声,平均就会被它往那边拉。
常见误解
以为平均和中位数是一回事,选哪个都行
用平方算代价,最好的中心是平均;用绝对值算代价,最好的中心是中位数。1、2、6 的平均是 3,中位数是 2,两者不同。K-means 用的是平方,所以取平均。
试一下
三个数 1、2、6,代价改成距离的绝对值之和。c 放在 2 和放在 3,各是多少?哪个更小?
c = 2:1 + 0 + 4 = 5。c = 3:2 + 1 + 3 = 6。放在 2(中位数)更小,印证了「绝对值对应中位数」。
2. 目标函数与交替优化:两步都在压同一个数
它解决什么问题
上一页把 K-means 讲成两个动作。这一节说清两个动作背后的统一目标:它们都在压低同一个数,误差平方和。看清这一点,「为什么取平均」和「为什么一定停」就都有了答案。
直觉
误差平方和同时取决于两样东西:每个点归哪组,以及每组中心在哪。两样一起调太难,K-means 就轮流来。
先把中心钉住,只调分组:每个点挑离自己最近的中心,总和就最小。再把分组钉住,只调中心:每组中心取平均,总和就最小,这正是上一节的结论。
一步一步看
目标:每走完一步就记一次误差平方和,看分配和更新交替进行时这个数只降不升。
还用上一页那六个点:A(1, 1)、B(2, 2)、C(3, 0)、D(4, 3)、E(4, 4)、F(4, 5),从 μ₁ = B、μ₂ = C 出发。每做完一步,算一次误差平方和。
-
第 1 轮分配后:28。
-
第 1 轮更新后:18。
-
第 2 轮分配后:15。
-
第 2 轮更新后:10.5。
-
第 3 轮分配后:8.25。
-
第 3 轮更新后:6。
-
第 4 轮分配后:6,没有点换组,停止。
-
每一步都没有让它变大。分配和更新轮流各降一段,最后停在 6。
怎么算
课件把目标写成 min_μ min_C Σᵢ Σ_{x∈Cᵢ} |x − μᵢ|²。
意思是:对每个簇 Cᵢ 里的每个点 x,算它到本簇中心 μᵢ 的距离平方,全部加起来;然后在所有可能的分组 C 和所有可能的中心 μ 里,找让这个和最小的那一组。
两步对应两个「固定一半」:
- 固定中心、调分组:把按簇求和改成按点求和,每一项只和一个点的归属有关,各点互不影响。每个点挑最近的中心,总和就最小。这就是分配步。
- 固定分组、调中心:只看第 i 个簇,对 μᵢ 求偏导得 −2 Σ_{x∈Cᵢ} (x − μᵢ),令它为零,得到 μᵢ = (1/|Cᵢ|) Σ_{x∈Cᵢ} x,也就是簇内的平均。这就是更新步。
常见误解
背下「中心取平均」却说不出为什么
理由是目标用了距离的平方。对平方和求偏导、置零,解出来就是平均。上一节的抛物线是一维的版本。
以为分配步会让中心变好
分配步只动归属,中心原地不动;它降的是「点没找对中心」造成的那部分误差。中心变好是更新步的事。两步各管一半。
试一下
一个簇只有两个点 (0, 0) 和 (4, 2)。中心放在 (2, 1) 和放在 (0, 0),误差平方和各是多少?
中心 (2, 1):到 (0, 0) 是 4 + 1 = 5,到 (4, 2) 是 4 + 1 = 5,合计 10。中心 (0, 0):0 + (16 + 4) = 20。平均位置 (2, 1) 更小。
3. 一定会停,但可能卡住:初始化为什么要紧
它解决什么问题
两步都不让误差变大,那它最后停在哪?是不是一定停在最好的分法?这一节回答:一定停,但不一定最好;起点不好时,它会卡在一个明显错的地方。
从哪来(补充)
课件只点名了补救办法,没有展开。常用的一种叫 k-means++,由 Arthur 和 Vassilvitskii 在 2007 年提出。第一个中心均匀随机地挑;之后每个中心按概率挑,概率和 D(x)² 成正比,D(x) 是这个点到已选中心里最近那个的距离。离已有中心越远的点越容易被挑中,初始中心就自然散开了。出处:Wikipedia: k-means++。
直觉
一定会停:误差只降不升,分法又只有有限多种,不可能永远降下去。
可能卡住:算法只会做两种小动作,换组和挪中心。如果正确答案离现在很远,要先把误差抬高一点才能过去,它就过不去了。就像那个只肯往下走的人,困在小坑里。
一步一步看
目标:同样九个点分别从好起点和坏起点出发,看坏起点为什么停在 154.5,走不到 6。
一维数据:0、1、2、10、11、12、20、21、22,三团分得很开。K = 3。
-
好起点:中心放在 1、11、21,各在一团中间。第一次分配就得到三团,更新后中心不动,直接停。误差平方和 = (1 + 0 + 1) × 3 = 6。
-
坏起点:中心放在 0、1、2,三个全挤在第一团。
-
坏起点第 1 轮:0 归第一个中心,1 归第二个,其余七个点全归第三个。更新后中心变成 0、1、14。
-
第 2 轮:分界点 0.5 和 7.5。第一团被两个中心瓜分成 {0} 和 {1, 2},后两团合用一个中心。更新后中心变成 0、1.5、16。
-
第 3 轮:分界点 0.75 和 8.75,没有点换组,停止。误差平方和是 0 + 0.5 + 154 = 154.5。
-
154.5 比 6 差得多,可算法已经停了。要走到好解,得先把前两个中心合并,再把腾出来的那个搬到右边去。合并那一下会让误差先变大,两步都不许误差变大,所以这条路走不通。
怎么判断
拿到一个 K-means 结果,问两句:
- 它停了吗?停了只说明「换组和挪中心都降不下去」,不说明这是最好的分法。
- 换几个起点再跑,结果一样吗?不一样,说明有的起点卡住了。常用的办法是多跑几次,留误差平方和最小的那次。
课件把这两层意思分在两页写:一页说保证会收敛(Guaranteed to converge),另一页说它是启发式算法(K-means is a heuristic)。前一句管「会停」,后一句管「停得好不好」。课件点名的补救是基于方差的 split / merge,以及各种初始化启发式。
常见误解
把「保证会停」读成「保证最好」
收敛论证只用到两件事:误差单调不增,分法有限。它推出会停,推不出停在哪。
以为多转几轮就能自己走出来
已经停了,再转也是原地不动。走出来要先让误差变大,两步都不会这样做。只能换个起点重新跑。
把卡住和「形状分不开」混为一谈
卡住是起点的问题,换个起点有救。内外两个圆环那种非凸形状,换多少次起点都分不开,那是边界只能是直线造成的,L05b-2 会讲。
试一下
上面坏起点停在中心 0、1.5、16。把右边的点 20 改归中心 1.5,误差平方和会变小吗?
不会。20 到 16 的距离平方是 16,到 1.5 是 18.5² = 342.25,改过去会大很多。每个点都已经在最近的中心那里,所以算法停了。
把它们串起来
一组数的平方和在平均处最小,这是更新步取平均的来历。
把它放进 K-means:误差平方和同时取决于分组和中心。固定中心,每个点找最近的,分配步把它压到最低;固定分组,中心取平均,更新步把它压到最低。两步轮流,误差只降不升。
只降不升,分法又有限,所以一定会停。可停下的只是「两种小动作都降不下去」的地方。起点不好,它会卡在一个明显错的分法上,所以 K-means 是启发式算法,初始化要紧。
还剩一个问题:K 本身从哪来。
课件里的坑
- [课件手改] 推导页上「Take partial derivative of μᵢ」的 of 被当堂划掉,下方改写成 with respect to,是对 μᵢ 求偏导(p.23)
- [前后照应] 「Guaranteed to converge」和「K-means is a heuristic」隔了五页,容易只记住前半句,两页要合看(p.22、p.27)
- [记号] 样本数在 p.2 写成 n、p.22 写成 N,上一讲线性回归用的是 m,三个符号指同一件事(p.2、p.22)
- [只点名] 补救措施 variance-based split / merge 和初始化启发式,课件只列了名字没展开(p.27)
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,在纸上对 Σ (x − c)² 求导、置零、解出平均;再默写完整例题的三步推导;最后做变式题,每步算一次误差平方和,检查它有没有升过。
必背
- 目标函数是所有点到所属中心的距离平方和;第一步固定中心优化划分,第二步固定划分优化中心,两步都不会增大它
- 中心取算术平均是对目标函数求偏导置零解出来的;目标里的平方换成绝对值,最优中心就变成中位数
- 收敛论证是「目标函数单调不增 + 划分方式总数有限」,只保证会停、不保证停在全局最优,所以 K-means 是启发式算法
- 初值确实有影响:同一批点换一组初始中心会收敛到不同结果;课件点名的补救是基于方差的 split / merge 和各种初始化启发式
- 卡住的机制:走到正确解要先合并两个中心、再把一个搬走,中途误差平方和必然升高,只往下走的算法不会走上坡路
课件例题
例 1(课件 p.23):从目标函数推出 K-means 的两步,并说明为什么一定收敛。
见下方完整例题。
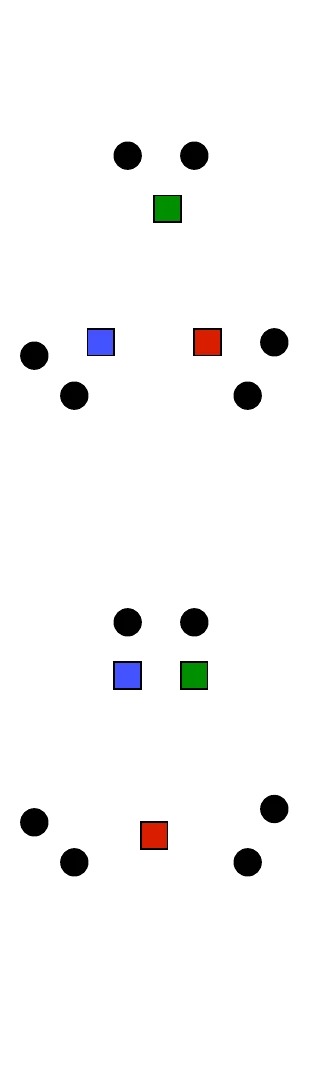
例 2(课件 p.27):同样 6 个点、两组不同的初始中心,结果会一样吗?
题面:每组都是同样的 6 个黑点(上方 2 个、中间 2 个偏外、下方 2 个)。上组 3 个彩色方块分在顶部两点之间、中间左、中间右;下组两块挤在顶部相邻、一块独自在下方中间。
提示
K-means 从起点出发只会往下走,起点不同,能走到的坑一样吗?
解答
不一定一样。K-means 是启发式算法,需要给定初始中心,课件原话是选什么初值确实有影响(It does matter what you pick)。同一批数据、不同初值,可能收敛到不同的分法。课件点名的补救是基于方差的 split / merge 和各种初始化启发式。
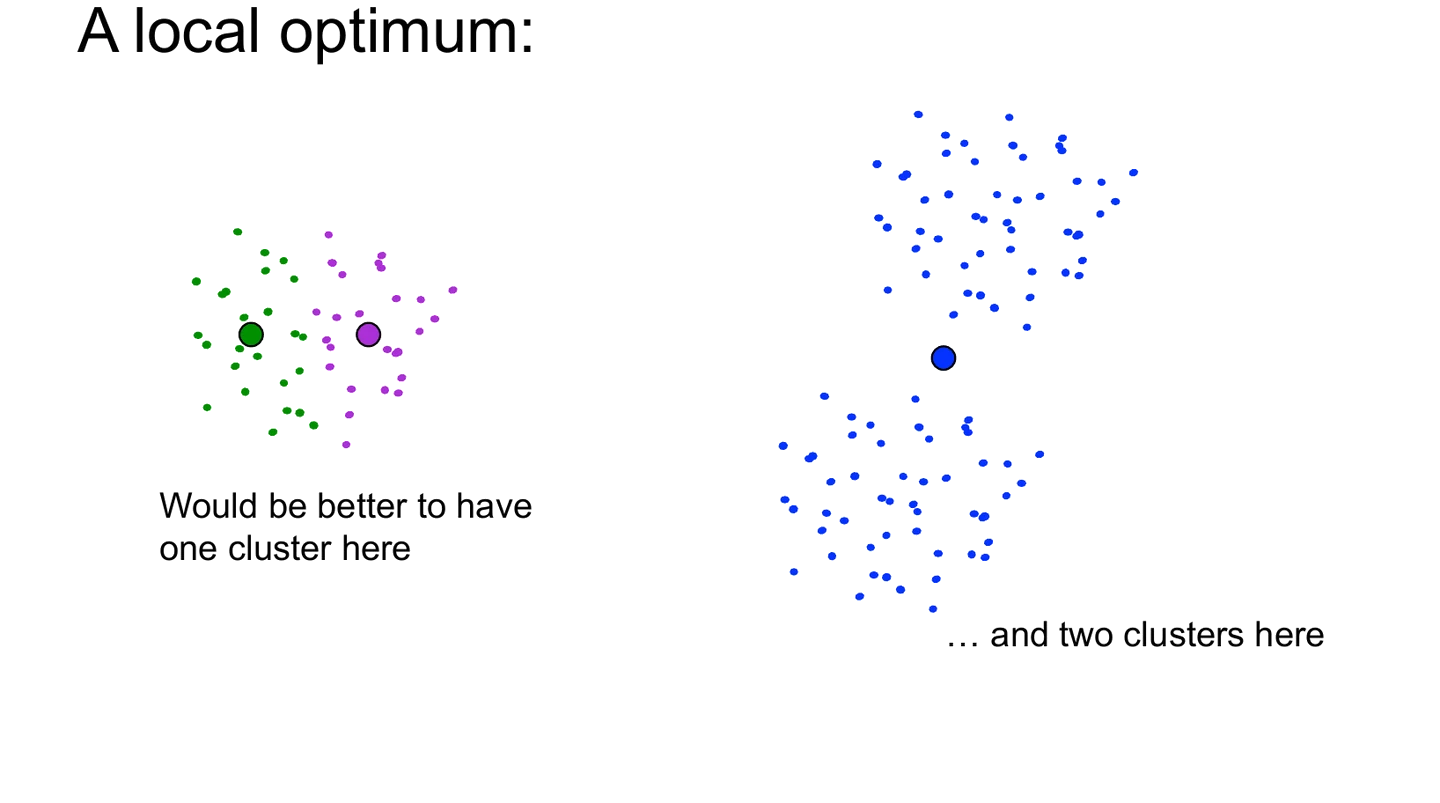
例 3(课件 p.28):K=3 的这个结果已经收敛,为什么说它卡住了?
题面:左边一团被绿、紫两个中心各管一半,配文「这里本该只要一个簇」;右边上下分开的两团共用一个蓝色中心,中心画在两团中间的空隙处,配文「而这里本该有两个簇」。
提示
从这个分法走到正确分法,中途误差平方和会怎样变?
解答
任何一个点换归属都不会让误差平方和下降,所以算法停了,这是局部最优。走到正确解要先把左边两个中心合并、再把其中一个搬到右边,中途误差必然先升高。两步都只让误差不增,算法不会走这段上坡路。
完整例题
课件 p.23 是本讲最值得花时间的一页:从一个目标函数同时推出算法的两步和收敛性。
题面:目标函数为 min_μ min_C Σ_{i=1}^{k} Σ_{x∈Cᵢ} |x − μᵢ|²。(a) 固定中心 μ,怎样的划分 C 让它最小?(b) 固定划分 C,怎样的中心 μᵢ 让它最小?写出推导。(c) 用 (a)(b) 论证 K-means 一定在有限步内停止,并说明这个论证没有保证什么。
- (a) 改写求和:把按簇求和改成按点求和,Σᵢ Σ_{x∈Cᵢ} |x − μᵢ|² 等于 Σⱼ |xⱼ − μ_{xⱼ}|²,μ_{xⱼ} 是点 xⱼ 被分到的中心。每一项只和一个点的选择有关,各点互不影响,所以每个点挑离自己最近的中心,总和就最小。这正是第一步「分配到最近中心」(课件标注 Step 1 of kmeans)。
- (b) 求偏导:只看第 i 个簇,Σ_{x∈Cᵢ} |x − μᵢ|² 对 μᵢ 求偏导(with respect to μᵢ)得 −2 Σ_{x∈Cᵢ} (x − μᵢ)。令它为零,得 |Cᵢ| · μᵢ = Σ_{x∈Cᵢ} x,即 μᵢ = (1/|Cᵢ|) Σ_{x∈Cᵢ} x,簇内点的算术平均。这正是第二步「中心改成平均值」(Step 2 of kmeans)。
- (c) 收敛:第一步在当前中心下取到最小,第二步在当前划分下取到最小,所以每一步都不会让目标变大。目标单调不增;n 个点分进 K 个簇,划分方式至多 Kⁿ 种,在有限集合上单调不增的序列不能无限变下去,所以有限步内停止。
- (c) 没保证什么:交替优化每次只在一组变量上取最优,停下来的地方是「改哪一组都降不下去」的点,不一定是全局最小。这就是 p.27 说 K-means 是启发式算法、p.28 会卡住的原因。
答题格式:(a) 要写出按点求和的改写,光说「分给最近的」不给理由扣分;(b) 求导、置零、解出公式三步写全;(c) 两个条件「单调不增」和「划分有限」缺一不可,最后补一句不保证全局最优。
变式题(先自己做)
变式 1(自编情境):一维数据 x = 1, 2, 3, 8, 9, 10,取 K = 2,初始中心故意选坏:μ₁ = 1、μ₂ = 2。手算到收敛,写出每一步(分配和更新分开算)之后的误差平方和,检查它是否每步都不增。
变式 2(改编自课件 p.28):一维数据 x = 0, 1, 2, 10, 11, 12, 20, 21, 22,取 K = 3。(a) 初始中心 μ = (1, 11, 21),算到收敛,写出最终划分和误差平方和。(b) 初始中心 μ = (0, 1, 2),算到收敛,写出最终划分和误差平方和。(c) 两个结果哪个好?(b) 为什么出不去?
提示
变式 1:一维里两个中心的分界点就是中点;分配后算一次误差,更新后再算一次。变式 2:(b) 前两个中心一开始都困在第一团里,看看它们各自能捞到哪些点。(c) 回想例 3 的机制:从坏解走到好解要先合并再搬家。
判分点与答案(非官方评分标准)
判分点:① 每轮写出分界点;② 误差平方和逐步不增;③ 变式 2 (c) 点出「局部最优、启发式」和上坡路的机制。
变式 1:第 1 轮分配(分界点 1.5):1 归 C₁,2、3、8、9、10 归 C₂,误差 = 0 + (0+1+36+49+64) = 150。更新:μ₂ = (2+3+8+9+10)/5 = 6.4,误差降到 19.36+11.56+2.56+6.76+12.96 = 53.2。第 2 轮分配(分界点 3.7):{1,2,3}、{8,9,10},误差 = (0+1+4) + (2.56+6.76+12.96) = 27.28。更新:μ = (2, 9),误差 = (1+0+1) + (1+0+1) = 4。第 3 轮分配(分界点 5.5)划分不变,停止。150 → 53.2 → 27.28 → 4,分配和更新交替各降一次。
变式 2 (a):第 1 轮分配即得 {0,1,2}、{10,11,12}、{20,21,22};更新后中心不变,直接收敛。误差平方和 = (1+0+1) × 3 = 6。
(b) 第 1 轮:0 归 μ₁,1 归 μ₂,其余全归 μ₃;更新得 μ = (0, 1, 98/7 = 14)。第 2 轮:分界点 0.5 与 7.5,得 {0}、{1,2}、{10,11,12,20,21,22};更新得 μ = (0, 1.5, 96/6 = 16)。第 3 轮:分界点 0.75 与 8.75,划分不变,收敛。误差平方和 = 0 + 0.5 + (36+25+16+16+25+36) = 154.5。
(c) (a) 明显好,6 对 154.5。(b) 已经收敛,任何一个点换归属都不会让误差下降,但它是局部最优:要走到 (a) 的解,得先把前两个中心合并、再把腾出来的那个搬到第三团,中途必然经过误差更高的状态。这和例 3 左边一团被切成两半、右边两团共用一个中心是同一种卡法。
闪卡自测
1. 默写目标函数,并说出两步分别在优化什么。
Σᵢ Σ_{x∈Cᵢ} |x − μᵢ|²。第一步固定中心 μ 优化划分 C,第二步固定划分 C 优化中心 μ(p.23)。
2. 对 μᵢ 求偏导推出中心更新公式。平方换成绝对值会怎样?
Σ|x − μᵢ|² 对 μᵢ 求导得 −2Σ(x − μᵢ),置零得 μᵢ = (1/|Cᵢ|)Σ_{x∈Cᵢ} x,即算术平均。换成绝对值,最优中心变成中位数(p.23)。
3. 完整论证 K-means 一定停止。这个论证说明它停在全局最优了吗?
两步都不增大目标函数,而划分方式的总数有限(至多 Kⁿ 种),单调不增的序列在有限集合上必然停住。没有说明全局最优,交替优化只保证局部最优(p.22、p.23)。
4. 课件 K=3 那个「摆错位置」的例子已经收敛了,为什么出不去?
走到正确解要先合并左边两个中心、再把一个搬到右边,中途误差平方和必然先升高。两步都只让它不增,算法不会走上坡路(p.28)。
5. 课件给了哪两类补救?课外常用的又是哪两种?
课件:基于方差的 split / merge、各种初始化启发式。课外:多次随机初始化取误差最小的那次,k-means++ 让初始中心彼此尽量远(p.27)。
6. 推导页上有一处当堂手写改动,改了什么、为什么?
「Take partial derivative of μᵢ」的 of 被划掉,改成 with respect to。求偏导是「对 μᵢ」求,原写法说反了对象(p.23)。
下一讲
下一页 L05b-2 回答剩下的问题:K 从哪来,以及什么形状的数据 K-means 换多少次起点都分不开。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。