L05b-2 选 K 与 K-means 的适用范围:分几组怎么定,什么形状怎么分都不对
从零讲 K 怎么选:在图像分割里看 K 改变了什么,为什么不能挑误差最小的 K,肘部法怎么读;再看同心环和月牙为什么 K-means 必然分错,以及换一种特征为什么能救。
一句话版
K-means 要人先给 K。K 越大,误差平方和越小,所以不能挑误差最小的 K;要找误差曲线突然变平的那个拐点,这叫肘部法。
K 选对了也不一定分得对。分界线只能是直线,内外两个圆环、两个月牙这种形状,K-means 换多少次起点都会切错。出路之一是换一种描述数据的方式,让它们变得能用直线分开。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 图像分割 | image segmentation | 把一张图切成几块颜色相近的区域 |
| 肘部法 | elbow method | 画出误差随 K 的曲线,取弯得像手肘的那一点 |
| 非凸 | non-convex | 形状里有两点的连线会跑出形状,比如月牙、圆环 |
| 特征 | feature | 描述一条数据用的那几个数 |
| 极坐标 (R, θ) | R 读「R」,θ 读「西塔」 | 用「离原点多远」和「朝哪个方向」描述一个点 |
| 同心环 | concentric rings | 圆心相同、半径不同的几个圆环 |
一个类比:给一盒彩色铅笔分抽屉
你有一大盒彩色铅笔,要放进几个抽屉。抽屉越多,每个抽屉里的颜色越接近,「同抽屉颜色差」就越小。
抽屉多到每支笔一个,颜色差是零,可这等于没分。所以你会看:从 2 个加到 3 个,颜色差少了一大截;从 3 个加到 4 个,只少了一点点。那就停在 3 个,这就是肘部法。
还有一种情况,抽屉再怎么摆也不对。比如你想按「笔芯软硬」分,可你只看笔杆颜色。这时候问题出在你看的东西上,得换一个特征。
类比在哪里失效:
- 铅笔的颜色只有一个维度可比。真实数据常有很多维,肘部也常常没那么明显。
- 抽屉的边界你可以随便画。K-means 的边界只能是直线。
从零讲起
1. K 在图像分割里是什么
它解决什么问题
前几页一直说「K 由人给定」,可 K 改了到底改变了什么?图像分割是最直观的例子:K 就是一张图最后剩下几种颜色。
直觉
把每个像素的颜色当成一个点,所有像素一起丢进 K-means。分完以后,每个像素换成它所属中心的颜色。
K = 2,整张图只剩两种颜色;K 越大,剩下的颜色越多,越接近原图。误差平方和就是「换颜色」造成的失真总量。
一步一步看
目标:用 K = 2 把 24 个像素的亮度分成两组,看每个像素换成组平均后丢了哪些细节。
用一张 4 行 6 列的小图,只看亮度,0 是最暗、100 是最亮。左下偏暗,右上偏亮。
-
把 24 个像素的亮度各当成一维数轴上的一个点。
-
取 K = 2 做 K-means,暗的 11 个像素一组,亮的 13 个像素一组。
-
暗组平均约 17,亮组平均约 86。
-
每个像素换成所属组的平均亮度,图里只剩 17 和 86 两种值。
-
原来的 12 和 25 现在都是 17,细节丢了,这就是失真。K 加大,细节就会一点点回来。
怎么判断
拿到一张分割结果,问一句:K 是几?
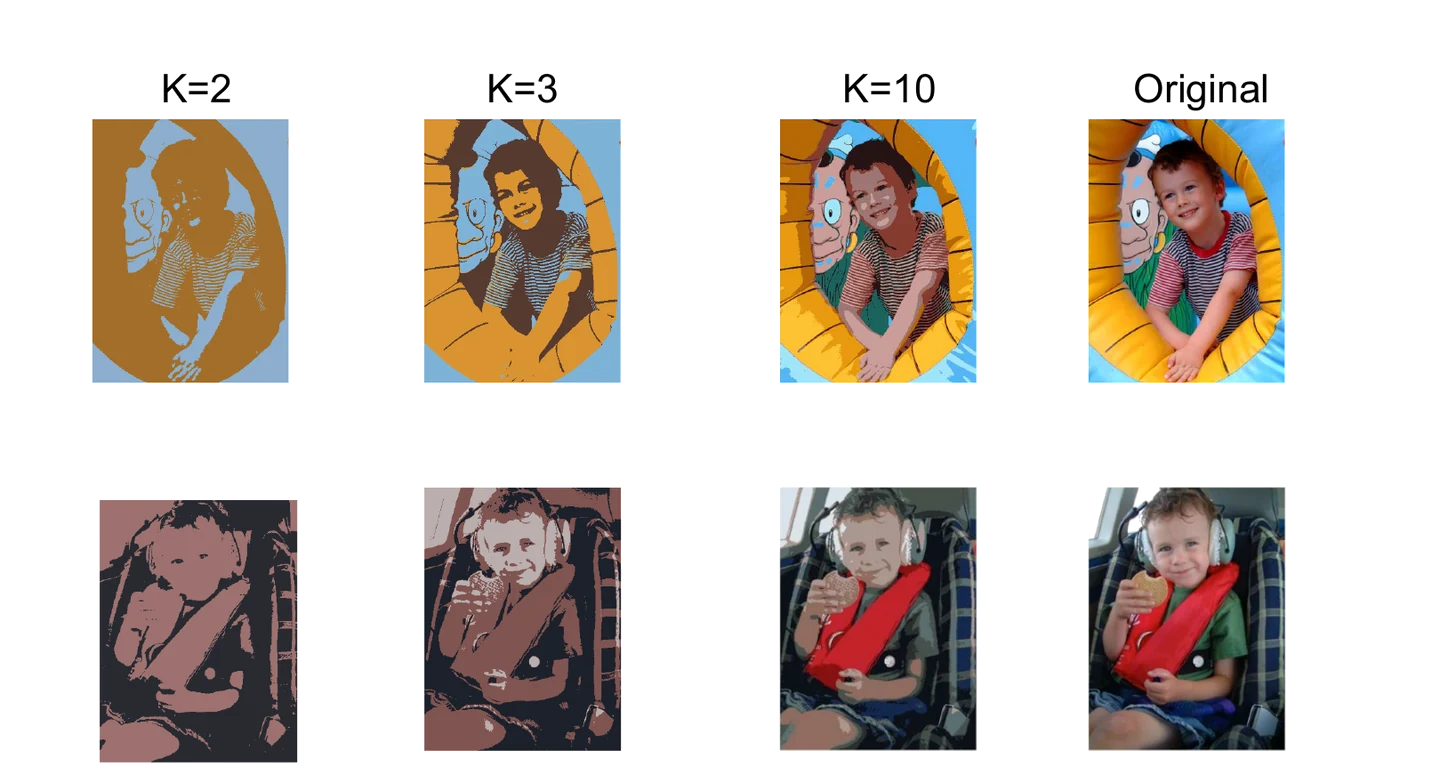
- K 小,色块少,只剩大轮廓。课件的人脸照片在 K = 2 时脸和背景难分。
- K 大,色块多,接近原图。课件在 K = 10 时衣服条纹、救生衣颜色都还原了。
K 越大失真越小,这条规律对所有数据都成立。所以「失真最小」不能拿来选 K。
常见误解
以为 K 越大分割越「好」
K 越大越接近原图,可分割的目的是把图简化成几块区域。K 大到每个像素一种颜色,等于没分割。好不好要看用途。
试一下
一行像素亮度是 10、20、80、90,K = 2。分组和替换后的值各是什么?
{10, 20} 一组,平均 15;{80, 90} 一组,平均 85。替换后是 15、15、85、85。
2. 肘部法:误差突然不怎么降了,就停
它解决什么问题
误差平方和随 K 只降不升,挑最小的会一路挑到最大。肘部法给出一个能操作的办法:看多加一个簇还值不值。
从哪来(补充)
肘部法的思路可追到 Thorndike 1953 年的工作。它也常被批评主观、不可靠:很多数据画出来根本没有明显的肘,连均匀随机的数据也会给出一条下降的曲线。所以它更适合当参考,不宜当唯一依据。出处:Wikipedia: Elbow method (clustering)。
直觉
多一个簇,每个点离最近中心只会更近或不变,所以误差一定不升。
关键是降了多少。前几个簇把真正分开的几团各自安顿好,误差大降。等每团都有了中心,再加的簇只能去切一团已经很紧的点,误差只降一点点。降幅突然变小的地方,曲线弯得像手肘。
一步一步看
目标:逐段算 K 每加 1 时误差降了多少,看降幅在哪里骤减,从而读出肘点。
课件给的曲线读数约为:K = 1 时 50,K = 2 时 24,K = 3 时 17,K = 4 时 15,之后缓慢降到 13。
-
K 从 1 到 2:降 50 − 24 = 26。
-
K 从 2 到 3:降 24 − 17 = 7。
-
K 从 3 到 4:降 17 − 15 = 2。
-
再往后每步不到 1。
-
从 3 到 4 开始,降幅骤减。曲线在 K = 3 处变平,肘点就是 K = 3。
怎么判断
列出相邻 K 之间的降幅,找「前面降得多、从这里开始降得少」的那个 K。
课件那句英文判据省略了主语,读起来像误差自己在增减。它说的是 K 的增减:在肘点往右加 K,误差只降一点点;往左减 K,误差会急剧上升。
常见误解
以为肘点是误差最小的地方
误差最小的地方永远在最大的 K。肘点是降幅突然变小的地方,是最后一个划算的 K。
以为每条曲线都有清楚的肘
不一定有。数据本来就没有明显分团时,曲线会平滑地往下走,找不出拐点。这时肘部法帮不上什么忙。
试一下
误差平方和读数:K = 1 是 100,K = 2 是 40,K = 3 是 35,K = 4 是 33。肘点在哪?
降幅是 60、5、2。从 2 到 3 开始降幅骤减,肘点是 K = 2。
3. 非凸形状必然失败,换特征可以救
它解决什么问题
前一页的「卡住」换个起点就有救。这一节讲另一种失败:数据形状本身不对,换多少次起点都没用。然后看一种出路,换特征。
直觉
L05a-2 讲过,K-means 的分界线全是直线,簇只能是凸的。
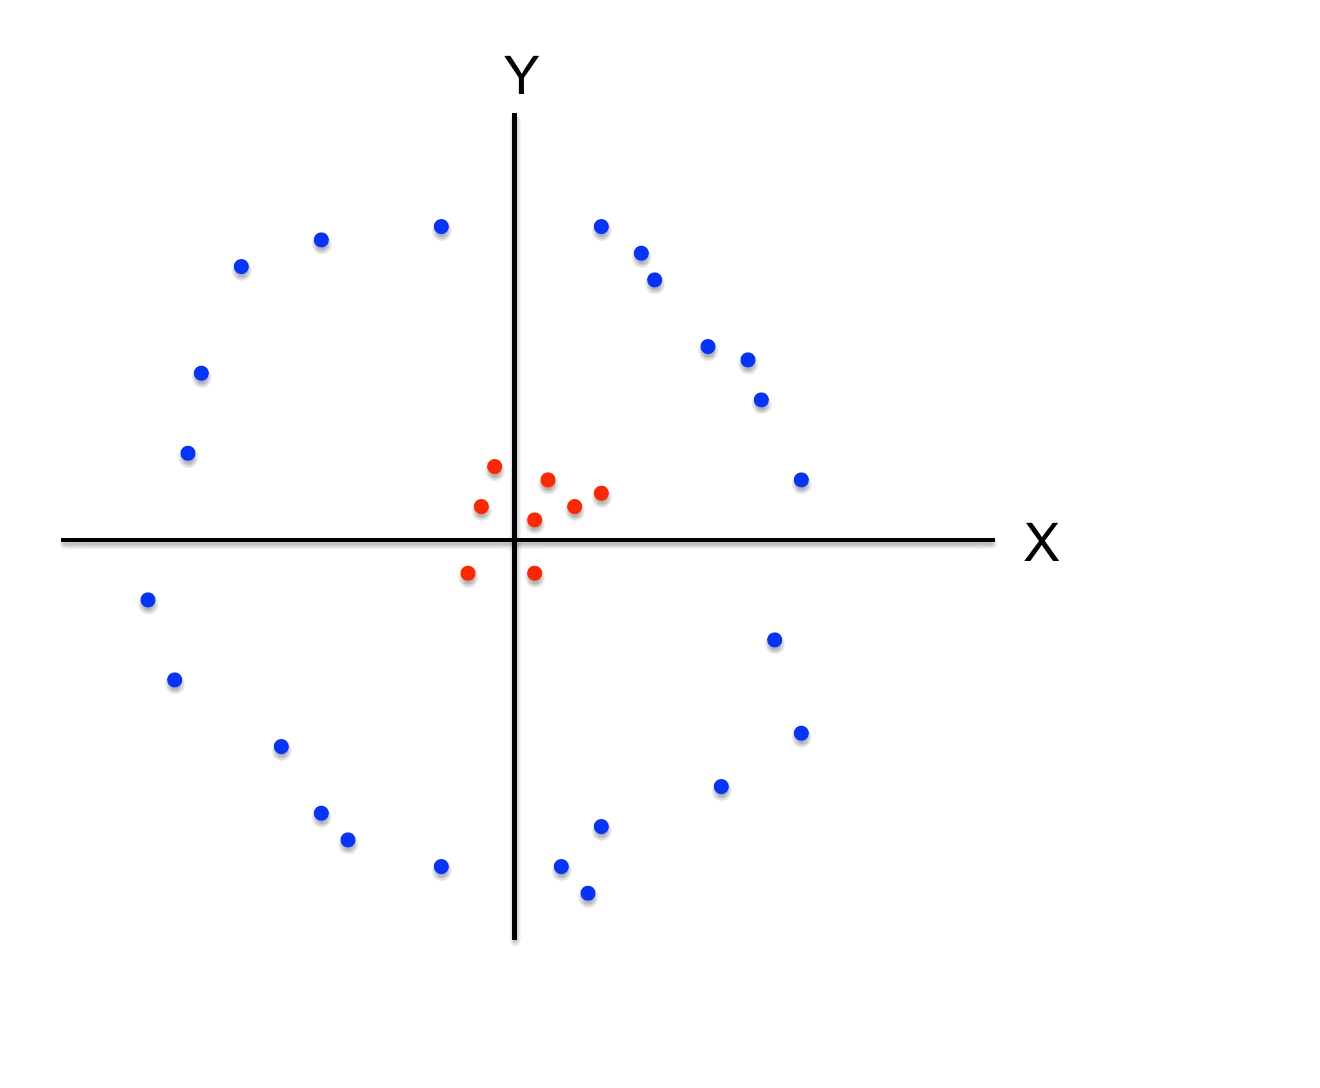
内外两个圆环,正确的分界是夹在中间的一个圆。一条直线怎么摆,都会同时切到内环和外环。
可如果不看 (X, Y),改看「离圆心多远」,内环的点都在 1 附近,外环的点都在 5 附近,一刀就能分开。
一步一步看
目标:同一个双圆环先在 (X, Y) 下跑 K-means 再换成 (R, θ),看换特征前切错、换特征后一次分对。
外圈 24 个点在半径 5 的圆上,内圈 8 个点在半径 1 的圆上。
-
在 (X, Y) 下跑 K = 2。两个中心都会落在圆心附近,一上一下。
-
分界线是两中心的垂直平分线,一条水平直线。
-
结果把整张图切成上下两半,上半个外环和上半个内环归一组,下半归另一组。
-
换特征:每个点改写成 (R, θ),R 是到圆心的距离,θ 是方向角。
-
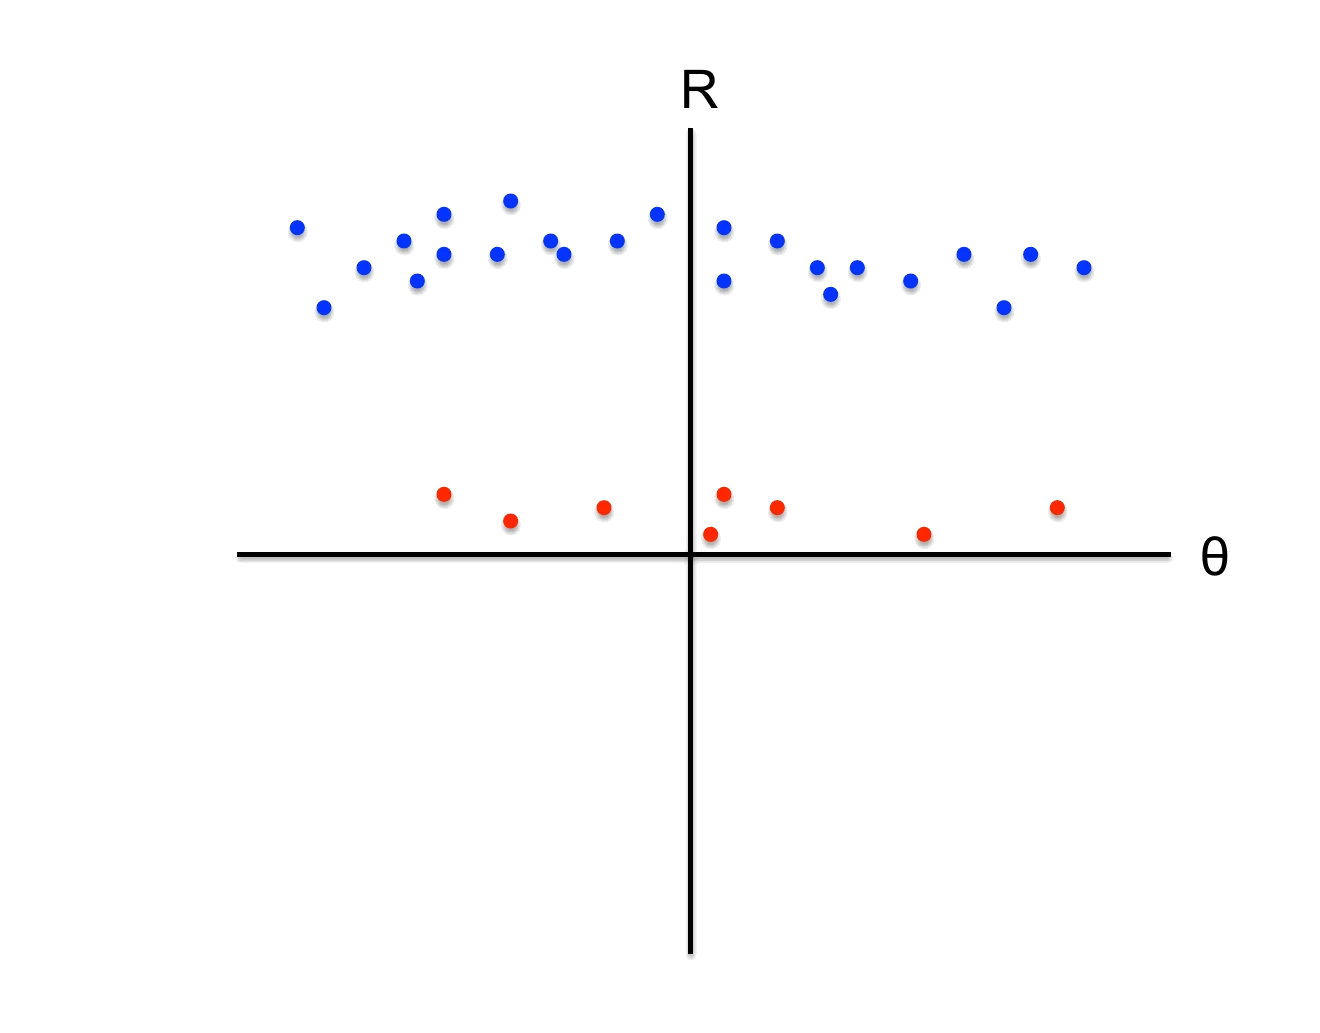
横轴画 θ,纵轴画 R。外环的点全在 R = 5 那条横带上,内环的点全在 R = 1 那条横带上。
-
两条横带各是凸的,一条水平直线就能分开。在这个新空间里跑 K-means,一次就对。
怎么判断
拿到一批数据,问两句:
- 各团之间的正确分界能用直线段拼出来吗?不能,K-means 在原特征下就会失败,换起点也没用。
- 有没有一种特征,让这些团变成能用直线分开的?有,就先换特征再跑。
课件换特征那页的标题,把 changing the features 和 distance function 并列。换成 (R, θ) 再算欧氏距离,等于在原空间里用了一个只看半径差的距离。这呼应了上一讲开头那句:聚类结果极度依赖所选的距离度量。
课件在算法分类表里还点了 Mixture of Gaussian 和 Spectral Clustering 的名,它们是处理这类形状的另一条路,本讲没展开。
常见误解
把非凸失败和「卡住」当成一回事
卡住是起点不好,换个起点或多跑几次有救。非凸失败是 K-means 只能切凸区域,换多少次起点都没用。两种失败性质不同。
以为换特征是改了数据
数据一个没动,动的是描述它的方式。同一个点,在 (X, Y) 和 (R, θ) 下是同一个点,只是「谁离谁近」的算法变了。
试一下
两个月牙左右交错地嵌在一起,K = 2,K-means 会怎么分?
会用一条斜的直线把画面切成两半,两个月牙都被切断。月牙是非凸的,正确分界是曲线,直线拼不出来。
把它们串起来
K 是人给的。在图像分割里,K 就是最后剩几种颜色,K 越大越接近原图,误差平方和越小。
正因为误差随 K 只降不升,不能挑最小的。肘部法看降幅:前面降得多、从某处开始降得少,那个拐点就是 K。课件的曲线拐在 K = 3。
K 选对了,形状不对照样失败。K-means 的分界只能是直线,内外圆环、月牙这种非凸形状必然被切断,换起点也没用。出路之一是换特征:圆环换成 (R, θ),就变成两条可被一刀分开的横带。
到这里,K-means 怎么跑、在压什么、为什么会停、哪里会失败,都讲完了。
课件里的坑
- [读图提醒] 图像分割那三页是同一张幻灯片的三次动画,K=2、K=3、K=10 是累加揭示的,只看第一页会以为只演示了 K=2(p.24–26)
- [课件留白] 肘部法那句英文描述省略了主语,说的是 K 的增减,不是误差自己在增减(p.29)
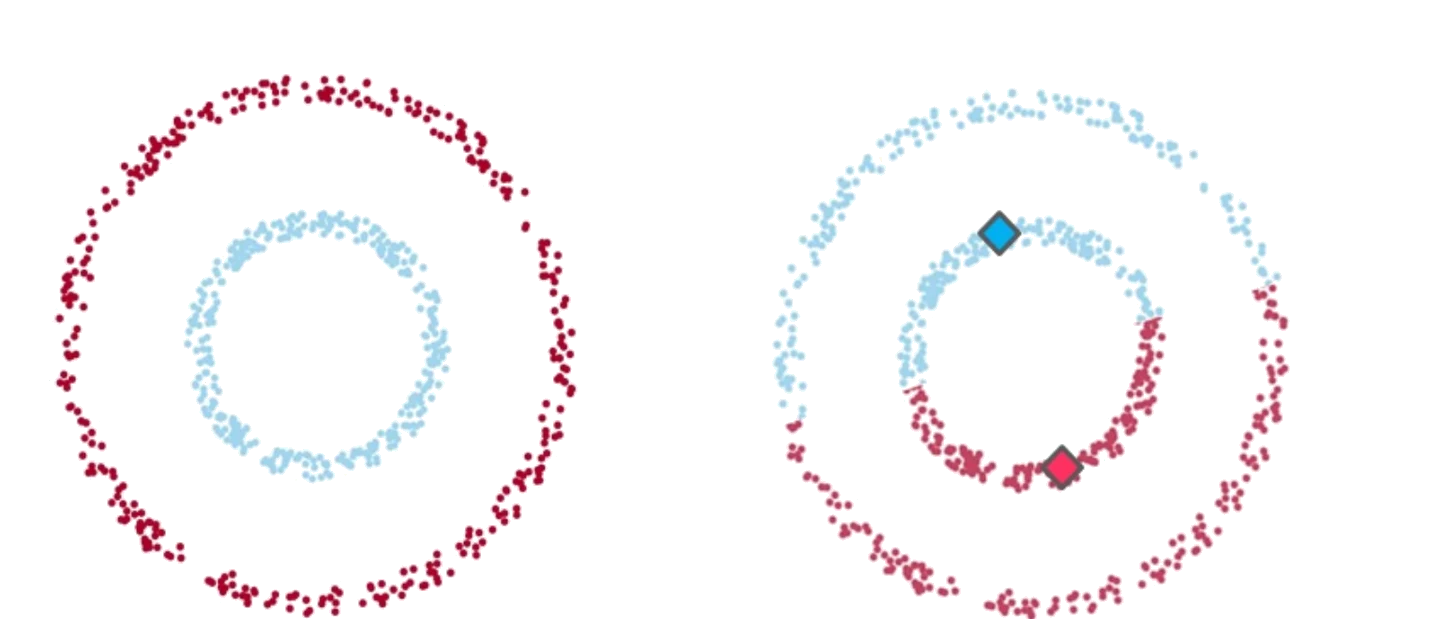
- [读图提醒] 同心环和月牙两页是纯图页,没有任何文字。左图是真实结构,右图是 K-means 的输出,菱形是收敛后的中心(p.32–33)
- [前后照应] 换特征那页把「changing the features」和「distance function」并列,换成 (R, θ) 再算欧氏距离,等于在原空间里用了一个只看半径差的距离(p.31、p.6)
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,在纸上把 50、24、17、15 这几个读数的降幅算一遍、指出肘点;再过一遍课件例题,每题先说结论再看解答;最后做变式题,自己扫一遍 K。
必背
- 误差平方和随 K 单调不增,不能靠它最小来选 K,要用肘部法取下降幅度突然变小的那个 K,课件示例曲线肘点在 K=3
- K-means 处理不了非凸簇:同心环、两个月牙上都会沿一条直线把每个簇切断
- 出路之一是换特征或换距离函数:同心环数据从 (X, Y) 换到 (R, θ),两类就变成两条可被直线分开的横带
- 图像分割用 K-means 把每个像素换成所属中心的颜色,K=2、3、10 越大越接近原图,误差平方和就是压缩带来的失真总量
- 卡在局部最优换个初值有救,非凸形状的失败换多少次初值都没用,两种失败性质不同
课件例题
例 1(课件 p.24–26):同一张照片用 K=2、3、10 分割,结果怎么变?
题面:最右一列是两张原图(人脸特写、穿救生衣的人),左边三列依次是 K=2、K=3、K=10 的分割结果。
提示
K 在这里等于最后剩几种颜色。
解答
K=2 只剩两种颜色,脸和背景难分;K=3 头发、五官轮廓出来了;K=10 接近原图,衣服条纹、救生衣的颜色都还原了。K 越大,每个像素离替换色越近,失真越小。所以 K 不能靠「失真最小」来选。
例 2(课件 p.29):给定误差平方和随 K 的曲线,K 选几?
见下方完整例题。
例 3(课件 p.30):外圈一个大圆环、圆心附近一小团,K-means 能分对吗?
题面:约 25 个蓝点均匀分布在大圆环上,约 8 个红点密集聚在原点附近。
提示
正确的分界是什么形状?K-means 的分界又只能是什么形状?
解答
分不对。分配步的边界是两个中心的垂直平分线,是直线;正确边界是一个圆,直线拼不出来。最好的结果是把整张图切成两半。这种失败换多少次初值都没用。
例 4(课件 p.31):同一批点换成 (R, θ) 画,为什么就能分了?
题面:纵轴改成 R(到原点的距离),横轴改成 θ(角度)。蓝点全落在 R 较大的一条水平带上,红点全落在 R 接近 0 的一条水平带上。
提示
数据变了没有?变的是什么?
解答
数据没动,动的是描述数据的特征。两类在新空间里变成上下两条横带,横带是凸的,一条水平直线就能分开,K-means 一次就能做对。这对应课件开头那句「聚类结果极度依赖所选的距离度量」。
例 5(课件 p.32–33):同心环和两个月牙,K-means 的输出各是什么样?
题面:两页都是左右两幅图,左边是真实结构,右边是 K-means 的输出。
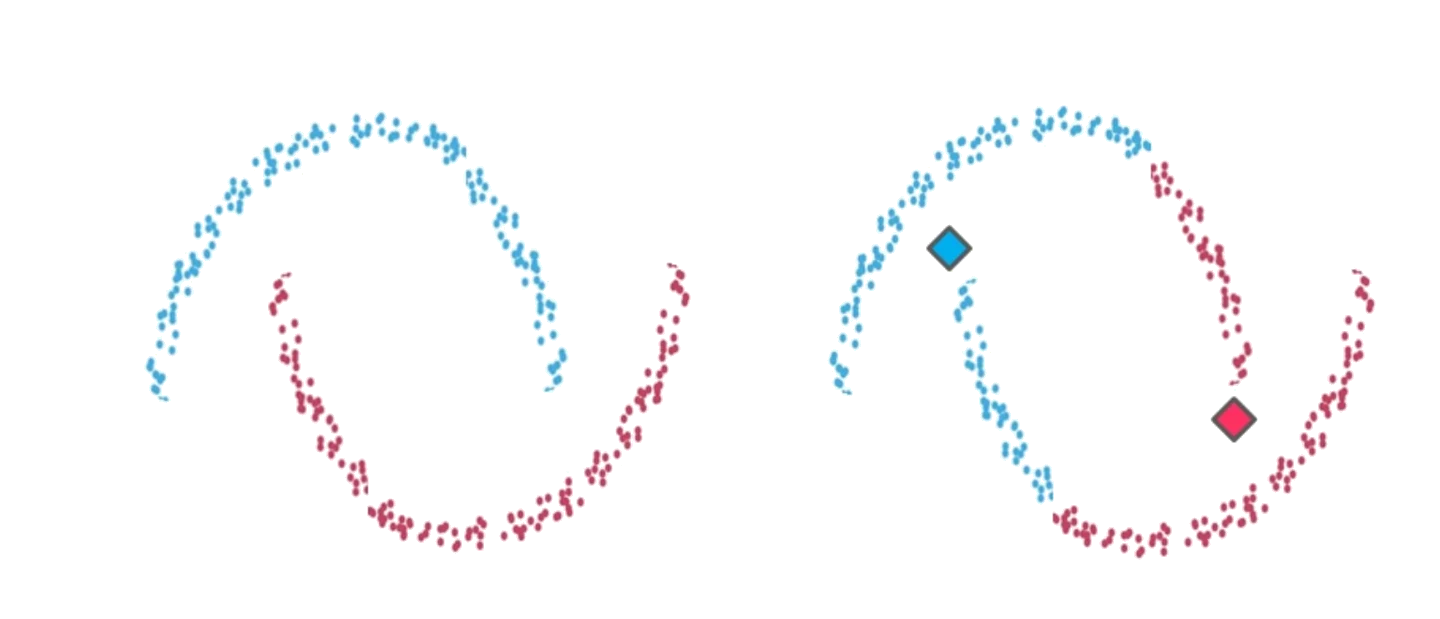
提示
两种形状有什么共同点?K-means 的簇只能是什么形状?
解答
同心环:沿一条近似水平的直线切成上下两半,每个簇都同时含内环和外环的点,两个中心挤在内环附近。月牙:按左右重新分,一条斜线把两个月牙都切断。根因相同,月牙和圆环都是非凸形状,K-means 只能切出凸的区域。
完整例题
课件 p.29 的肘部曲线是本讲唯一给了数字的选 K 例子。
题面:横轴是簇数 K = 1…10,纵轴是误差平方和。曲线读数约为:K=1 时 50,K=2 时 24,K=3 时 17,K=4 时 15,K=5 时 14,K=6 时 13.5,之后缓慢降到 13。(a) 为什么不直接选误差最小的 K?(b) 算出相邻 K 之间的下降量,按肘部法选 K。(c) 用课件那句英文判据描述你选的 K。
- (a) 误差随 K 单调不增:多一个簇,每个点离最近中心只会更近或不变,所以误差只降不升。K 等于样本数时每个点自成一簇,误差为零。按「误差最小」选,永远选到最大的 K,分组就没意义了。
- (b) 算下降量:1 → 2 降 50 − 24 = 26;2 → 3 降 24 − 17 = 7;3 → 4 降 17 − 15 = 2;4 → 5 降 1;之后每步不到 1。
- (b) 找拐点:前两步降得多,从 3 → 4 开始骤减到 2 以下,曲线在 K=3 处突然变平。肘点是 K=3,和课件虚线标注的 Optimal number of clusters 一致。
- (c) 套英文判据:在 K=3 处,再增大 K 误差只下降很少(降 2),减小 K 误差会急剧上升(升 7)。主语是 K 的增减,不是误差自己在增减。
答题格式:先写 (a) 的理由,再列出下降量,最后指出拐点。只写「肘点在 3」不写下降量,看不出是算出来的还是从图上抄的虚线。
变式题(先自己做)
变式 1(自编情境):一维数据 x = 0, 1, 2, 10, 11, 12, 20, 21, 22。(a) 分别求 K = 1、2、3、4 时最好划分下的误差平方和(K=2 取 {0,1,2} 和其余六个;K=4 取 {0,1}、{2}、{10,11,12}、{20,21,22})。(b) 按肘部法 K 选几?
变式 2(改编自课件 p.30–31):外圈半径为 5 的环上有两点 A = (5, 0)、B = (−5, 0),内圈半径为 1 的点 C = (0.6, 0.8)。(a) 在 (X, Y) 下用欧氏距离的平方,A 离 B 近还是离 C 近?(b) 只用半径 R 作特征,用 R 之差的平方,A 离谁近?(c) 两个结果说明了什么?
提示
变式 1:每组先求平均,再把组内各点到平均的差平方加起来。变式 2:(a) 坐标分别相减再平方相加;(b) A、B 的 R 都是 5,C 的 R 是 1;(c) 想想课件换特征那页的标题。
判分点与答案(非官方评分标准)
判分点:① 变式 1 四个误差都写出计算;② 指出肘点及理由;③ 变式 2 两种度量下结论相反并说明原因。
变式 1 (a):K=1,平均 11,误差 = 121+100+81+1+0+1+81+100+121 = 606。K=2,{0,1,2} 平均 1,误差 2;其余六个平均 16,误差 36+25+16+16+25+36 = 154;合计 156。K=3,每团误差 2,合计 6。K=4,{0,1} 误差 0.5,{2} 误差 0,另两团各 2,合计 4.5。
(b) 下降量依次是 450、150、1.5。3 → 4 只降 1.5,曲线在 K=3 处变平,选 K = 3,数据本身就是三团。
变式 2 (a):A 到 B 是 10² + 0 = 100;A 到 C 是 4.4² + 0.8² = 19.36 + 0.64 = 20。A 离内圈的 C 更近。
(b) A 到 B 是 (5 − 5)² = 0,A 到 C 是 (5 − 1)² = 16。A 离同在外圈的 B 更近。
(c) 数据一个没动,换了特征,「谁和谁像」就反过来了。直角坐标下外圈的点可能离内圈更近,所以 K-means 会把内外环混在一起;只看半径时,同一个环上的点距离为零,分组就对了。这就是课件把换特征和换距离函数写在一起的原因。
闪卡自测
1. 选 K 那页的 sum of squared errors 和目标函数是什么关系?
是同一个量。目标函数 Σᵢ Σ_{x∈Cᵢ} |x − μᵢ|² 就是 SSE,肘部法画的正是它随 K 的变化(p.23、p.29)。
2. 为什么不能用「误差平方和最小」来选 K?肘部法怎么判?
误差随 K 单调不增,K 等于样本数时为零,这个判据会把 K 推到最大。肘部法取下降幅度突然变小的那个 K,课件曲线在 K=3(p.29)。
3. 同心环数据上 K-means 会分成什么样?根因在算法的哪一步?
沿一条直线把图切成上下两半,每个簇里都同时含内环和外环的点。根因在分配步的 Voronoi 划分只能切出直线边界,而正确边界是一个圆(p.30、p.32)。
4. 换成极坐标 (R, θ) 之后为什么就对了?这对应课件的哪句话?
内外环在 R 上分成两条水平带,带是凸的、可被直线分开。对应「聚类结果极度依赖所选的距离度量」,数据没动,动的是描述数据的特征(p.6、p.31)。
5. 给出两个 K-means 不适用的数据形状,各该换什么思路?
同心环:换特征到 (R, θ),或换 Spectral Clustering。两个月牙:同样是非凸,换 Spectral Clustering。椭圆形的簇可以考虑 Mixture of Gaussian(p.7、p.30–33)。
6. 「卡住」和「非凸失败」有什么区别?
卡住是初始化的问题,换个初值或多次随机初始化有救;非凸失败是 K-means 只能切出凸区域的假设不成立,换多少次初值都没用(p.28、p.30)。
下一讲
K-means 这一讲到此结束。下一讲 L06a 回到有标签的学习,从逻辑回归一路走到神经网络。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。