L06c 激活函数:为什么要非线性,为什么换掉 sigmoid
先看清没有激活函数时多层网络会塌成一层;再用斜率表解释 sigmoid 让深层网络训不动的原因;最后对比 tanh、ReLU、Leaky ReLU 和 softplus 各改了什么。
一句话版
每个节点加权求和之后都要过一个非线性函数,叫激活函数。没有它,叠多少层都等于一层。
sigmoid 是最早的选择,但它两端太平,斜率最大只有 0.25,网络一深,训练信号传到前面几层就几乎没了。于是有了以 0 为中心的 tanh,以及正半轴不会变平的 ReLU 家族。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 激活函数 | activation function | 每个节点加权求和后再过的那个非线性函数 |
| 饱和 | saturation | 函数两端变平,斜率接近 0,输入再变输出也几乎不动 |
| 梯度消失 | vanishing gradient | 反向传播时导数层层相乘,传到前面几层时小到学不动 |
| tanh | hyperbolic tangent,读「坦 h」 | 值域 −1 到 1 的 S 形函数 |
| ReLU | rectified linear unit,读「瑞路」 | 负数变 0、正数原样输出 |
| softplus | 读「软加」 | ReLU 的平滑版,拐角被磨圆 |
一个类比:传话游戏
一排人传话,每个人都只能把听到的音量压低一点再传给下一个。
如果每人都把音量压到原来的四分之一,传两个人还听得见,传到第五个人就只剩耳语了。sigmoid 网络的训练信号就是这样从输出往前传的:每过一层,最多只剩四分之一。
换成 ReLU,相当于每个人要么原样传话,要么干脆不传。原样传的那条线上,音量一点不减。
类比在哪里失效:
- 传话游戏里音量只会减小。激活函数的导数乘上权重后,也可能放大,课件只讲了变小这一边。
- 传话的每个人压低的比例是固定的。sigmoid 的斜率取决于这个节点当时的输入,越偏离 0 越小。
从零讲起
1. 为什么一定要有非线性
它解决什么问题
上一页的网络每层都是「加权求和 + 非线性」。如果把非线性那一步拿掉,只留加权求和,网络会变成什么样?弄清这一点,才知道激活函数到底在干什么。
直觉
加权求和是线性运算,就是乘一个数再加起来。乘 2 再乘 3,等于直接乘 6。两层线性叠起来,还是一层线性。
所以没有激活函数,一百层网络和一层逻辑回归能画的边界一样,都是直线。隐藏层的价值全靠激活函数的非线性。
一步一步看
目标:把两层只做线性的函数代到一起,看它们合成一层,插进 sigmoid 后才化不回去。
-
第 1 层只做线性:h = 2x。
-
第 2 层也只做线性:y = 3h。
-
把第 1 层代进第 2 层:y = 3 × 2x = 6x。
-
换成矩阵也一样:W₂(W₁x) = (W₂W₁)x,两层权重矩阵乘起来就是一个新矩阵。
-
在两层之间插一个 sigmoid:y = 3σ(2x),就再也化不成「某个数乘 x」了。
怎么判断
问一句:把这一层拿掉,能不能用前后两层合并出一模一样的结果?
- 能,说明这一层是线性的,白叠。
- 不能,说明这一层带了非线性,叠上去有用。
意思是:判断一个网络是否真的「深」,要看每层之间有没有非线性函数,光看层数没用。
常见误解
以为多加几层线性层能让模型更强
不能。多层线性叠起来始终等价于一层线性,能表示的函数完全一样。
以为激活函数只是把输出压到 0 到 1
压范围是 sigmoid 的特点,ReLU 就不压正半轴。激活函数的核心作用是提供非线性。
试一下
第 1 层 h = 2x + 1,第 2 层 y = −h + 4,都没有激活函数。能合成一层吗?合成后是什么?
能。y = −(2x + 1) + 4 = −2x + 3,仍是一层线性。
2. sigmoid 的饱和与梯度消失
它解决什么问题
课件说 logistic 在现代神经网络里用得不多。原因要从它的斜率说起:训练时,梯度要从输出一层层传回去,每过一层都要乘一次激活函数的导数。导数小,梯度就越乘越小。
直觉
sigmoid 中间陡、两头平。平的地方斜率接近 0,这叫饱和:输入再怎么变,输出几乎不动,误差信号也传不过去。
就算在最陡的 z = 0 处,斜率也只有 0.25。每过一层最多保留四分之一,五层之后只剩不到千分之一。
一步一步看
目标:把 sigmoid 的导数一层层连乘,看即使每层都在最陡处,梯度过五层也几乎消失。
-
先看 sigmoid 的导数曲线:最高点在 z = 0,值 0.25;z = 2 降到 0.105,z = 4 只剩 0.0177。
-
假设每层都在最陡的位置,每层导数都是 0.25。传过 1 层剩 0.25,2 层剩 0.0625,3 层剩 0.0156。
-
传过 4 层剩 0.0039,5 层剩 0.00098。
-
这还是最好的情况。节点只要稍微偏离 0,比如 z = 2,每层就只剩 0.105,三层后是 0.105³ ≈ 0.00116。
-
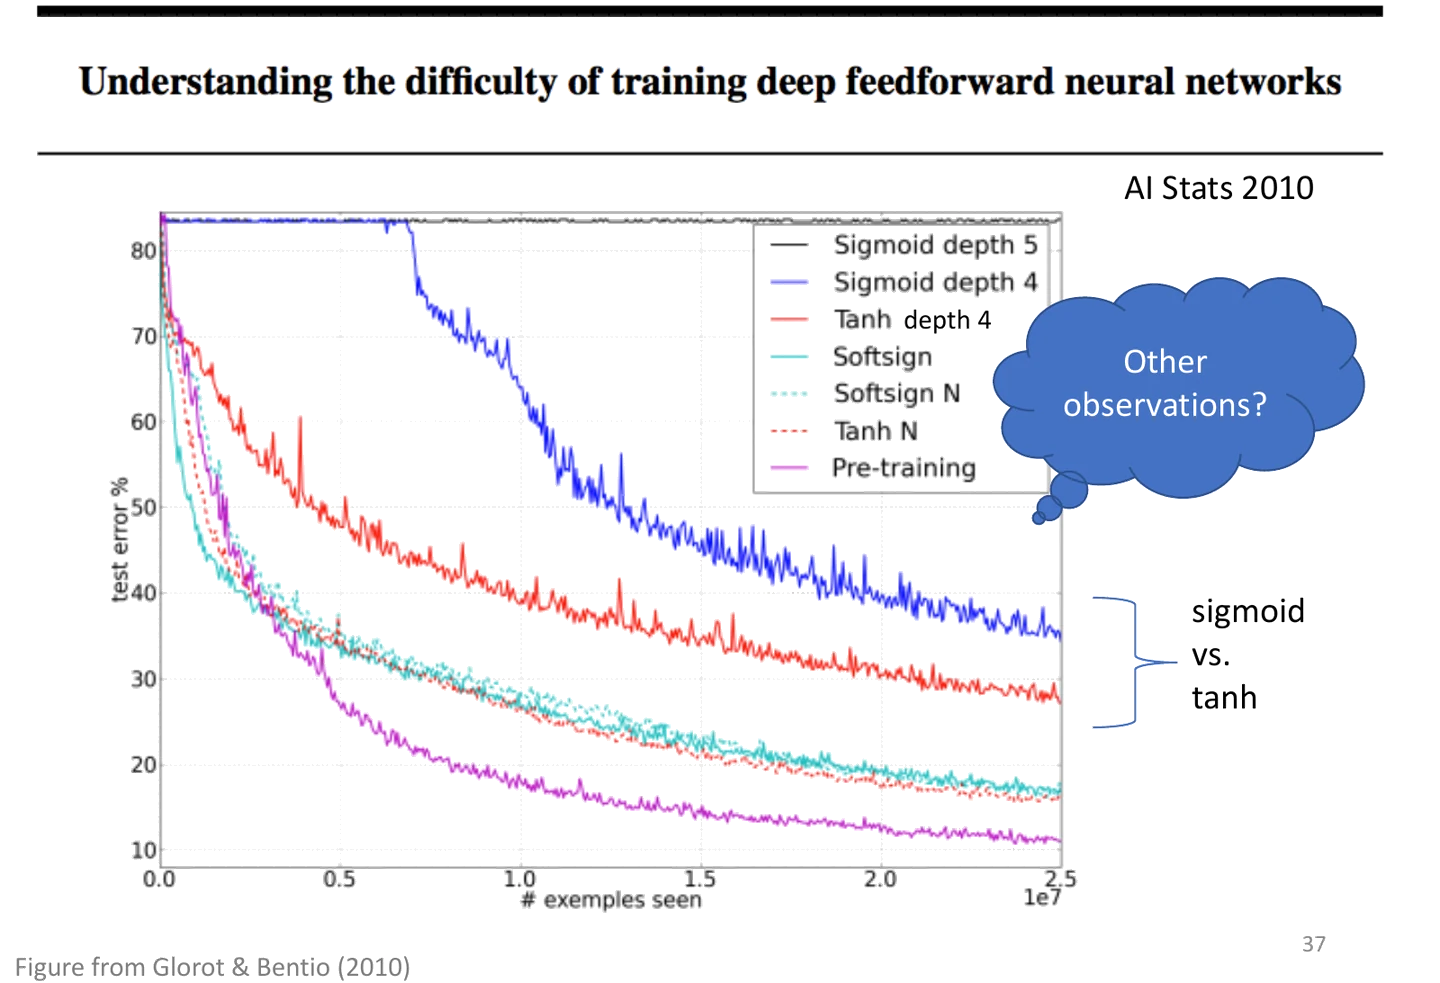
课件引用的 Glorot & Bengio 2010 实验印证了这一点:
| 曲线 | 结尾测试错误率(读图估计) |
|---|---|
| Sigmoid depth 5 | 始终约 83%,基本没学到东西 |
| Sigmoid depth 4 | 约 35%,前期很长一段停在约 83% |
| Tanh depth 4 | 约 27% |
| Softsign 类 | 约 16–17% |
| Pre-training | 约 11% |
怎么算
σ′(z) = σ(z)(1 − σ(z)) ≤ 0.25
意思是:sigmoid 的斜率等于输出乘「1 减输出」,输出是 0.5 时乘积最大,为 0.25。
n 层 sigmoid 叠起来,梯度里会出现 n 个这样的因子相乘:
σ′(a₁) × σ′(a₂) × … × σ′(aₙ) ≤ 0.25ⁿ
意思是:层数每加 1,梯度的上限就再乘 0.25,按指数速度变小。前面几层收到的梯度太小,权重几乎不更新,网络就训不动。这就是梯度消失。
常见误解
以为梯度消失是因为学习率太小
学习率对所有层一视同仁。梯度消失是前面几层的梯度比后面几层小几个数量级,调大学习率会让后面几层先走过头。
以为 4 层 sigmoid 也完全训不动
课件的图里 4 层 sigmoid 前期很长一段停在约 83%,后来才开始下降,结尾约 35%。训得动,但慢且差。5 层才是基本没学到东西。
试一下
每层的 sigmoid 节点都恰好在 z = 1 处,斜率约 0.1966。只看激活函数的因子,传过 2 层后剩多少?
0.1966 × 0.1966 ≈ 0.0387,已经不到原来的二十五分之一。
3. tanh:以 0 为中心的 S 形
它解决什么问题
sigmoid 的输出全是正数,范围 0 到 1。课件给的第一个替代是 tanh,它的形状和 sigmoid 一样,值域换成了 −1 到 1。
直觉
把 sigmoid 横向压扁一半、纵向拉长两倍、再整体下移 1,就得到 tanh。
输出有正有负,以 0 为中心。中段比 sigmoid 陡,两端同样会饱和。
一步一步看
目标:算出 tanh(1) 再用 sigmoid 换算核对,看 tanh 过原点、在 0 处的斜率是 sigmoid 的 4 倍。
-
取 z = 1,按定义算 tanh(1) = 0.7616。
-
用 sigmoid 换算:2σ(2) − 1 = 2 × 0.8808 − 1 = 0.7616,两边相等。
-
看 z = 0:sigmoid 输出 0.5,tanh 输出 0。tanh 过原点。
-
看斜率:tanh 在 z = 0 处的斜率是 1,是 sigmoid 的 4 倍。
怎么算
tanh(z) = 2σ(2z) − 1
意思是:先把 z 乘 2 喂给 sigmoid,结果乘 2 再减 1。σ 的范围 0 到 1,乘 2 减 1 后变成 −1 到 1。
tanh′(z) = 1 − tanh²(z)
意思是:斜率等于 1 减输出的平方。z = 0 时输出 0,斜率 1;z = 1 时输出 0.7616,斜率 1 − 0.7616² ≈ 0.42。离开 0 越远,斜率同样迅速变小。
常见误解
以为 tanh 解决了饱和问题
没有。tanh 两端同样变平。它比 sigmoid 好在以 0 为中心、中段更陡,课件实验里同为 4 层时错误率更低,但深了一样难训。
试一下
已知 σ(1) ≈ 0.7311,用换算式求 tanh(0.5)。
tanh(0.5) = 2σ(1) − 1 = 2 × 0.7311 − 1 = 0.4622,直接算 tanh(0.5) ≈ 0.4621,差在四舍五入。
4. ReLU 家族:正半轴不会变平
它解决什么问题
sigmoid 和 tanh 两端都饱和。课件给的第二个替代是 ReLU,常用于视觉任务。它在正半轴是一条斜率为 1 的直线,永远不会变平。
直觉
ReLU 是一个开关:输入是负数就输出 0,输入是正数就原样输出。
正半轴的导数恒为 1,梯度传过去一点不减。代价是负半轴导数为 0,那里的梯度完全断掉。Leaky ReLU 给负半轴留一点小斜率,softplus 把拐角磨圆。
一步一步看
目标:代入正负 z 比较 ReLU、Leaky ReLU 和 softplus 的输出与导数,看它们在负半轴各怎样处理。
-
ReLU:max(0, z)。z = 2 输出 2,z = −3 输出 0。
-
Leaky ReLU:max(0.1z, z)。z = 2 输出 2,z = −3 输出 −0.3。
-
softplus:log(exp(z) + 1)。z = −6 输出 0.0025,z = 0 输出 0.6931,z = 2 输出 2.1269。
-
把三者的导数放进一张表:
| 函数 | z > 0 的导数 | z < 0 的导数 |
|---|---|---|
| ReLU | 1 | 0 |
| Leaky ReLU | 1 | 0.1 |
| softplus | 接近 1 | 接近 0,但不为 0 |
怎么算
ReLU(z) = max(0, z)
意思是:取 0 和 z 里大的那个。用在神经元上就是 max(0, w·x + b)。
Leaky ReLU(z) = max(0.1z, z)
意思是:z 为正时 z 比 0.1z 大,输出 z;z 为负时 0.1z 比 z 大,输出 0.1z。
softplus(x) = log(exp(x) + 1)
意思是:x 很负时 exp(x) 接近 0,结果接近 log 1 = 0;x 很正时 exp(x) 远大于 1,结果接近 x。它和 ReLU 只在 0 附近不同。
课件列的三条优点:在一端不饱和;让输出稀疏,很多单元输出 0;缓解梯度消失。
常见误解
以为 ReLU 两边都不饱和
只有正半轴不饱和。负半轴导数是 0,一个节点如果总是收到负输入,它的梯度一直是 0,权重就不再更新。Leaky ReLU 就是为了给负半轴留一点梯度。
拿课件 ReLU 图上的粗线读数
那条粗线是叠加的手绘示意,整体下移、不过原点,不能读数。按 max(0, z) 的定义读细线。
试一下
z = −2 时,ReLU、Leaky ReLU、softplus 各输出多少?哪个的梯度为 0?
ReLU 输出 0,梯度 0。Leaky ReLU 输出 0.1 × (−2) = −0.2,梯度 0.1。softplus = log(e^(−2) + 1) ≈ 0.1269,梯度等于 σ(−2) ≈ 0.1192(softplus 的导数正是 sigmoid)。只有 ReLU 的梯度为 0。
把它们串起来
激活函数给每一层加上非线性,没有它,多层线性叠起来还是一层线性。
最早的选择 sigmoid 两端饱和,斜率最大只有 0.25。反向传播时每过一层要乘一次导数,层一多梯度就按指数变小,前面几层学不动,这就是梯度消失。课件引用的实验里,5 层 sigmoid 网络错误率一直停在约 83%。
tanh 把值域换成 −1 到 1、以 0 为中心,中段更陡,同为 4 层时比 sigmoid 好,但两端仍饱和。ReLU 在正半轴导数恒为 1,梯度传过去不减,所以成了视觉任务的常用选择。它的负半轴导数为 0,Leaky ReLU 留了 0.1 的斜率,softplus 把拐角磨圆。
激活函数解决「训不训得动」。训练时到底优化什么、往哪个方向调,是下一页的内容。
课件里的坑
- [读图提醒] ReLU 图上叠了一条手绘示意的粗线,整体下移到 y ≈ −1.8 处折起,不过原点,不能拿来读数(p.40)
- [读图提醒] 实验图底部作者印成「Glorot & Bentio」,应为 Bengio;横轴「exemples」即 examples(p.39)
- [读图提醒] 实验图里带 N 的变体具体指什么课件没有说明,考试按「sigmoid 深了训不动、tanh 更好」作答即可(p.39)
- [符号提醒] sigmoid 定义式里的「≡」在 PDF 文字层显示为「º」,是字体编码问题(p.37)
- [概念提醒] 课件说 ReLU 类「在一端不饱和」,指的是正半轴,负半轴导数仍是 0(p.41)
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写四个激活函数的公式和值域;再写出 sigmoid 最大斜率 0.25,推出 5 层后剩多少;然后背一遍实验图里 83%、35%、27% 三个数各对应哪条曲线;最后做变式题。
必背
- 没有非线性激活函数,多层加权求和叠起来仍是一个线性函数,和一层没有区别
- sigmoid 两端饱和,斜率最大只有 0.25;反向传播每层乘一次导数,层一深梯度就消失
- Glorot & Bengio 2010:5 层 sigmoid 网络错误率始终约 83%;同为 4 层时 tanh 约 27%,好过 sigmoid 的约 35%
- tanh(z) = 2σ(2z) − 1,值域 [−1, 1],以 0 为中心,两端同样饱和
- ReLU = max(0, z),正半轴导数恒为 1、不饱和;负半轴输出 0、导数 0
- Leaky ReLU = max(0.1z, z),负半轴保留 0.1 的斜率;softplus = log(exp(x) + 1) 是 ReLU 的平滑版
课件例题
例 1(课件 p.37):为什么网络里一定要有非线性激活函数?
题面:感知机单元先算 net = Σᵢ wᵢxᵢ,再算 o = σ(net);课件说除 sigmoid 外还有其他非线性函数。
提示
想一想:把 σ 拿掉,两层叠起来是什么。
解答
只做加权求和的话,W₂(W₁x) = (W₂W₁)x,多层叠起来仍是一个线性函数,和一层没有区别。隐藏层的价值全靠激活函数的非线性。
例 2(课件 p.38):tanh 和 sigmoid 是什么关系?
题面:课件说 tanh 形状和 logistic 一样,只是值域平移到 [−1, +1]。
提示
试着用 σ(2z) 表示 tanh(z),再取 z = 1 验算。
解答
tanh(z) = 2σ(2z) − 1,取 z = 1 两边都等于 0.7616。它把 sigmoid 横向压缩一半、纵向拉伸两倍再下移 1,以 0 为中心,输出有正有负,两端同样会饱和。
例 3(课件 p.39):Glorot & Bengio 2010 的错误率曲线说明了什么?
题面:横轴是已看过的训练样本数,纵轴是测试错误率。曲线有 Sigmoid depth 5、Sigmoid depth 4、Tanh depth 4、Softsign、Pre-training 等。
提示
先比较同一种函数不同深度,再比较同一深度不同函数,最后用 sigmoid 的最大斜率解释原因。
解答
Sigmoid depth 5 始终约 83%,基本没学到东西;Sigmoid depth 4 结尾约 35%,Tanh depth 4 约 27%,同样 4 层 tanh 更好;Softsign 类约 16–17%,Pre-training 约 11%。原因是 sigmoid 斜率最大只有 0.25,层层相乘后梯度消失。
例 4(课件 p.40–41):ReLU、Leaky ReLU、softplus 各在负半轴怎样?
题面:ReLU = max(0, z),Leaky ReLU = max(0.1z, z),softplus = log(exp(x) + 1)。
提示
分别代入一个负数,比如 z = −3 或 z = −6,再看导数。
解答
ReLU 负半轴输出 0、导数 0。Leaky ReLU 在 z = −3 时输出 −0.3,负半轴导数 0.1,梯度不会完全变成 0。softplus(−6) = 0.0025,贴近 0 但不为 0,是 ReLU 的平滑版。课件列的优点:一端不饱和、输出稀疏、缓解梯度消失。
完整例题
题面(自编情境,用课件 p.19 和 p.40 的函数):一个 3 层隐藏层的网络,每层一个节点,三个节点的加权和都是 z = 2。只看激活函数贡献的导数因子,分别求用 sigmoid 和用 ReLU 时,梯度从输出传到第 1 层要乘的总因子,并说明差别。
解法:
- sigmoid 在 z = 2 处:σ(2) = 0.8808,斜率 σ(1 − σ) = 0.8808 × 0.1192 = 0.105。
- 三层各乘一次:0.105 × 0.105 × 0.105 ≈ 0.00116。
- ReLU 在 z = 2 处:z > 0,导数为 1。
- 三层各乘一次:1 × 1 × 1 = 1。
- 比较:sigmoid 网络传到第 1 层的梯度只剩约千分之一,ReLU 网络原样传到。层数越多差距越大。
要点:梯度消失来自「激活函数导数」这个因子层层相乘。sigmoid 的这个因子最大 0.25,ReLU 在正半轴恒为 1。
答题格式:先写单层导数(带公式和数值),再写 n 层连乘,最后一句话比较。
变式题(先自己做)
(1) 自编情境:每层 sigmoid 都在最陡处,至少要几层,导数因子的连乘就小于 0.001? (2) 改编自课件 p.38:已知 σ(2) ≈ 0.8808,求 tanh(1),并求 tanh 在 z = 1 处的斜率。 (3) 改编自课件 p.40:z = −5 和 z = 5 时,ReLU 和 Leaky ReLU 的输出与导数各是多少?
提示
(1) 最陡处每层 0.25,逐个乘。(2) 用 tanh(z) = 2σ(2z) − 1 和 tanh′ = 1 − tanh²。(3) 正负两边分开代入定义。
判分点与答案(非官方评分标准)
判分点:① 写出所用公式;② 数值正确;③ (3) 说清导数在负半轴的差别。
(1) 0.25⁴ = 0.0039,0.25⁵ = 0.00098。至少 5 层。
(2) tanh(1) = 2 × 0.8808 − 1 = 0.7616;斜率 = 1 − 0.7616² ≈ 0.42。
(3) z = 5:ReLU 和 Leaky ReLU 都输出 5,导数都是 1。z = −5:ReLU 输出 0、导数 0;Leaky ReLU 输出 0.1 × (−5) = −0.5、导数 0.1。
闪卡自测
1. 为什么必须有非线性激活函数?
只有加权求和的话,多层叠起来仍是一个线性函数,和一层没有区别(p.37)。
2. sigmoid 的最大斜率是多少?在哪里取到?
0.25,在 z = 0 处(p.19)。
3. 什么是梯度消失?
反向传播时激活函数的导数层层相乘,sigmoid 每层最多乘 0.25,传到前面几层时梯度太小,权重几乎不更新(p.39)。
4. 课件实验里 5 层 sigmoid 和 4 层 tanh 的结尾错误率大约是多少?
5 层 sigmoid 始终约 83%;4 层 tanh 约 27%(p.39)。
5. tanh 和 sigmoid 的换算式?值域?
tanh(z) = 2σ(2z) − 1,值域 [−1, 1](p.38)。
6. ReLU 的「不饱和」指哪一侧?
正半轴,导数恒为 1;负半轴导数为 0(p.40–41)。
7. Leaky ReLU 在 z = −3 时输出多少?
max(0.1 × (−3), −3) = −0.3(p.40)。
8. softplus 和 ReLU 有什么关系?
softplus = log(exp(x) + 1) 是 ReLU 的平滑版:x 很负时贴近 0,x 很正时贴近 x,只在 0 附近不同(p.41)。
下一讲
激活函数决定网络训不训得动。训练时优化哪个目标、往哪个方向调参数,见 L06d。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。