L06b 隐藏层与前向传播:把几个神经元叠起来
用课件的 Titanic 例子看懂隐藏层:每个隐藏节点是一个逻辑回归,输出层再把它们合起来。再拿一个 2-2-1 小网络逐帧算一遍前向传播,最后看深层网络每层在学什么。
一句话版
隐藏层就是并排放几个逻辑回归,每个都看同一组输入、各自算出一个数;输出层再把这几个数当成新的输入,做一次逻辑回归。
从输入出发,一层一层先加权求和、再过激活函数,算到输出,这个过程叫前向传播。网络做预测时只做前向传播。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 隐藏层 | hidden layer | 夹在输入和输出之间的那层节点,训练数据里看不到它们的「正确答案」 |
| 隐藏节点 | hidden unit | 隐藏层里的一个神经元,本身就是一个逻辑回归 |
| α | 读「阿尔法」 | 课件里输入层到隐藏层的权重 |
| β | 读「贝塔」 | 课件里隐藏层到输出层的权重 |
| 前向传播 | forward propagation | 从输入往输出逐层算值 |
| 深度 / 宽度 | depth / width | 隐藏层有几层 / 每层有几个节点 |
一个类比:两位初审加一位终审
一份申请先交给两位初审。一位只盯年龄和舱位,另一位更在意性别。两人看的是同一份材料,各自打一个分。
终审不看原始材料,只看两位初审的分数,按自己对两人的信任程度加权,给出最后结论。
初审就是隐藏节点,终审就是输出节点。每个人做的事都一样:加权打分,再换算成概率。
类比在哪里失效:
- 真的初审知道自己该盯什么。隐藏节点没人告诉它,盯什么是训练时从数据里学出来的。
- 真的终审可以否决初审。输出节点只会加权求和再过 sigmoid,没有别的判断。
从零讲起
1. 隐藏层:并排放几个逻辑回归
它解决什么问题
上一页讲过,一个逻辑回归神经元的分界线 θᵀx = 0 是直的。有些数据用一条直线分不开,最出名的例子是异或(XOR):两个输入相同判 0,不同判 1,平面上四个点交叉摆放,怎么画直线都分不对。要画出弯的分界线,就得把几个神经元组合起来。
从哪来(补充)
1957 年 Frank Rosenblatt 做出感知机,引起很大期待。1969 年 Marvin Minsky 和 Seymour Papert 出版《Perceptrons》一书。书里指出,单层感知机学不会 XOR 这类线性不可分的函数。多层网络能解决这个问题,但当时没有好办法训练多层网络,这一方向冷了很多年,直到反向传播被广泛使用。
直觉
隐藏层里的每个节点都在问一个自己的问题。课件的 Titanic 例子里,一个隐藏节点主要看年龄和舱位,另一个主要看性别。输出节点再问:这两个答案合起来,这位乘客生还的可能有多大?
每个隐藏节点是一条直线。几条直线的结果再组合一次,就能拼出弯的边界。
一步一步看
目标:读 Titanic 网络两个隐藏节点的权重,看它们各侧重哪些输入,输出层又怎样把两者再组合一次。
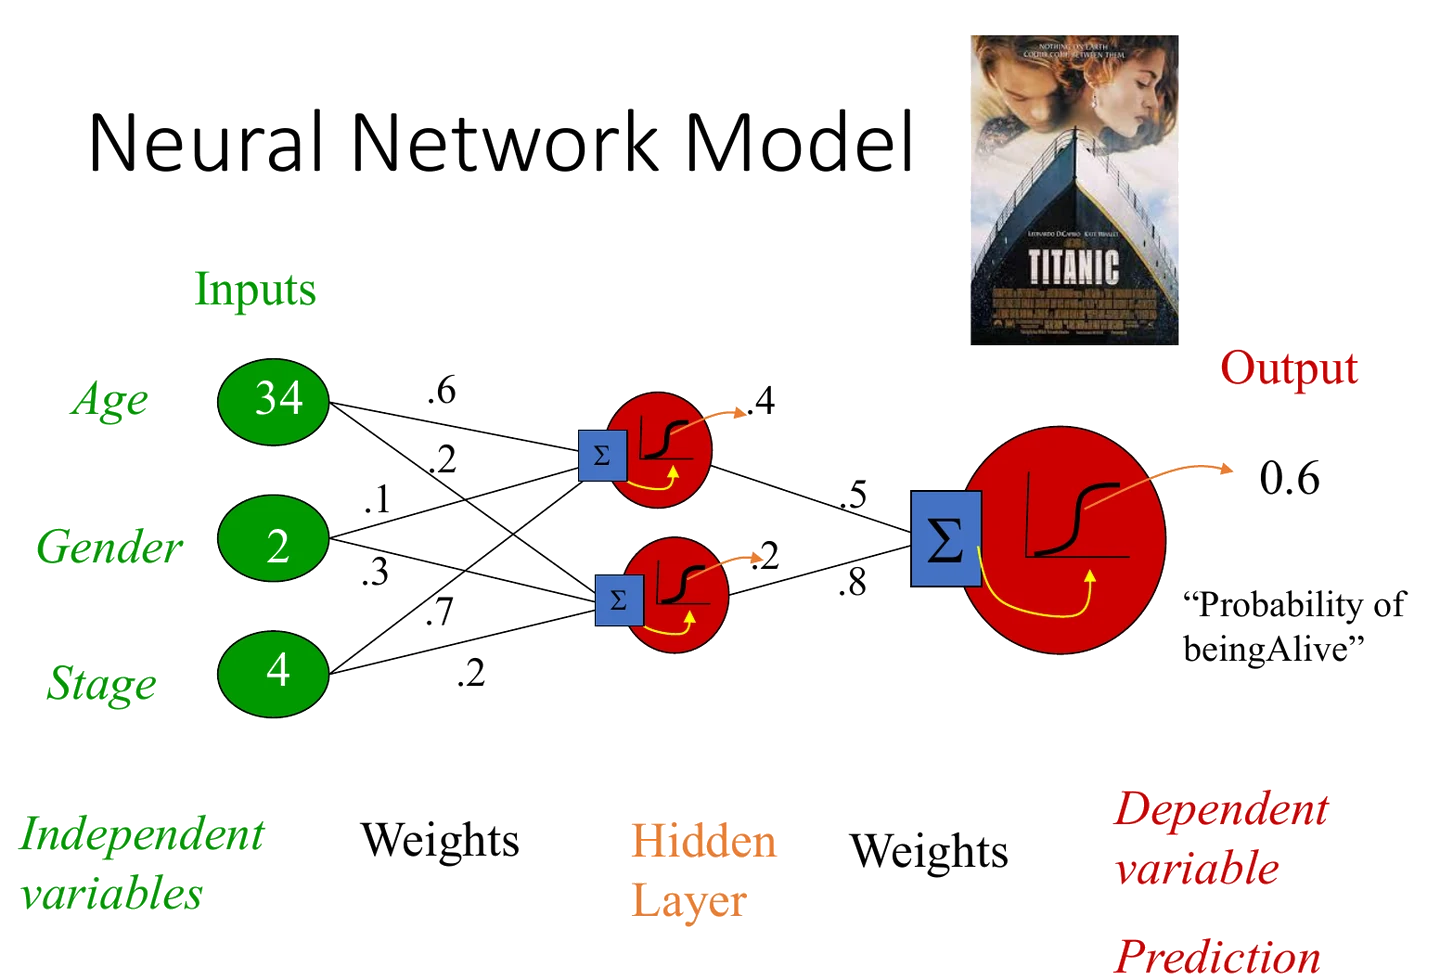
拿课件的 Titanic 网络走一遍。输入 Age = 34、Gender = 2、Stage = 4(舱位等级)。
-
先看网络长什么样:三个输入各连一条边到两个隐藏节点 H1、H2,边上写着权重;H1、H2 再各连一条边到输出。
-
看 H1 的三条入边:Age .6、Gender .1、Stage .7。性别的权重最小,课件把 H1 标成「Age and Stage」。
-
看 H2 的三条入边:Age .2、Gender .3、Stage .2。性别的权重最大,课件标成「Gender」。
-
图上标的 H1 输出是 .4,H2 是 .2。输出层用它们算:
| 步骤 | 计算 | 结果 |
|---|---|---|
| 加权求和 | b = .5 × .4 + .8 × .2 = 0.2 + 0.16 | 0.36 |
| 过 sigmoid | y = σ(0.36) | 0.589 |
| 读结果 | 四舍五入 | 0.6,即生还概率 |
- 输出层对两个逻辑回归的结果再做一次逻辑回归,课件叫「Couple the effects」,把两种效应耦合起来。
怎么算
单个隐藏节点 j:aⱼ = Σᵢ αⱼᵢ xᵢ,zⱼ = σ(aⱼ)
意思是:隐藏节点 j 先把所有输入乘上「到自己的那组权重」再加起来,然后过 sigmoid。它和上一页的逻辑回归是同一个公式,只是权重换成了 α。
输出节点:b = Σⱼ βⱼ zⱼ,y = σ(b)
意思是:输出节点把所有隐藏节点的输出当成新的输入,再做一次逻辑回归。
Titanic 的隐藏层值可以自己核一下。H1 的加权和 = .6 × 34 + .1 × 2 + .7 × 4 = 23.4,σ(23.4) ≈ 1。 H2 的加权和 = .2 × 34 + .3 × 2 + .2 × 4 = 8.2,σ(8.2) ≈ 0.9997。
这两个数和图上的 .4、.2 对不上,图上也没画偏置。所以课件的隐藏值是示意,考这张图时按「输出层用给定的 .4、.2 计算」来答。
常见误解
以为按权重大小就能读出隐藏节点在看什么
只有输入已经标准化到相近范围时才成立。Titanic 里 Age = 34 远大于 Gender = 2。 H2 的年龄贡献 .2 × 34 = 6.8,性别贡献 .3 × 2 = 0.6。 原始量纲下 H2 其实主要被年龄推动。课件按权重读成「Gender」,是默认输入已标准化。
以为隐藏节点越多越好
节点多了能拼出更复杂的边界,但参数也多,更容易把训练数据背下来。每层放几个节点是设计选择之一,靠试验决定,后面第 3 个概念会讲。
试一下
Titanic 网络里,如果把输出层的两个权重对调成 H1 → .8、H2 → .5,隐藏输出仍是 .4 和 .2,生还概率变高还是变低?
b = .8 × .4 + .5 × .2 = 0.32 + 0.1 = 0.42,比原来的 0.36 大。 σ(0.42) ≈ 0.6035,比 0.589 略高。原因是更大的权重给了输出更大的 H1。
2. 前向传播:五步公式逐帧算
它解决什么问题
Titanic 例子说明了思路,但它的隐藏值是示意的,没法从头算到尾。课件把计算写成五步公式。这一节用一个数字都能算出来的小网络,把五步一帧一帧走完,后面讲反向传播时还会用这个网络。
直觉
前向传播就是排队交作业:输入层先交给隐藏层,隐藏层每个节点算完交给输出层,输出层算完交出预测。每一层只用上一层交来的数,不回头看。
每一层做的事都一样,两个动作:先加权求和,再过激活函数。
一步一步看
目标:在 2-2-1 网络上按五步公式逐帧算到损失,看每一层都是先加权求和、再过 sigmoid。
网络是 2-2-1:两个输入、两个隐藏节点、一个输出。权重 α₁₁ = 0.1、α₁₂ = 0.2(到 z₁),α₂₁ = 0.3、α₂₂ = −0.1(到 z₂),β₁ = 0.5、β₂ = −0.4。为了好算,不设偏置。
-
准备:输入 x = (1, 2),这个样本的真实标签 y* = 1。
-
(B) 隐藏层加权求和:a₁ = 0.1 × 1 + 0.2 × 2 = 0.5,a₂ = 0.3 × 1 + (−0.1) × 2 = 0.1。
-
(C) 隐藏层过 sigmoid:z₁ = σ(0.5) = 0.6225,z₂ = σ(0.1) = 0.525。
-
(D) 输出层加权求和:b = 0.5 × 0.6225 + (−0.4) × 0.525 = 0.3113 − 0.21 = 0.1012。
-
(E) 输出过 sigmoid:y = σ(0.1012) = 0.5253。和 y* = 1 比,交叉熵 J = −log 0.5253 = 0.6438。
怎么算
课件的五步,自下而上:
- (A) 输入:给定 xᵢ,对所有 i
- (B) 隐藏层线性部分:aⱼ = Σᵢ₌₀ᴹ αⱼᵢ xᵢ
- (C) 隐藏层非线性部分:zⱼ = σ(aⱼ) = 1/(1 + exp(−aⱼ))
- (D) 输出层线性部分:b = Σⱼ₌₀ᴰ βⱼ zⱼ
- (E) 输出:y = σ(b) = 1/(1 + exp(−b))
意思是:每一层都是「加权求和 + 非线性」两个动作,(B)(C) 是隐藏层的两个动作,(D)(E) 是输出层的两个动作。
两个细节要记住。αⱼᵢ 的下标顺序是「到 j、从 i」:第一个下标是隐藏节点,第二个是输入。求和从 0 开始,表示有一个恒为 1 的 x₀ 和 z₀,对应的 αⱼ₀ 和 β₀ 就是偏置。上面的小网络为了好算没有偏置,等于把它们都设成 0。
常见误解
把 αⱼᵢ 读成「从 j 到 i」
顺序反了。αⱼᵢ 是从输入 i 到隐藏节点 j 的权重,上面例子的 α₁₂ = 0.2 是 x₂ 连到 z₁ 的那条边。反向传播求梯度时下标顺序一错,整列都会算错。
以为前向传播会更新权重
前向传播只算值,权重原封不动。更新权重要先反向传播求出梯度,再走一步梯度下降,这在本讲最后一页。
试一下
同一个 2-2-1 网络,只把输出权重改成 β₁ = 0.5、β₂ = 0.4(第二个变正)。其他不变,b 和 y 变成多少?
隐藏层不受影响,z₁ = 0.6225、z₂ = 0.525。b = 0.5 × 0.6225 + 0.4 × 0.525 = 0.3113 + 0.21 = 0.5212。 y = σ(0.5212) ≈ 0.6274,比原来的 0.5253 高,离真实标签 1 更近。
3. 深层网络:一层一层往上抽象
它解决什么问题
一层隐藏层能拼出弯的边界。图像、语音这类数据更复杂,课件接着把隐藏层加到两层、三层。需要搞清楚多出来的层在学什么,以及设计一个网络要做哪些决定。
直觉
每多一层,就是把上一层的输出当作下一层的输入,再做一遍「加权求和 + 非线性」。公式完全一样,只是重复更多次。
课件引用的人脸识别例子说明了层数的意义:底层学到边缘,中间层把边缘拼成眼睛、鼻子,高层把部件拼成整张脸。没人规定每层该学什么,这些特征是在训练时自己长出来的。
一步一步看
目标:从像素到整张脸逐层看深层网络学到什么,再看设计网络时要定哪四项选择。
-
输入层:一张人脸图片的像素值。
-
第 1 层隐藏层:学到各种方向的边缘。
-
第 2 层隐藏层:学到物体部件,比如眼睛、鼻子。
-
第 3 层隐藏层:学到完整物体,即整张脸的模式。
-
设计网络时要做的四项选择:
| 选择 | 含义 | 本讲哪里讲 |
|---|---|---|
| 隐藏层数 | 深度 | 本节 |
| 每层单元数 | 宽度,三层可以各不相同 | 本节 |
| 激活函数类型 | 非线性用哪个 | 下一页 |
| 目标函数形式 | 损失怎么算 | 再下一页 |
怎么判断
拿到一个网络结构,按两个问题判断它的「形状」:
- 输入和输出之间有几层隐藏层?这是深度。课件先画了两层的,再画了三层的。
- 每层有几个节点?这是宽度。三层那张图分别记作 a₁…a_D、b₁…b_E、c₁…c_F,D、E、F 可以不同。
这四项选择没有公式能直接算出最优值。课件配图写着「Alchemy!」(炼金术),意思是很大程度上靠经验和试验。
常见误解
以为设计者给每层指定了要学的特征
课件原话是我们并不知道「正确的」抽象层次是什么,所以让模型自己去找。边缘、部件这些是事后把每层可视化才看到的。
以为层数越多一定越好
层数一多会更难训练。下一页会看到,用 sigmoid 做激活时,5 层网络在课件的实验里几乎训练不动。
试一下
一个网络有 2 个输入、3 个隐藏节点、1 个输出,隐藏层和输出层都带偏置。一共有多少个权重?
隐藏层每个节点连 2 个输入加 1 个偏置,共 3 个权重,3 个节点是 3 × 3 = 9 个。输出节点连 3 个隐藏节点加 1 个偏置,共 4 个。合计 9 + 4 = 13 个。
把它们串起来
一个逻辑回归神经元只能画直线。把几个神经元并排放成隐藏层,每个隐藏节点各自是一个逻辑回归,看同一组输入、抓住输入的一种组合;输出层再把隐藏层的结果做一次逻辑回归,把几种效应合起来。Titanic 例子里一个隐藏节点主要看年龄和舱位,另一个主要看性别。
整个计算从输入往输出逐层进行,每层都是「加权求和 + 非线性」,这就是前向传播。课件把它写成 (A) 到 (E) 五步,输入到隐藏层的权重叫 α,隐藏层到输出的权重叫 β,下标从 0 开始的那一项是偏置。
层数继续加深,网络就逐层学到越来越抽象的特征:边缘、部件、物体。深度、宽度、激活函数、目标函数是四项设计选择。下一页讲其中的激活函数。
课件里的坑
- [读图提醒] Titanic 的隐藏值 .4、.2 用图上的输入和权重算不出来,按输入算加权和为 23.4 和 8.2,图上也没画偏置,隐藏值应是示意(p.22)
- [读图提醒] 最后一张 Titanic 图把 Gender 的输入印成 1,前三张都是 2;按 1 算结论不变(p.25)
- [读图提醒] 「主要看性别」只是按权重大小读,原始输入量纲不同,比较权重前要先假定输入已标准化(p.24)
- [符号提醒] 多分类那页的网络图把隐藏节点标成 a₁…a_D,与五步公式里的 z 记号不同,指的是同一层(p.30)
- [页码提醒] 课件中段页脚比 PDF 页序小 2,本页引用的页码都按 PDF 页序(p.33)
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写五步公式和 α 下标的含义;再拿 2-2-1 小网络从输入算到 y,不看答案对一遍;然后做 Titanic 完整例题;最后过一遍四项设计选择。
必背
- 隐藏层的每个节点都是一个逻辑回归;输出层再对隐藏层的结果做一次逻辑回归,把几种效应耦合起来
- Titanic 输出层:b = .5 × .4 + .8 × .2 = 0.36,σ(0.36) = 0.589,约等于图上的 0.6
- 前向传播五步:(A) 给定 xᵢ;(B) aⱼ = Σᵢ αⱼᵢxᵢ;(C) zⱼ = σ(aⱼ);(D) b = Σⱼ βⱼzⱼ;(E) y = σ(b)
- αⱼᵢ 的下标是「到 j、从 i」;求和从 0 开始,x₀ = z₀ = 1,对应的 αⱼ₀、β₀ 就是偏置
- 深层网络逐层抽象:像素 → 边缘 → 物体部件 → 完整物体,各层学成什么由数据决定
- 四项设计选择:隐藏层数(深度)、每层单元数(宽度)、激活函数类型、目标函数形式
课件例题
例 1(课件 p.22–25):Titanic 网络怎么算出生还概率 0.6?两个隐藏节点各在看什么?
题面:输入 Age = 34、Gender = 2、Stage = 4;H1 权重 .6、.1、.7,H2 权重 .2、.3、.2;图上标 H1 = .4、H2 = .2;输出权重 .5、.8。
提示
输出层只用 .4 和 .2 两个数;读隐藏节点时看哪条入边的权重最大。
解答
b = .5 × .4 + .8 × .2 = 0.36,σ(0.36) = 0.589 ≈ 0.6。H1 的 Age .6、Stage .7 大,主要看年龄和舱位;H2 的 Gender .3 最大,课件读成主要看性别。输出层把两者耦合。完整过程和隐藏值的核对见下方完整例题。
例 2(课件 p.28):写出单隐藏层网络的五步前向公式,说明求和从 0 开始的意思。
题面:输入层 x₁…x_M,隐藏层 z₁…z_D,输出 y,权重 α、β。
提示
隐藏层两个动作、输出层两个动作,再加一个给定输入。
解答
(A) 给定 xᵢ;(B) aⱼ = Σᵢ₌₀ᴹ αⱼᵢxᵢ;(C) zⱼ = σ(aⱼ);(D) b = Σⱼ₌₀ᴰ βⱼzⱼ;(E) y = σ(b)。求和从 0 开始,表示有恒为 1 的 x₀、z₀,对应的 αⱼ₀、β₀ 就是偏置。
例 3(课件 p.33–35):深层网络各层学到什么?设计网络要做哪几项选择?
题面:人脸识别例子,输入像素经三层隐藏层;配图写着「Alchemy!」。
提示
按「像素之后」的顺序说三层;设计选择有四项,两项讲结构,两项讲函数。
解答
第 1 层学到边缘,第 2 层学到物体部件(眼睛、鼻子),第 3 层学到完整物体。课件说我们不知道正确的抽象层次,所以让模型自己找。四项设计选择是隐藏层数、每层单元数、激活函数类型、目标函数形式,靠经验和试验,没有公式。
完整例题
题面(课件 p.22–25):预测 Titanic 乘客是否生还。输入 Age = 34、Gender = 2、Stage = 4。到隐藏节点 H1 的权重是 Age .6、Gender .1、Stage .7;到 H2 的是 Age .2、Gender .3、Stage .2。图上标的隐藏输出 H1 = .4、H2 = .2;输出节点权重 H1 → .5、H2 → .8。(a) 算出输出概率。(b) 按权重解读 H1、H2 各主要反映什么。(c) 从输入出发能算出 .4 和 .2 吗?
解法:
- (a) 输出层加权求和:b = .5 × .4 + .8 × .2 = 0.2 + 0.16 = 0.36。
- (a) 过 sigmoid:y = σ(0.36) = 0.589,四舍五入为 0.6,即生还概率。
- (b) H1:Age .6、Stage .7 大,Gender 只有 .1,课件标「Age and Stage」,是一个以年龄和舱位为主的逻辑回归。
- (b) H2:Gender 的 .3 最大,课件标「Gender」。输出层对两个逻辑回归的结果再做一次逻辑回归,把两种效应耦合起来。
- (c) H1 的加权和 = .6 × 34 + .1 × 2 + .7 × 4 = 23.4,σ(23.4) ≈ 1;H2 = .2 × 34 + .3 × 2 + .2 × 4 = 8.2,σ(8.2) ≈ 0.9997。算不出 .4 和 .2,图上也没画偏置,隐藏值应是示意。
- (b) 的补充:按权重读只在输入已标准化时成立。Age 的贡献 .2 × 34 = 6.8 远大于 Gender 的 .3 × 2 = 0.6。
要点:输出层的计算和逻辑回归完全一样,只是输入换成了隐藏层的输出。
答题格式:考这张图时写「b = … = 0.36,y = σ(0.36) = 0.589 ≈ 0.6」。若题目要求从输入算起,先指出缺偏置或需要标准化,这一点课件没有说明,属于推断。
变式题(先自己做)
(1) 改编自课件 p.22:Titanic 网络结构和输出权重不变(H1 → .5、H2 → .8),另一位乘客的隐藏输出是 H1 = .9、H2 = .1。求生还概率,比原题高还是低? (2) 自编情境:用本页的 2-2-1 网络(α₁₁ = 0.1、α₁₂ = 0.2、α₂₁ = 0.3、α₂₂ = −0.1、β₁ = 0.5、β₂ = −0.4,不设偏置),输入改成 x = (2, 1),求 a、z、b、y。 (3) 自编情境:一个网络有 4 个输入、5 个隐藏节点、3 个输出,各层都带偏置。α 和 β 各有多少个?
提示
(1) 只做输出层两步。(2) 按 (B)(C)(D)(E) 的顺序,注意 α₁₂ 是 x₂ 连到 z₁。(3) 每个节点的权重数 = 上一层节点数 + 1。
判分点与答案(非官方评分标准)
判分点:① 每层先写加权和再写 sigmoid;② α 下标读对;③ 偏置要算进权重个数。
(1) b = .5 × .9 + .8 × .1 = 0.45 + 0.08 = 0.53,y = σ(0.53) = 0.6295,比原题 0.589 高。H1 大了很多,而 H1 和 H2 的输出权重都为正。
(2) a₁ = 0.1 × 2 + 0.2 × 1 = 0.4,a₂ = 0.3 × 2 + (−0.1) × 1 = 0.5;z₁ = σ(0.4) = 0.5987,z₂ = σ(0.5) = 0.6225;b = 0.5 × 0.5987 + (−0.4) × 0.6225 = 0.0504;y = σ(0.0504) = 0.5126。
(3) α:5 个隐藏节点 × (4 + 1) = 25 个。β:3 个输出 × (5 + 1) = 18 个。
闪卡自测
1. 隐藏层的一个节点本质上是什么?
一个逻辑回归:对输入加权求和,再过 sigmoid(p.23–24)。
2. Titanic 网络的输出 0.6 是怎么来的?
σ(.5 × .4 + .8 × .2) = σ(0.36) = 0.589,四舍五入为 0.6(p.22)。
3. 「Couple the effects」指什么?
输出层对两个隐藏节点的结果再做一次逻辑回归,把「年龄与舱位」和「性别」两种效应合起来(p.25)。
4. 五步公式里 (B) 和 (D) 分别是什么?
(B) 隐藏层线性部分 aⱼ = Σᵢ αⱼᵢxᵢ;(D) 输出层线性部分 b = Σⱼ βⱼzⱼ(p.28)。
5. αⱼᵢ 两个下标的顺序是什么?
到 j、从 i:第一个下标是隐藏节点,第二个是输入(p.28)。
6. 求和下标从 0 开始意味着什么?
有恒为 1 的 x₀、z₀,对应的 αⱼ₀、β₀ 是偏置(p.28)。
7. 人脸识别网络三层隐藏层各学到什么?
边缘、物体部件、完整物体(p.34)。
8. 网络设计的四项选择是什么?
隐藏层数、每层单元数、激活函数类型、目标函数形式(p.35)。
下一讲
每层的「非线性」用哪个函数,决定了深层网络能不能训练起来。下一页讲 sigmoid、tanh 和 ReLU 家族,见 L06c。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。