L04a-2 回归与分类:看 y 是一个数还是一个类别
从零讲监督学习的两种任务:y 是连续数值叫回归,y 是有限个类别叫分类;再用 x 和 y 读懂图像、检测、翻译、排序、推荐这些应用,以及不改参数的上下文学习。
一句话版
监督学习的答案 y 有两种样子:一个数,或者一个类别。是一个数就叫回归,是一个类别就叫分类。
上一页 L04a-1 讲了样本、特征 x、标签 y,那一页的 y 是「是不是垃圾邮件」。这一页换几种 y,看任务怎样跟着变。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 回归 | regression | 预测一个数,比如房价、气温 |
| 分类 | classification | 预测一个类别,比如晴、雨、雪 |
| 拟合 | fitting | 找一条线或曲线贴着已有的点 |
| 目标检测 | object detection | 找出图里每个物体,并用方框框出来 |
| 推荐系统 | recommendation system | 猜你会给没看过的电影打几分 |
| RMSE | Root Mean Square Error,均方根误差 | 预测和真实差多少的一个平均量 |
| 上下文学习 | in-context learning | 在提示里给几个例子,模型照着答,参数不改 |
一个类比:同一个天气预报员,两种问法
问天气预报员「明天下不下雨」,他从晴、雨、雪里挑一个回答。问他「明天几度」,他报一个数,比如 72°F。
他看的是同一张雷达云图,脑子里的知识也一样。变的只是你要的答案长什么样。前一种是分类,后一种是回归。
机器学习里也是这样。x 不变,y 换了样子,任务的名字就跟着换。
类比在哪里失效:
- 预报员一个人就能回答两种问题。机器学习里,分类模型和回归模型通常要分开训练,输出的形式也不同。
- 「几度」能精确到小数点后几位,类别却只有几个固定选项。y 能不能取任意中间值,就是判断回归还是分类的关键。
从零讲起
1. 回归:预测一个数
它解决什么问题
你要卖一套 800 平方英尺的房子,想知道能卖多少钱。手头有附近房子过去的成交记录:每套的面积和成交价。答案是一个数,而且可以是任何数,这就是回归要解决的问题。
从哪来(补充)
regression 这个词来自 19 世纪的英国学者 Francis Galton。他研究身高时发现,个子特别高的父母,孩子往往没那么高,身高会「回归」到平均值附近。这个词后来就留给了一切「用数据拟合一个数值关系」的方法。
拟合用到的最小二乘法更早:Legendre 在 1805 年、Gauss 在 1809 年分别发表。
出处:Wikipedia: Regression analysis
直觉
把成交记录画在纸上,横轴是面积,纵轴是价格。点大致往右上方走:面积越大越贵。找一条线贴着这些点,到 800 那里往上看,线有多高,价格就猜多少。
一步一步看
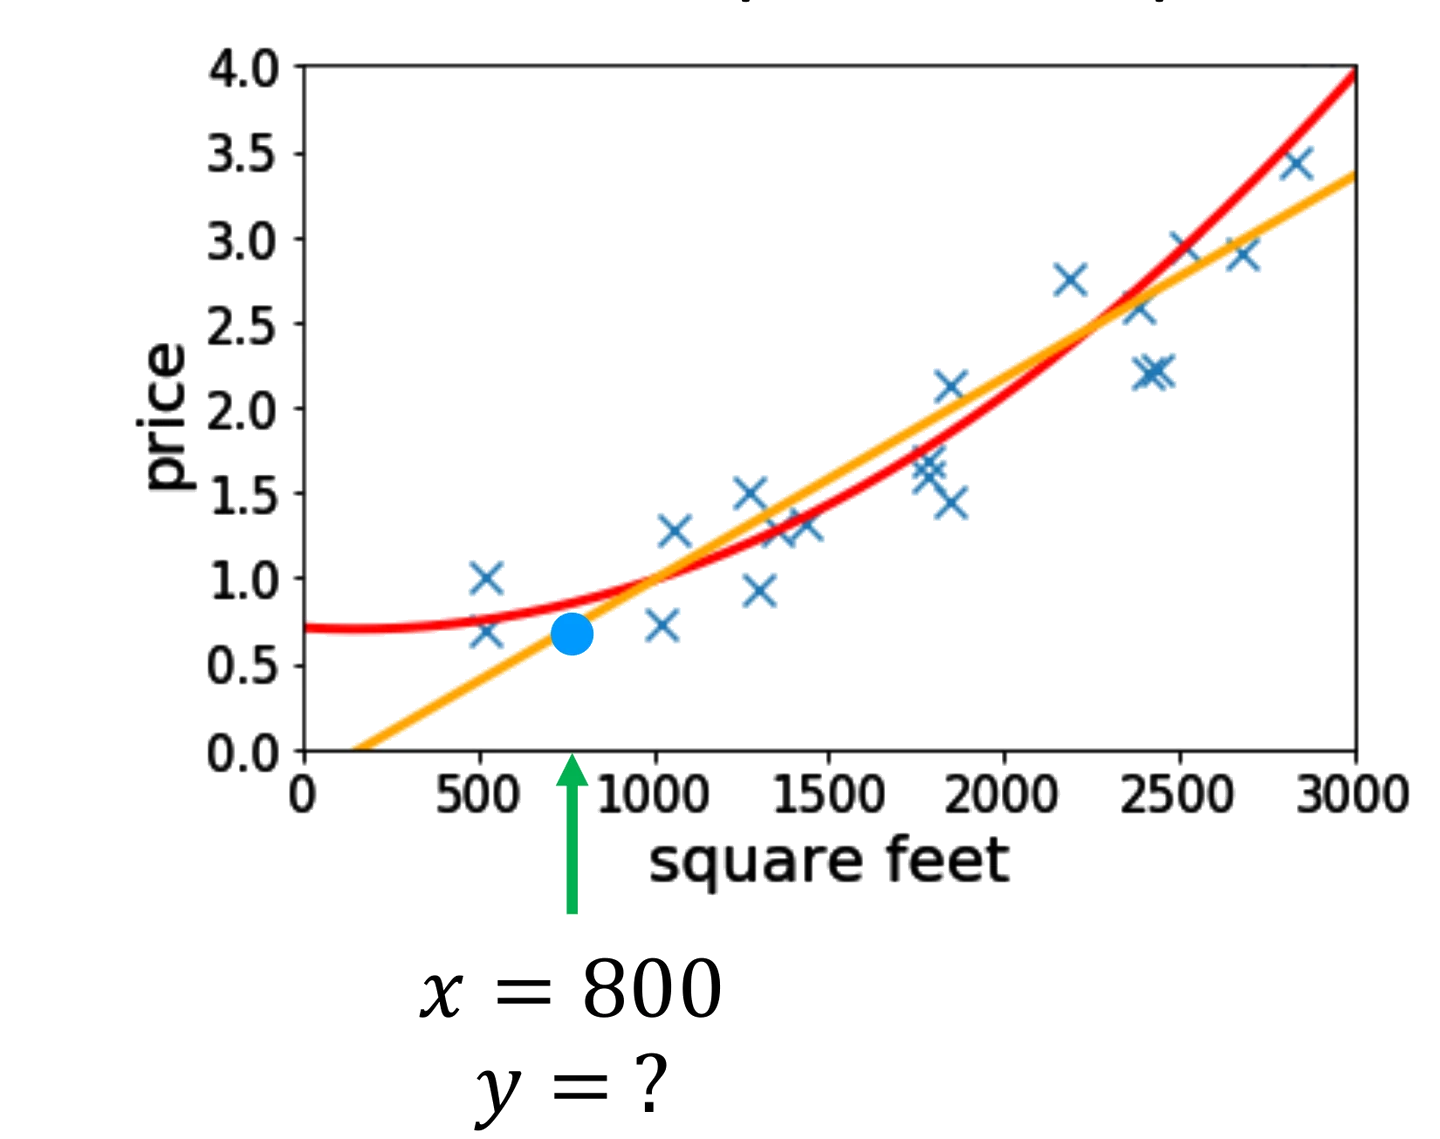
目标:把成交记录画成点,再分别用直线和抛物线在 800 处读数,看同一批点能给出不同的房价答案。
-
把过去成交的房子画成点,每个叉是一套房子。800 平方英尺这套还没卖,它的 y 就是要猜的数。
-
画一条直线贴着这些点,在 800 处往上读,读到约 0.6。
-
换一条向上弯的抛物线,同一处读到约 0.7。两条线都贴着这些点,给出的答案却不一样。
怎么算
回归分两步。先用已有的 (x, y) 拟合出一个函数 f,再把新的 x 代进去:
预测值 ŷ = f(x_new)
意思是:模型学到的是一条线或一条曲线,预测就是读这条线在新 x 处的高度。房价例子里 x_new = 800,直线给出 f(800) 约 0.6,抛物线给出约 0.7。
该选哪条线,课件这一页只提问题不回答。判断标准还是上一页那句:看哪条线对没见过的新房子猜得准。后面讲模型选择时会正式处理。
常见误解
以为回归就是画直线
直线只是最简单的一种。课件同一页就画了抛物线。只要 y 是一个连续的数,用什么形状的函数去拟合都叫回归。
以为线穿过的点越多越好
线可以弯得穿过每一个点,但那样往往只是记住了这批房子,对新房子反而猜不准。这是后面要讲的过拟合。
试一下
拟合出的直线是「价格 = 0.001 × 面积」。面积 1500 的房子,预测价格是多少?
0.001 × 1500 = 1.5。预测就是把 x 代进拟合出的函数。
2. 分类,以及怎么分辨回归和分类
它解决什么问题
拿到一个任务,先要知道它是回归还是分类,因为两类问题用的模型和衡量好坏的办法都不同。课件给的判据只有一条,而且只看 y。
直觉
y 能取任意中间值,比如 0.6 和 0.7 之间的任何数,就是回归。y 只能从几个固定选项里挑一个,就是分类。选项可以只有两个,也可以有一千个。
一步一步看
目标:同一份房产数据换着问两个问题,再把课件例子按 y 排一排,看回归和分类只看 y 是数还是类别。
-
同一份房产数据,特征换成两个:居住面积和地块面积,x = (size, lot size)。
-
问「这套能卖多少钱」:y 是一个数,回归。
-
问「这是独栋 house 还是联排 townhouse」:y 是两个类别之一,分类。图上三角是 house,圆是 townhouse,一条斜线把它们大致分开。
-
把课件里的例子按 y 排一排,判断就很机械了:
| 例子 | y 长什么样 | 类型 |
|---|---|---|
| 手写数字识别 | 0 到 9 之一 | 分类(十类) |
| 天气:明天什么天气 | 晴、雨、雪之一 | 分类 |
| 天气:某地温度 | 72°F 这样的数 | 回归 |
| 股票:明天涨还是跌 | 涨或跌 | 分类 |
| 股票:明天的价格 | 一个数 | 回归 |
| 用户会不会点这条广告 | 点或不点 | 分类 |
怎么判断
问一句:y 能不能取两个合法值中间的值?
意思是:能取,比如价格在 0.6 和 0.7 之间还能取无数个值,就是回归。不能取,比如「晴」和「雨」中间没有别的天气,就是分类。
常见误解
以为分类只能分两类
手写数字是十类,ImageNet 有一千类。判断只看 y 是不是有限个离散的值,和几类无关。
以为 y 写成数字就是回归
手写数字的 y 是 0 到 9,看着是数,但它们只是十个类别的名字。「3」和「4」中间没有「三点五」这个类别,所以是分类。
试一下
预测一个病人会不会在一个月内再次入院,是回归还是分类?预测他会住院几天呢?
会不会再入院:y 只有「会」和「不会」,分类。住院几天:y 是一个数,回归。
3. 监督学习用在哪:每个应用都问「x 是什么,y 是什么」
它解决什么问题
课件用一长串页面展示监督学习的应用:图像、检测、翻译、搜索排序、推荐。名字五花八门,其实只要找出 x 和 y,就能看出它们都是同一种学习。
直觉
监督学习就是学一个从 x 到 y 的映射。x 变了、y 变了,应用的名字就变了,学习的方式不变:都要有大量带答案的 (x, y) 对。
一步一步看
目标:逐个找出五个应用的 x 和 y,看名字五花八门的任务其实都是同一种监督学习。
-
图像分类:x 是图片的像素,y 是图里主要是什么。课件引的 ImageNet 有一千个类别。
-
目标检测:x 还是像素,y 变成每个物体的方框坐标。前两个应用 x 一模一样,只有 y 不同。
-
机器翻译:x 是一句英文,y 是一句中文。
-
网页排序:x 是查询词加上一批网页,y 是这些网页的先后顺序。课件截了一张搜索 learning to rank 的结果页,搜索引擎给结果排序,用的就是学出来的排序。
-
推荐系统:把用户和电影排成一张表,格子里是评分,没看过的格子是问号。推荐就是把问号填出来。
怎么判断
给你一个没见过的应用,按顺序问三句:
- x 是什么?
- y 是什么,是现成给好的吗?
- y 是一个数、一个类别,还是更复杂的东西(一组坐标、一句话、一个顺序)?
意思是:前两句确定它是不是监督学习,第三句确定它更像回归还是分类。y 是一组坐标、一句话时,它可能两种成分都有,比如检测既要说「是什么」又要给出「在哪」。
课件在翻译那页还加了一句:这门课只覆盖监督学习的基础技术,单靠它们解决不了困难的视觉和语言问题。
常见误解
以为推荐系统不算监督学习,因为它没有「正确答案」
已经打过的分数就是 y。Netflix 当年办比赛,从 2006 年办到 2009 年,奖金一百万美元,看的就是谁把没看过的那些格子猜得准,用 RMSE 打分。
试一下
给一张照片写一句描述(看图说话),x 和 y 各是什么?
x 是照片像素,y 是一句话。和机器翻译一样,y 是一串词,不是一个数也不是一个类别。
4. 上下文学习:示例写进提示,参数一个不改
它解决什么问题
大语言模型训练完以后,想让它做一件新任务,比如英译法,最省事的办法是在提示里写几个示例,让它照着做。课件把这页放在监督学习的标题下,但特意写了一句 No gradient updates are performed,要你分清它和训练的区别。
直觉
像给一个已经学过很多语言的人看三张小卡片:「海獭 => loutre de mer」之类。他看完马上就能接着翻下一个词。他什么新东西都没学进脑子,只是从卡片上看出了你要干什么。
一步一步看
目标:一行行读 GPT-3 的英译法提示,看示例怎样以 (x, y) 对的形式写进提示,模型参数却一个不改。
课件的示例是 GPT-3 论文里的一张图,一行一行地读:
- 第一行是任务说明:Translate English to French。
- 接下来三行是示例,形式和 (x, y) 对一样。
- 最后一行只给 x,让模型续写 y。
| 行 | 内容 | 作用 |
|---|---|---|
| 1 | Translate English to French: | 任务说明 |
| 2 | sea otter => loutre de mer | 示例 |
| 3 | peppermint => menthe poivrée | 示例 |
| 4 | plush girafe => girafe peluche | 示例 |
| 5 | cheese => | 等模型续写 |
怎么判断
问一句:模型的参数在这个过程里变没变?
意思是:变了,是训练;没变,只靠提示里的示例当场作答,就是上下文学习。监督学习的训练会用标注数据更新参数,上下文学习完全不碰参数。
常见误解
以为提示里给了 (x, y) 示例,模型就被「训练」了一次
图上明写没有梯度更新。关掉这次对话,模型还是原来那个模型,下次不给示例它不会记得。
试一下
把示例从三个减到零,只留任务说明和 cheese =>,模型的参数会变吗?
不会。示例多少只影响这一次回答得好不好,参数始终不变。
把它们串起来
监督学习只做一件事:学一个从 x 到 y 的映射。这一页的所有内容都在回答「y 长什么样」。
y 是一个连续的数,叫回归。做法是拟合一条线或曲线,在新 x 处读高度。直线和抛物线会给出不同的读数,选哪条要看哪条对新数据准。
y 是有限个类别之一,叫分类。类别可以是两个,也可以是一千个。同一份 x,换一个 y,任务就从回归变成分类。
再往外看,图像、检测、翻译、排序、推荐都是监督学习,区别只在 y 的形状:类别、坐标、句子、顺序、评分。
上下文学习是个例外。示例长得像 (x, y),但参数不更新,它和「用标注数据训练」不是一回事。
下一页把 y 整个拿掉,看只剩 x 的时候还能学什么。
课件里的坑
- [课件留白] p.17 的线性拟合和二次拟合,图上在 x = 800 处读出的预测值一个约 0.6,一个约 0.7。蓝点画在抛物线上只是示意,课件没说哪个对。答案是「取决于哪条曲线对新数据更准」,这是第三份课件的模型选择。
- [课件留白] p.24 的 in-context learning 放在监督学习标题下,但图上明确写了 No gradient updates are performed。考试如果问「few-shot 属于哪一类」,回答「利用已训练好的模型,推理时不更新参数」最稳。
- [读图提醒] p.20 那条把 house 和 townhouse 分开的斜线是手画的示意分界线,不是算出来的,作用和 p.12 那条斜线一样,说明两类大致线性可分。
- [同名不同类] 天气预测在 p.14 输出晴、雨、雪,是分类;在 p.15 输出 72°F,是回归。股票同理。考试问「天气预测是哪类」要先问清 y。
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,用一句话说出回归和分类的判据。然后过一遍课件例题,每题先自己说出 x 和 y 再看解答。最后做完整例题和变式题。
必背
- 回归和分类的区别只在 y:y 是连续数值叫回归,y 是有限个类别叫分类
- 同一份 x 换一个 y 就换任务类型:房产数据问价格是回归,问户型是分类
- 回归的预测值就是拟合出的函数在新 x 处的取值;直线和抛物线在 x = 800 处给出约 0.6 和约 0.7 两个不同答案
- 监督学习应用看 x 和 y:图像分类 y 是类别,目标检测 y 是方框坐标,机器翻译 y 是译文,推荐系统是填评分矩阵里的空格
- In-context learning 在提示里给示例,不更新梯度(no gradient updates),模型参数不变
课件例题
例 1(课件 p.13):手写数字识别和人脸,x 和 y 分别是什么?
题面:左边是一张 MNIST 手写数字的随机样本,任务是把手写数字转成字符 0..9;右边是人脸识别(这是谁)和人脸检测(脸在哪)。
提示
三个任务的 x 都是图片。区别在 y。
解答
手写数字:x 是图片像素,y 是 0–9 之一,十分类。人脸识别:x 是人像像素,y 是人的身份。人脸检测:x 是合影像素,y 是每张脸的方框。三个任务 x 都是像素,变的只是 y。
例 2(课件 p.14):天气、医疗、经济三组例子,为什么都算分类?
题面:天气预测输出雨、雪、晴三个图标;医疗诊断输出若干可能疾病之一或 none of the above;经济预测股票涨或跌、用户点不点广告。
提示
逐个看 y 能取哪些值。
解答
三组例子的 y 都是有限个类别,所以都是分类。同样是天气,下一页输出 72°F 这样的具体温度就变成回归;同样是股票,预测具体价格也是回归。
例 3(课件 p.16–17):一套 800 平方英尺的房子,价格该怎么预测?
见下方完整例题。
例 4(课件 p.20):同一份房产数据,问户型是 house 还是 townhouse,这是什么任务?
题面:横轴是居住面积,纵轴是 lot size,蓝三角是 house、橙圆是 townhouse,中间一条斜线把两类分开。
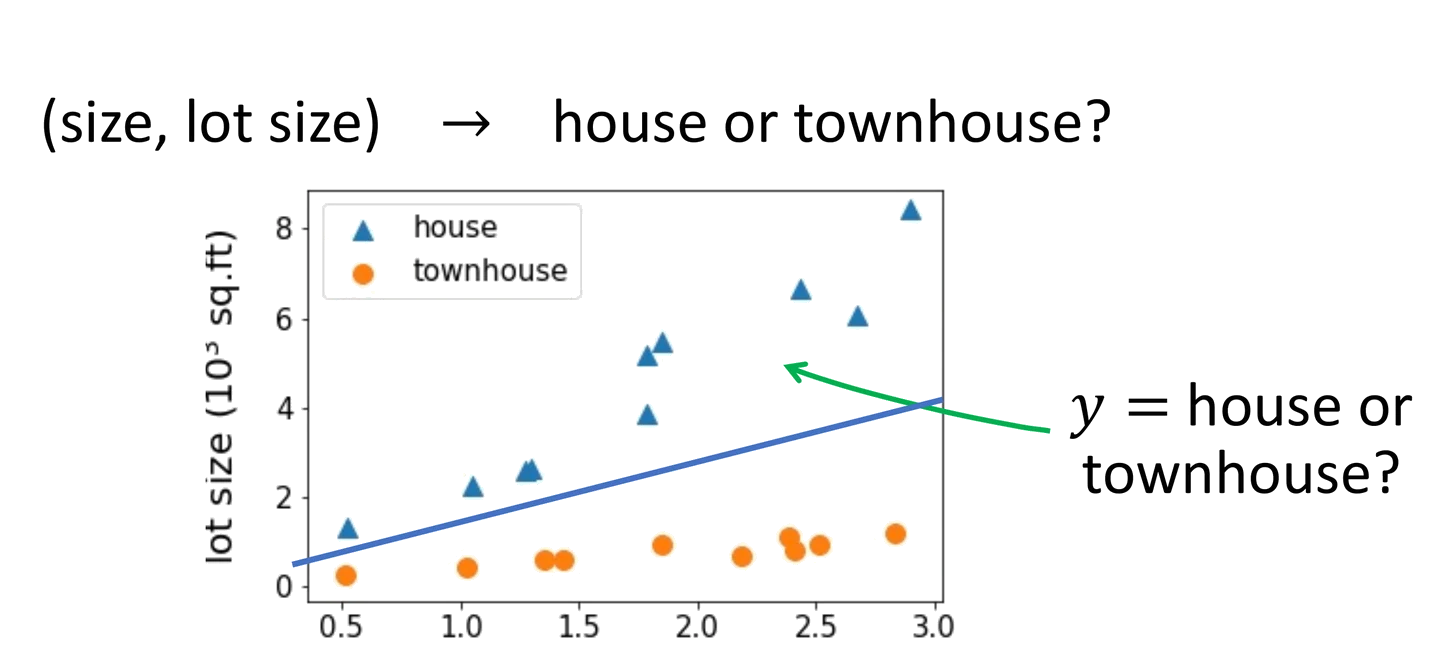
提示
和房价那题比,x 变了没有?y 变了没有?
解答
分类,y 是两个类别之一。x 和房价那题一样都是 (size, lot size),只是 y 从价格换成了户型。
例 5(课件 p.24):提示里给了三组英译法,最后一行 cheese => 让模型续写,模型参数变了吗?
题面:提示先写 Translate English to French,再给 sea otter => loutre de mer 等三个示例,最后是 cheese =>。
提示
找图上那句关于 gradient 的话。
解答
没变。图上明写 No gradient updates are performed:这是 in-context learning,示例是 (x, y) 对的形式,但模型只靠提示里的示例当场作答,不更新任何参数。
例 6(课件 p.32):Netflix 评分矩阵里的 ? 是什么问题?
题面:右下角是一张 movies × users 的矩阵,格子里是 1–5 的评分,还有若干格是 ?。比赛用 RMSE 排名。
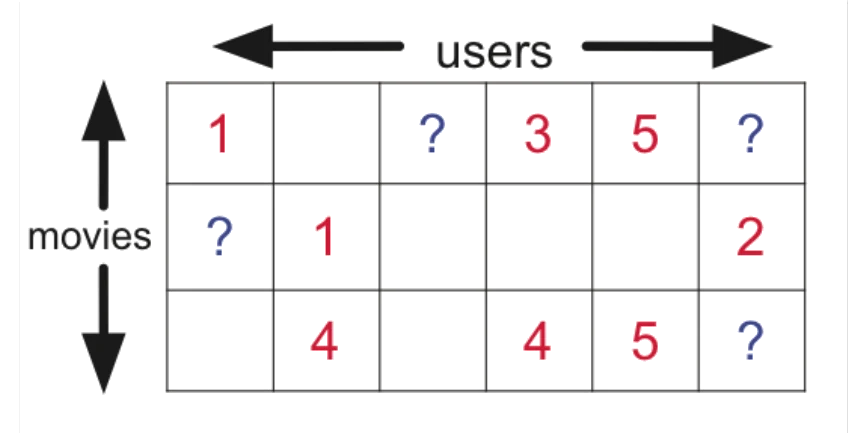
提示
已经填了的分数在这里扮演什么角色?
解答
推荐问题的数学形式就是把矩阵里的 ? 填出来,也就是预测用户对没看过的电影会打几分。已知的评分是 y,所以它仍属监督学习;用 RMSE 衡量误差,说明把评分当连续值处理。
完整例题
题面(课件 p.16–17):数据集是约 20 套房子的 (面积, 价格),横轴 0 到 3000 平方英尺。问一套 800 平方英尺的房子价格是多少。课件在同一份数据上画了一条直线和一条抛物线。回答:这是什么任务,x 和 y 是什么,两条线各给出什么预测,该信哪一条。
解法:
- 判类型:y 是价格,可以取任意中间值,所以是回归。
- 写记号:一共 n 个样本 (x⁽ⁱ⁾, y⁽ⁱ⁾),x⁽ⁱ⁾ 是第 i 套的面积,y⁽ⁱ⁾ 是它的价格。新房子 x_new = 800。
- 读直线:在 x = 800 处往上看,直线高度约 0.6,所以直线预测 ŷ ≈ 0.6。
- 读抛物线:同一处抛物线高度约 0.7,预测 ŷ ≈ 0.7。
- 比较:两个答案相差约 0.1。两条线都贴着已有的点,光看训练数据分不出谁对。
- 结论:该信对没见过的新房子猜得更准的那条。课件这里不回答,后面的模型选择会用验证集来比。
要点:回归的预测就是「函数在新 x 处的值」。同一份数据可以拟合出不同的函数,答案就不同。
答题格式:先一句话写任务类型和判据,再分别写两条线的读数,最后一句说明选择标准是对新数据的准确程度。
变式题(先自己做)
(1) 自编情境:把下面四个任务归为回归或分类,并说出 y。① 根据一张 X 光片判断有没有肺炎;② 根据房子面积和房间数预测成交价;③ 预测一个用户会给某部电影打几星;④ 判断一封邮件是不是垃圾邮件。 (2) 自编情境:一条拟合出的直线是「价格 = 0.2 + 0.001 × 面积」。分别预测面积 800 和 2000 的房价。
提示
(1) 先写出每个任务的 y,再问 y 能不能取中间值。(2) 把面积代进式子。
判分点与答案(非官方评分标准)
判分点:① (1) 每题都写出 y 并说明判据;② (2) 写出代入过程。
(1) ① 分类,y 是有或没有。② 回归,y 是价格。③ 回归,y 是星数;课件 Netflix 用 RMSE 衡量,把评分当连续值处理。写成分类并说明「星数只有 1 到 5」也可接受,但要点名判据。④ 分类,y 是垃圾或正常。
(2) 面积 800:0.2 + 0.8 = 1.0。面积 2000:0.2 + 2.0 = 2.2。
闪卡自测
1. 回归和分类的判据是什么?
只看 y:y 是连续数值叫回归,y 是有限个类别叫分类(p.20)。
2. 课件里「天气预测」出现了两次,分别属于哪一类?
分类那页输出晴、雨、雪三个图标,是分类;回归那页输出 72°F,是回归(p.14、p.15)。
3. 房价例子里,直线和抛物线在 x = 800 处各读出多少?哪个对?
直线约 0.6,抛物线约 0.7。课件不回答哪个对,要看哪条对新数据更准(p.17)。
4. 目标检测的 y 是什么,它和图像分类有什么不同?
y 是边界框的坐标。图像分类的 y 是一个类别,检测的 y 既有类别又有坐标(p.21–22)。
5. 推荐问题的数学形式是什么?
把 users × movies 评分矩阵里的空格填出来,也就是矩阵补全(p.32)。
6. In-context learning 和监督学习的训练差在哪?
示例形式一样是 (x, y),但 No gradient updates are performed,参数不变(p.24)。
7. 手写数字的 y 是 0 到 9,为什么不算回归?
这十个数只是十个类别的名字,3 和 4 中间没有「三点五」这个类别(p.13)。
下一讲
下一页 L04a-3 把 y 整个拿掉:只剩 x 的时候,还能找出数据里的分堆、词和词的关系,以及把高维数据压到平面上看。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。