L04a-1 机器学习是什么:从一张七行表格学会看 x 和 y
从零讲机器学习:规则从数据里来;一行是一个样本,前几列是特征 x,最后一列是标签 y;再一格一格算一遍垃圾邮件的线性规则。
一句话版
机器学习就是让程序从带答案的例子里自己找出判断规则,人不再一条一条手写。
这一讲是机器学习的第一份课件,从定义讲起。这一页只讲三件事:机器学习和普通编程差在哪,一张数据表怎么读,一条最简单的线性规则怎么算。回归、无监督、强化学习放在后面三页。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 机器学习 | machine learning,ML | 让程序从数据里学出规则 |
| 样本 | example / sample | 一条数据,比如一封邮件 |
| 特征 x | feature | 描述一个样本的那几个数 |
| 标签 y | label | 这个样本的正确答案 |
| 监督学习 | supervised learning | 每个样本都带着答案 y 去学 |
| 训练 / 测试 | training / test | 用带答案的数据学,再拿新数据考 |
| 线性规则 | linear rule | 给每个特征一个权重,加起来和一个数比 |
一个类比:教新同事分拣邮件
你在公司收发室,新来一位同事,要教他把垃圾邮件挑出来。
一种教法是写一本手册:「信里有 money 又是陌生人寄的,扔掉。」规则全由你来想,漏掉的情况他就不会处理。这是传统编程。
另一种教法是搬来一摞已经分好的信,每封上面都贴着「垃圾」或「正常」。他翻多了,自己就摸出了门道:陌生人提钱的多半是垃圾,熟人寄来的多半正常。这是机器学习,那摞贴好标签的信就是训练数据。
你最终关心的是明天新来的信他能不能分对。这摞旧信他背得再熟也没用,那只是练习。
类比在哪里失效:
- 人翻信时会用上常识,比如知道 pills 是药。程序只看到一列 Y 和 N,常识一点都没有。
- 新同事说不清自己凭什么判断。下面那条线性规则能写成一个式子,每个特征占多少分清清楚楚。
从零讲起
1. 机器学习到底在学什么
它解决什么问题
有些判断很难写成规则。垃圾邮件的花样每天都在变,手写数字每个人写法不同,人脸更是千差万别。人想不全所有规则,但手里有大量带答案的例子。机器学习就是从这些例子里把规则找出来。
从哪来(补充)
machine learning 这个词是 IBM 的 Arthur Samuel 在 1959 年用起来的。他 1949 年进 IBM,在 IBM 第一台商用计算机 IBM 701 上写了一个下跳棋的程序,让它自己跟自己下,越下越好。
课件引的定义说机器学习让计算机「without being explicitly programmed」也能学会。维基百科的 Samuel 条目里找不到这句原话,它更像后人对他工作的概括,答题照课件写就行。
直觉
传统编程:人写规则,规则加数据,得出答案。机器学习把顺序倒过来:人给数据和答案,程序吐出规则。
一步一步看
目标:对照传统编程和机器学习两行流程,看机器学习怎样从数据和答案学出规则,再拿它判没见过的样本。
-
先看传统编程这一行:人写好的规则和数据一起交给程序,程序算出答案。规则的好坏完全取决于写的人。
-
再看机器学习这一行:输入换成数据和答案(标签),中间是学习算法,产出的是规则。
-
学出规则以后,它就像传统程序一样工作:来一封新信,规则判它是不是垃圾。
-
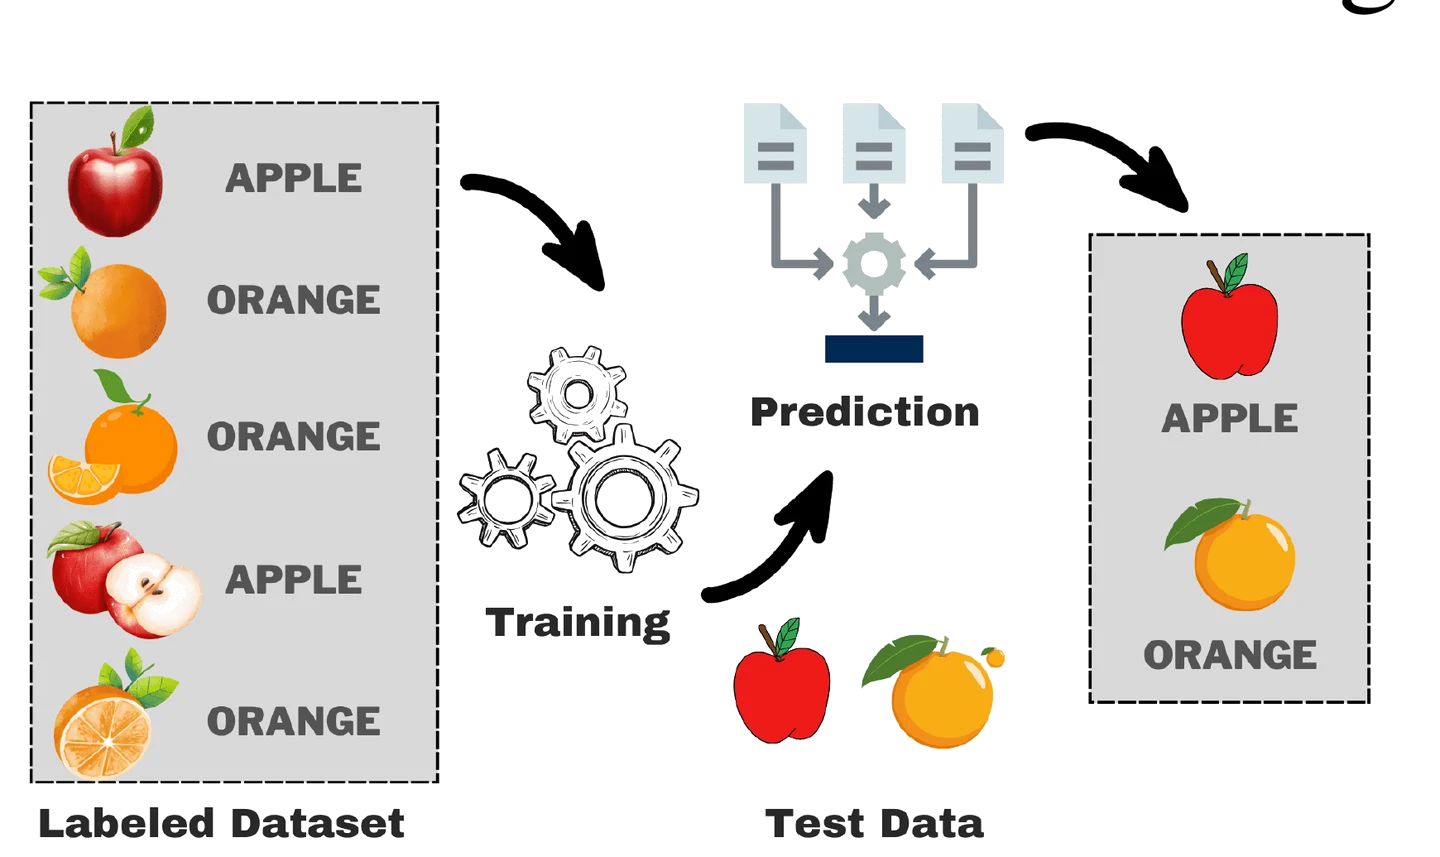
课件的流程图把这一步画得很清楚。左边五张标好 APPLE 或 ORANGE 的水果图片拿去训练,得到一个模型;右下角两个没标签的水果是测试数据,模型要自己判出它们是什么。
怎么判断
拿到一个任务,问两句话就能判断它是不是机器学习:
- 规则是人写死的,还是从数据里学出来的?
- 学完以后,要它处理的是不是没见过的新数据?
意思是:两句都答「从数据学」「要处理新数据」,就是机器学习。课件把 future 标成红色,强调的就是第二句:目标是对将来的数据也预测准,这个能力叫泛化。
常见误解
以为把训练数据全部分对就算学好了
把见过的信全分对,可能只是背下来了。课件写的目标是 predict well on future data,新来的信也要分对。训练数据分对只是手段。
以为机器学习不需要人参与
答案(标签)是人给的,特征选哪几个也是人定的。机器替你做的只是从这些里面找出规则。
试一下
计算器做加法,算机器学习吗?用过去一年的成交记录预测明天的房价呢?
计算器不算,加法规则是人写死的,没有从数据学。预测房价算,规则从成交记录里学,要对明天这套没卖过的房子给出价格。
2. 一张表怎么读:样本、特征、标签
它解决什么问题
程序看不懂一封信,只看得懂数。所以第一步要把每封信变成一行数:信里有没有 money、有没有 pills、发件人认不认识。这一行数加上正确答案,就是程序学习用的材料。
直觉
想成一张 Excel 表。横着一行是一封信,竖着前几列是描述这封信的特征,最后一列是答案。
一步一步看
目标:在垃圾邮件表上分别横看一行、竖看前五列和最后一列,分清样本、特征 x 和标签 y。
课件给的表有 7 行,下面三步分别看行、前五列、最后一列。
-
横着看一行:第 4 行这封信含 money,发件人认识,不是垃圾邮件。一行就是一个样本。
-
竖着看前五列:money、pills、Mr.、bad spelling、known。这五列是特征 x,每封信都用这五个 Y 或 N 来描述,Y 记 1、N 记 0。
-
最后一列 spam? 是标签 y,也就是正确答案。
-
合起来,一行就是一对 (x, y):x 是前五个数,y 是最后那个答案。
怎么算
课件用房价例子引入了一套正式记号,后面的课件全程沿用:
- 一共 n 个样本,写成 (x⁽¹⁾, y⁽¹⁾), …, (x⁽ⁿ⁾, y⁽ⁿ⁾)
- 一个样本有好几个特征时,x⁽ⁱ⁾ = (x₁⁽ⁱ⁾, x₂⁽ⁱ⁾, …)
- y⁽ⁱ⁾ 是第 i 个样本的标签
意思是:右上角括号里的数字是样本编号,右下角的数字是特征编号。x₂⁽¹⁵⁾ 读作「第 15 个样本的第 2 个特征」。
课件原话 supervision refers to y:「监督」指的就是这些标签。
常见误解
把 x⁽¹⁵⁾ 读成 x 的 15 次方
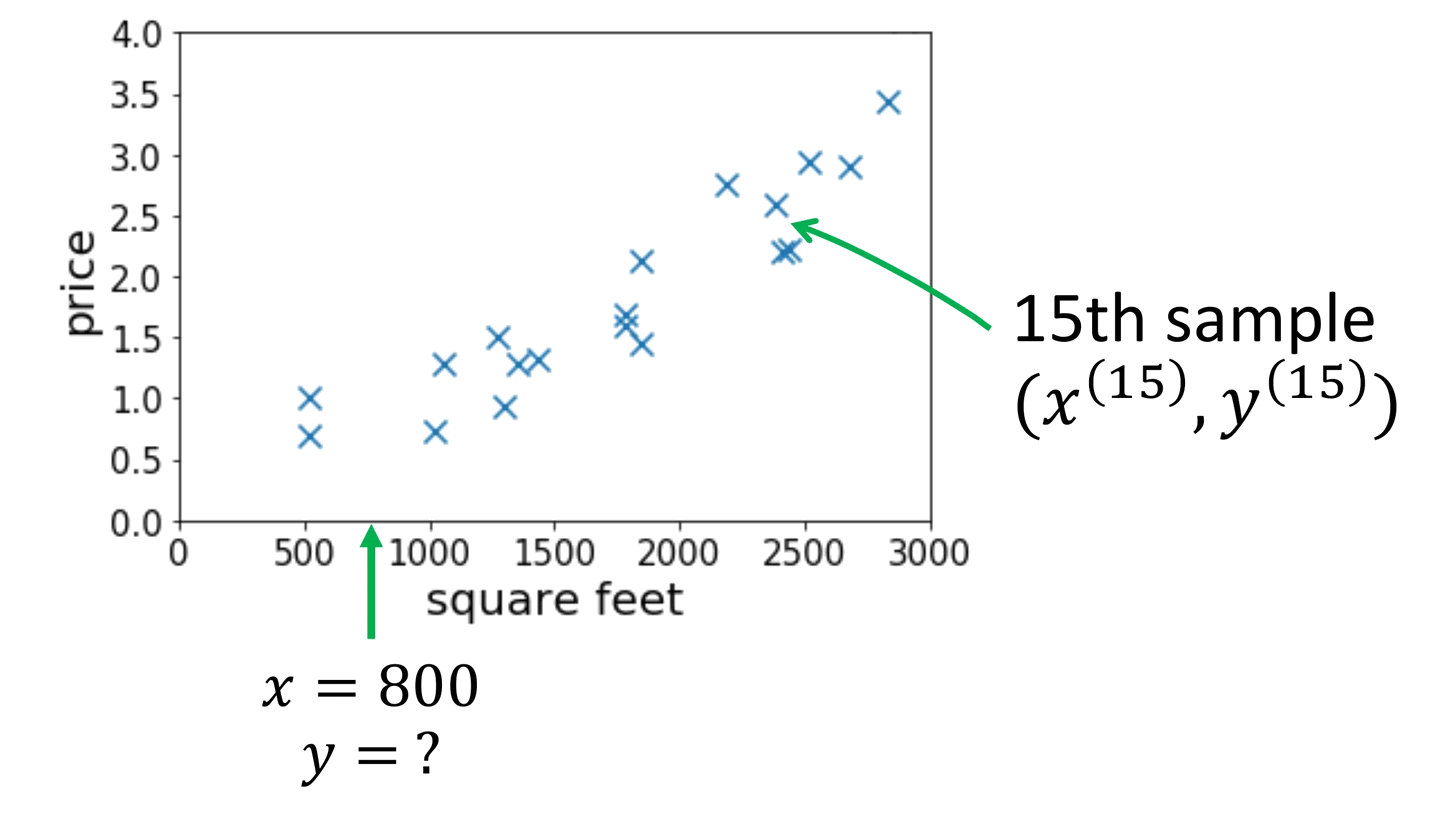
上标外面套了括号,是样本编号,不是幂。课件特意在散点图上用箭头指出 15th sample。
以为特征越多越好
表里的 Mr. 和 bad spelling 在下面两条规则里都没用上。特征多了,模型容易记住训练数据里的巧合,这是后面一份课件讲的过拟合。
试一下
表里第 3 行的 x 和 y 分别是什么?用 1 和 0 写出来。
x = (money 0, pills 1, Mr. 0, bad spelling 0, known 0),y = 1(是垃圾邮件)。
3. 一条线性规则:加权打分,再和 0 比
它解决什么问题
有了表,还要一条规则,能对每封信判「垃圾」或「正常」。课件给了两条看起来合理的规则。第一条是逻辑式:发件人陌生,并且含 money 或 pills,就判垃圾。第二条是打分式,这一节细讲它,因为后面的线性回归、线性分类都从这个形式长出来。
直觉
给每个特征一个分值。含 money 加 2 分,含 pills 加 3 分,熟人寄的扣 5 分。把一封信的分加起来,严格大于 0 就判垃圾。
一步一步看
目标:给第 4 行那封信逐项加权打分,再把七封信的总分画到一条线上,看 0 怎样把垃圾和正常分开。
拿第 4 行那封信来打分:money = 1,pills = 0,known = 1。
-
money = 1,乘权重 2,得 +2。
-
pills = 0,乘权重 3,得 0。这一项对总分没影响。
-
known = 1,乘权重 −5,得 −5。总分 2 + 0 − 5 = −3,不大于 0,判正常。表里这封确实不是垃圾。
-
七封信都这样算一遍,把总分画在一条线上。真实的垃圾邮件全落在 0 的右边,正常邮件全在 0 或 0 的左边。
怎么算
规则写成式子:
判为垃圾,当且仅当 2·money + 3·pills − 5·known > 0
意思是:每个特征乘上自己的权重,全部加起来,得到一个分数;分数严格大于 0 判垃圾,等于 0 或小于 0 判正常。权重的正负表示方向,正的往「垃圾」那边推,负的往「正常」那边拉;绝对值表示推得多用力。
Mr. 和 bad spelling 没出现在式子里,相当于它们的权重是 0。
这个形式叫线性规则:特征只乘一个数再相加,没有平方,也没有两个特征相乘。如果存在这样一条规则能把正负样本完全分开,就说这份数据线性可分。只有两个特征时,「分开」就是画一条直线;特征多了,那条直线变成超平面。
常见误解
把「大于 0」记成「大于等于 0」
第 7 行三项都是 0,总分正好是 0。严格大于才判正常,和表格一致;改成大于等于,这一行就错判成垃圾。
以为这条规则是课件「学」出来的
课件只说这是一条 reasonable 的规则,权重 2、3、−5 是给出来的。怎么从数据里自动找出这些权重,是下一份课件的梯度下降要解决的事。
试一下
一封新信:money = Y,pills = Y,known = N。总分多少?判什么?
2 + 3 − 0 = 5,大于 0,判垃圾。
把它们串起来
机器学习这件事可以压成一句:给数据和答案,让程序找规则,再用规则去判新数据。
数据要先变成表。一行是一个样本,前几列是特征 x,最后一列是标签 y。有标签可学,就叫监督学习,因为 y 在「监督」学习的方向。
规则有很多种形状。最简单的一种是线性规则:每个特征一个权重,加起来和 0 比。课件把两条规则画在一起,都和表格全部一致。
还剩一个问题课件没回答:这条规则对第八封信也准吗?学好的标准是新数据也判对,所以光在七封旧信上全对还不够。后面讲模型选择时会回来处理这个问题。
下一页换一种 y:答案从「是不是垃圾」变成「值多少钱」,那就是回归。
课件里的坑
- [课件留白] p.12 的两条规则课件只说 reasonable,没有验证。逐行代入七行数据,两条规则全部和 spam? 列一致,其中第七行规则 2 算出 0,靠「严格大于」才判对。这一点课件没提,但最容易出题。
- [读图提醒] p.16 的 x⁽¹⁵⁾ 上标括号里是样本编号,不是 15 次方。p.18 再加下标表示第几个特征,x₂⁽¹⁵⁾ 是第 15 个样本的第 2 个特征。
- [出处] p.6 截图里的论文标题带 II—Recent Progress,那是 Samuel 后来的续篇。without being explicitly programmed 这句在 Samuel 的维基条目里找不到原文,一般认为是后人对他工作的概括。答题照课件写这句就行。
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,在纸上默写 x、y 的位置:一行一个样本,前几列 x,最后一列 y。然后自己动手算一遍规则 2 的七行,再对完整例题。最后做变式题,先不看提示。
必背
- Samuel (1959) 的定义:机器学习是让计算机在不被显式编程的情况下获得学习能力的研究领域,关键词 without being explicitly programmed
- 监督学习的目标是对将来没见过的数据也预测准,把训练数据分对只是手段
- 表格里一行是一个样本:前面各列是特征 x,最后一列 spam? 是标签 y,supervision 指的就是 y
- 记号:n 个样本 (x⁽ⁱ⁾, y⁽ⁱ⁾),上标是样本编号、下标是特征编号
- 线性规则 2·money + 3·pills − 5·known > 0 是给特征加权求和再和阈值比,判据是严格大于 0
- 线性可分指正负样本能被一条直线(高维叫超平面)分开
课件例题
例 1(课件 p.10):监督学习流程图里,训练数据和测试数据各是什么?
题面:流程图左边是五张标好 APPLE / ORANGE 的水果图,经过 Training 得到模型;右下角的 Test Data 是一个苹果和一个橙子。说出两组数据的区别和模型要做的事。
提示
看两组图片上有没有贴字。
解答
训练数据每张都带标签,是 (x, y) 对;测试数据只有 x,没有标签。模型用带标签的数据学出规则,再对没标签的新水果自己判出 APPLE 还是 ORANGE。这个分工到第三份课件会变成训练集和测试集的正式定义。
例 2(课件 p.12):垃圾邮件特征表,用线性规则逐行判断
见下方完整例题。
例 3(课件 p.16、p.18):x⁽¹⁵⁾ 和 x₂⁽¹⁵⁾ 分别指什么?
题面:房价散点图上,绿箭头指着一个点,标注 15th sample (x⁽¹⁵⁾, y⁽¹⁵⁾)。后一页把特征扩成 (size, lot size) 两个,写成 x⁽ⁱ⁾ = (x₁⁽ⁱ⁾, x₂⁽ⁱ⁾)。
提示
括号上标和不带括号的下标,各管一件事。
解答
x⁽¹⁵⁾ 是第 15 个样本的特征,y⁽¹⁵⁾ 是它的价格;上标括号里是样本编号,不是 15 次方。x₂⁽¹⁵⁾ 是第 15 个样本的第 2 个特征,也就是这套房子的 lot size。课件同页还说明 supervision 指的就是全部 y⁽¹⁾ 到 y⁽ⁿ⁾。
完整例题
题目:下面是课件第 12 页的特征表,Y 记 1、N 记 0。用规则「预测垃圾邮件当且仅当 2·money + 3·pills − 5·known > 0」逐行判断,并和最后一列比较。
| 行 | money | pills | Mr. | bad spelling | known | spam? |
|---|---|---|---|---|---|---|
| 1 | Y | N | Y | Y | N | Y |
| 2 | N | N | N | Y | Y | N |
| 3 | N | Y | N | N | N | Y |
| 4 | Y | N | N | N | Y | N |
| 5 | N | N | Y | N | Y | N |
| 6 | Y | N | N | Y | N | Y |
| 7 | N | N | Y | N | N | N |
解:规则只用到 money、pills、known 三列,Mr. 和 bad spelling 的权重是 0。
| 行 | 计算 | 结果 | 大于 0? | 预测 | 真实 |
|---|---|---|---|---|---|
| 1 | 2×1 + 3×0 − 5×0 | 2 | 是 | 垃圾 | 垃圾 |
| 2 | 2×0 + 3×0 − 5×1 | −5 | 否 | 正常 | 正常 |
| 3 | 2×0 + 3×1 − 5×0 | 3 | 是 | 垃圾 | 垃圾 |
| 4 | 2×1 + 3×0 − 5×1 | −3 | 否 | 正常 | 正常 |
| 5 | 2×0 + 3×0 − 5×1 | −5 | 否 | 正常 | 正常 |
| 6 | 2×1 + 3×0 − 5×0 | 2 | 是 | 垃圾 | 垃圾 |
| 7 | 2×0 + 3×0 − 5×0 | 0 | 否 | 正常 | 正常 |
七行全部判对。第七行是关键:算出 0,判据是严格大于 0,所以判正常。如果把判据误写成大于等于 0,这一行就会判成垃圾,和表格矛盾。
再用规则 1「unknown AND (money OR pills)」核一遍:第 1、3、6 行发件人陌生且含 money 或 pills,判垃圾;第 2、4、5 行发件人认识,判正常;第 7 行陌生但两样都不含,判正常。也是七行全对。
结论:两条规则在七封已见过的邮件上都全对。能不能对第八封也对,才是监督学习真正关心的问题。
答题格式:列「行 / 计算 / 结果 / 预测 / 真实」五列,逐行写出代入式,最后单独一句点明第 7 行等于 0 的处理。
变式题(先自己做)
(1) 改编自课件 p.12:一封新邮件 money = Y、pills = Y、known = Y、Mr. = N、bad spelling = Y。用规则 1 和规则 2 分别判断,两条规则结论是否一致? (2) 自编情境:把规则 2 的阈值从 0 改成 −4,即总分大于 −4 就判垃圾。七行里哪几行会判错?
提示
(1) 规则 1 里 unknown 是 known 的否定,先看 known。规则 2 直接代入三个数。(2) 七行的总分已经在完整例题里算好,逐个和 −4 比。
判分点与答案(非官方评分标准)
判分点:① (1) 两条规则都要写出判断过程;② (2) 要列出每行总分和新阈值的比较。
(1) 规则 1:known = Y,unknown 为假,整个 AND 为假,判正常。规则 2:2 + 3 − 5 = 0,不大于 0,判正常。两条一致。
(2) 总分是 2、−5、3、−3、−5、2、0。大于 −4 的有第 1、3、4、6、7 行,都判垃圾。第 4 行和第 7 行真实是正常,判错两行。阈值也是规则的一部分,挪一挪就会出错。
闪卡自测
1. Samuel 定义里的关键短语是什么?
without being explicitly programmed,不被显式编程(p.6)。
2. 机器学习和传统编程的区别落在哪里?
传统编程是人把规则写死;机器学习是人给数据和答案,规则由程序从数据里学出来。
3. 监督学习的 supervision 指的是什么?
指标签 y。课件原话是 supervision refers to y(p.18)。
4. 课件为什么把 future 标成红色?
监督学习的目标是对将来的数据也预测准。把已经看过的邮件分对只是手段(p.11)。
5. 规则 2 里 money、pills、known 的权重和阈值分别是多少?
权重分别是 2、3、−5,阈值是 0,判据是严格大于 0(p.12)。
6. 新邮件含 money、不含 pills、发件人未知,两条规则怎么判?发件人改成已知呢?
发件人未知时:规则 1 为真,规则 2 得 2 > 0,都判垃圾。改成已知:规则 1 为假,规则 2 得 2 − 5 = −3,都判正常。
7. x₂⁽¹⁵⁾ 表示什么?
第 15 个样本的第 2 个特征。上标是样本编号,下标是特征编号。
8. 什么叫线性可分?
存在一条直线(高维是超平面)把正负样本完全分开。垃圾邮件这张表用规则 2 就能分开。
下一讲
下一页 L04a-2 换一种 y:答案是一个数时叫回归,是一个类别时叫分类,再看监督学习在图像、翻译、推荐里分别长什么样。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。