L02a-3 DFS:一条路走到底,撞墙再回头
从栈讲起,用和 BFS 同一棵树一帧一帧跑一遍深度优先搜索,再看它为什么省内存、为什么会陷进去,最后把 BFS 和 DFS 摆在一起比怎么选。
一句话版
DFS(深度优先搜索)从起点出发,挑一个孩子一直往下走,走到没路了再退回最近的岔口,换下一个孩子接着往下。它只需要记住脚下这一条路,所以很省内存;代价是可能一头扎进一条很深的死胡同。
BFS 怎么一层一层扫,见上一页 L02a-2。这一页把 BFS 的队列换成栈,看看会发生什么。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| DFS | Depth-First Search,深度优先搜索 | 一条路走到底再回头的找法 |
| 栈 | stack,LIFO(Last In First Out) | 一摞盘子:最后放上去的最先拿走 |
| 栈顶 | top | 栈里最后放进去、下一个要被拿走的位置 |
| 回溯 | backtrack | 走到死路后退回上一个岔口,换一条路 |
| 完备 | complete | 只要有解,一定找得到 |
| d / b / m | 本课件的记法 | 树的深度 / 每个节点几个孩子 / 最浅解在第几层 |
一个类比:在迷宫里贴着一面墙走
进了一个迷宫,你决定每到一个岔口就先走最左边那条。一路往里走,碰到死路就原路退回上一个岔口,换左边第二条。
你只需要记住从入口到现在这一条路,以及路上每个岔口还有哪些没试过。脑子里装的东西很少。
麻烦在于,如果最左边那条通道特别长,长到走不完,你会一直在里面走下去。出口可能就在入口右手边第二个门后面,你永远轮不到它。
类比在哪里失效:
- 真迷宫的通道总有尽头。搜索树可以无限深,DFS 往下走可能真的永远停不下来。
- 人在迷宫里会认出「这个路口来过」。算法要靠 Close 表专门去记,不记就会在环里打转。
从零讲起
1. 先补一块:栈(补充)
它解决什么问题
DFS 要求「最新发现的节点最先处理」。这需要一个容器,每次吐出来的都是最后放进去的那个。栈就是干这个的。
直觉
食堂洗好的盘子摞成一摞。新洗的放在最上面,拿的时候也从最上面拿。最后放上去的最先被拿走,英文叫 LIFO,Last In First Out,后进先出。
一步一步看
目标:让 A、B、C 依次入栈再出栈一次,看栈为什么总是先吐出最后放进去的那个。
-
A 入栈,栈里只有 A。
-
B 入栈,压在 A 上面。
-
C 入栈,压在 B 上面。现在从栈顶到栈底是 C、B、A。
-
出栈一次,拿走的是栈顶的 C,剩 B、A。
栈只有两个动作:入栈(push,放到栈顶)和出栈(pop,从栈顶拿走)。
怎么判断
拿到一个容器,问一句:最后放进去的,是不是最先出来?是,就是栈。
意思是:栈和队列都是往一头放,区别在从哪头拿。栈从同一头拿,队列从另一头拿。
常见误解
以为函数递归和栈没关系
课件给了 DFS 的递归写法,看起来没有栈。其实每调用一次函数,系统就把它压进函数调用栈,返回时再弹出来,本质和手写的栈一样。
试一下
依次让 P、Q、R 入栈,出栈一次,再让 S 入栈,再出栈一次。两次出栈的分别是谁?最后栈里剩什么?
第一次出栈拿走 R,剩 Q、P。S 压到栈顶,变成 S、Q、P。第二次出栈拿走 S,最后剩 Q、P(Q 在栈顶)。
2. DFS 怎么走
它解决什么问题
和 BFS 一样,手上只有起点、目标和「每个节点能走到哪」。BFS 扫得稳,但要存一整层,层数一深就装不下。DFS 换一种顺序:先往深处走,只存一条路。
从哪来(补充)
DFS 的一个版本,19 世纪就被法国数学家 Charles Pierre Trémaux 研究过,用作走迷宫的策略。迷宫里一条道走到黑、走不通再退回来,正是 DFS 的样子。
出处:Wikipedia: Depth-first search
直觉
把 BFS 的队列换成栈,其余一行不改。
每次从栈顶取一个节点:是目标就停;不是,就把它的孩子压回栈顶。刚压进去的孩子马上又被取出来,所以它总是先往下钻,钻到底才轮到兄弟。
一步一步看
目标:在和 BFS 同一棵树上跟着栈走,看 DFS 先钻完 B 的孩子才轮到 C,Close 顺序和 BFS 不同。
用和 BFS 同一棵树:起点 A,目标 F,孩子从左到右选。栈顶写在左边,压栈时把最先要访问的孩子放在栈顶。青绿粗圈是正在展开的节点,黑圈在 Open 里等着,灰底的进了 Close。
-
开始:Open 只有 A。
-
A 出栈,不是目标,孩子 B、C 入栈,B 在栈顶。
-
B 出栈,孩子 D、E 压在 C 上面。Open 变成 D、E、C。这一步和 BFS 不一样:BFS 下一个处理的是 C,DFS 先钻进 B 的孩子。
-
D 出栈,没有孩子,进 Close;E 出栈,也没有孩子。B 这一支走完了,栈里只剩 C。
-
C 出栈,孩子 F、G 入栈,F 在栈顶。
-
F 出栈,是目标,结束。倒推父节点:F 是 C 生成的,C 是 A 生成的,路径 A-C-F。
同一棵树,BFS 的 Close 是 A B C D E F,DFS 是 A B D E C F:DFS 把 B 的孩子查完才轮到 C。
怎么算
把上面的过程写成伪代码,和 BFS 只差一个词:
DFS(start, goal):
    Open = 栈 [start]
    Close = 空
    while Open 不空:
        n = 出栈(取栈顶)
        if n 是 goal: 顺着父节点倒推出路径,返回
        if n 在 Close 里: 跳过
        把 n 的孩子按「最先要访问的最后压」的顺序压栈,记下父节点是 n
        n 放进 Close
    返回 失败
意思是:每一轮取栈顶、查一下、孩子压回栈顶、它进 Close。孩子从左到右访问,压栈就要从右往左压,最左边的孩子才会落在栈顶。
手算时不用真的倒着压。直接把孩子按访问顺序写在栈的最左边,效果一样。
常见误解
以为孩子的顺序无所谓
DFS 的结果完全取决于先走哪个孩子。课件默认从左到右选,题目改成按字母倒序或从右到左,访问顺序整个会变。做题先看题目给的顺序。
以为 Close 表的顺序和路径一样
Close 记的是访问顺序,上面那题是 A B D E C F;路径要从目标倒推父节点,是 A-C-F。两者要分开写。
试一下
同一棵树,目标改成 G,孩子仍然从左到右选。访问顺序是什么?路径是什么?
A、B、D、E、C、F、G。F 出栈不是目标、没有孩子,接着 G 出栈,是目标。路径 A-C-G。
同一棵树,目标还是 F,孩子改成从右到左选。访问顺序是什么?
A 出栈后 C 在栈顶;C 出栈后 G 在栈顶;G 出栈没有孩子;接着 F 出栈,是目标。访问顺序 A C G F,路径 A-C-F。
3. DFS 为什么会陷进去
它解决什么问题
DFS 省内存,但它的完备性有缺口。这一节讲清楚它在哪里会失败、Close 表能补到什么程度,以及为什么它找到的路常常不是最短的。
直觉
DFS 不到死路不回头。只要左边那支一直有孩子,它就一直往下,右边的兄弟永远排在栈底。
如果左边那支是无限深的,或者图里有环让它绕回原处,DFS 就永远出不来。
一步一步看
目标:在左支无限深、目标只在第 2 层的树上跑 DFS,看它怎样一直往左钻,永远轮不到 G。
-
根 A 有两个孩子:左边 B,右边 C。目标 G 是 C 的孩子,只在第 2 层。
-
DFS 先取 B,B 的孩子压在 C 上面。
-
左边这一支每个节点都有孩子:B 下面是 D,D 下面是 E,E 下面还有,一直没有尽头。
-
栈顶永远是左边那支新生成的节点,C 一直压在栈底,G 永远轮不到。
-
BFS 在同一棵树上,第 2 层就碰到 G 了。
怎么判断
问 DFS 完不完备,分三种情况答:
| 空间 | 不检查重复 | 沿路检查重复(Close 表) |
|---|---|---|
| 有限、无环 | 完备 | 完备 |
| 有限、有环 | 可能绕圈,不完备 | 完备 |
| 无限深 | 不完备 | 仍然不完备 |
意思是:Close 表只挡得住环,挡不住无限深。课件的说法是 complete in finite spaces,「有限空间」这个前提要一起写。
最优性也不保证。DFS 交出的是它第一条碰到的路,那条路不一定最短。
常见误解
以为加了 Close 表 DFS 就完备了
Close 表让 DFS 不会在环里打转,所以在有限空间里完备。树如果无限深,每个节点都是新的,Close 表挡不住,DFS 照样一路往下。
试一下
一张图 S–A、A–B、B–S 三条边构成一个环,另有 S–G。从 S 出发,邻居按字母顺序,DFS 不检查重复状态会怎样?检查了呢?
不检查:S 先走 A,A 走 B,B 又走回 S,S 再走 A……一直在环里绕,永远轮不到 G。检查重复:B 的邻居 S、A 都见过,退回去;最后从 S 走到 G,找到了。
4. DFS 要花多少时间、多少内存
它解决什么问题
DFS 存在的全部理由是省内存。这一节算出它到底省多少,以及时间上要付出什么。
直觉
DFS 任何时刻只关心从根到当前节点这一条路,外加路上每个节点还没试过的兄弟。一个节点的后代全部查完,它就可以从内存里删掉。
时间就没这么好了。最坏情况下目标藏在最右边那支的最底下,DFS 得把整棵树扫完才碰得到。
一步一步看
目标:数 DFS 走到最深处时栈里有多少节点,看它为什么空间只要 O(d·b),时间最坏却到 O(b^d)。
假设每个节点 b 个孩子,树深 d,最浅解在第 m 层。
-
DFS 往下走到第 d 层时,脚下这条路上有 d 个节点。
-
路上每一层,最多还有 b 个兄弟在栈里等着。
-
所以栈里最多大约 d × b 个节点,这是空间。
-
最坏时目标在最右下角,整棵树的节点都要碰一遍,第 d 层就有 b^d 个,这是时间。下图左边是 BFS 存的一整层,右边是 DFS 存的一条路。
怎么算
空间 O(d·b),时间最坏 O(b^d)。
意思是:空间是 d 乘 b,是乘法,随树深线性增长;时间是 b 的 d 次方,是指数。
和 BFS 对比:BFS 时间、空间都是 O(b^(m+1))。DFS 的空间小得多。时间上,指数里 DFS 是 d、BFS 是 m,而 d 可以远大于 m,所以 DFS 的时间通常更差。
注意 O(d·b) 说的是不保存全局 Close 表的树式 DFS。要是把访问过的节点全部存下来,空间就不止这些了。
常见误解
以为 DFS 又省内存又快
省内存是真的,快不一定。它可能一头扎进一条没有解的深分支,在里面浪费大量时间。课件对 DFS 的那句评价就是这个。
试一下
b = 3、d = 20、m = 4。DFS 的空间量级 d·b 是多少?BFS 的空间量级 b^(m+1) 是多少?
DFS:20 × 3 = 60。BFS:3⁵ = 243。DFS 的空间只有几十个节点,BFS 要几百个;树再大一些,差距会按指数拉开。
5. BFS 和 DFS 怎么选
它解决什么问题
两个算法代码只差一个容器,性质却几乎处处相反。考试常把它们摆在一起问,实际用时也得挑一个。这一节把两者并排放好。
直觉
BFS 是先查兄弟再查孩子,一圈一圈往外推。DFS 是先查孩子再查兄弟,一条路钻到底。
一个占内存换来「最短」,一个省内存但什么都不保证。
一步一步看
目标:按数据结构、访问顺序和四把尺子逐条对照 BFS 与 DFS,看两者性质几乎处处相反。
- 先看数据结构:BFS 用队列,DFS 用栈。
- 再看访问顺序:BFS 先兄弟后孩子,DFS 先孩子后兄弟。
- 再拿四把尺子逐条比:
| BFS | DFS | |
|---|---|---|
| 完备性 | 有限分支、有有限深解时完备 | 有环或无限深时不完备;加 Close 表后在有限空间完备 |
| 最优性 | 一定找到边数最少的路 | 不保证 |
| 时间 | O(b^(m+1)) | 最坏 O(b^d),通常更差 |
| 空间 | O(b^(m+1)),很糟 | O(d·b),很好 |
| 典型用途 | 两点间最短路径、找所有连通分量 | 需要回溯的问题、找环、拓扑排序 |
- 最后按题目条件挑。
怎么判断
三条规则按顺序问:
- 要保证边数最少,而且解不深:选 BFS。
- 内存吃紧,又不要求最短:选 DFS。
- 有像样的启发函数:直接上 A*,见 L02b-2。
意思是:先看题目要不要最短,再看内存够不够。两条都卡住时,就该考虑带估计的启发式搜索。
常见误解
答「BFS 慢、DFS 省内存」就当答完了
要点名维度。BFS 的死穴是空间,时间反而通常比 DFS 好;DFS 省空间,但不完备、不最优、最坏时间更差。
试一下
迷宫很大、内存很紧,只要找到任何一条出路就行。选 BFS 还是 DFS?换成「要找最少步数的出路,迷宫不大」呢?
第一种选 DFS:只要一条路、不要最短,内存又紧,DFS 正合适。第二种选 BFS:要最少步数,迷宫不大,内存撑得住。
把它们串起来
DFS 和 BFS 的代码只差一处:Open 用栈,不用队列。
栈后进先出,刚生成的孩子马上被取出来,所以 DFS 总是先往深处钻,钻到底才回头查兄弟。这个顺序让它只需要存一条路和沿途兄弟,空间是 O(d·b)。
同一个顺序也带来它的毛病。左边那支要是无限深,或者图里有环,它就出不来;Close 表能挡住环,挡不住无限深。它交出的是第一条碰到的路,不保证最短;最坏要扫完整棵树,时间 O(b^d)。
两者一对照就是一张表:BFS 拿内存换最短,DFS 拿保证换内存。题目要最短选 BFS,内存紧又不要最短选 DFS。两样都不想放弃,就得给搜索加上「离目标还有多远」的估计。
课件里的坑
- [页码提醒] p.32–33 是同一页动画的两帧,页脚都印着「31」;那棵树里有个节点就叫 S,但起点是 A,别被字母混淆(p.32–33)
- [读题提醒] DFS 的结果依赖孩子的排列顺序,课件默认从左到右选;题目改成别的顺序,答案整个会变(p.29)
- [完备性限定词] 课件写的是 complete in finite spaces,加了 Close 表也只在有限空间完备(p.36)
- [空间口径] O(d·b) 是不额外保存全局访问集合的树式 DFS 的空间(p.38)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写栈的四个字「后进先出」;再拿 21 个节点那棵树,自己画 Open 栈一步步写出访问顺序,对照完整例题;然后过一遍三道课件例题;最后回查两个最容易错的地方:Close 表只让 DFS 在有限空间完备,DFS 的时间通常比 BFS 差。
必背
- DFS 的 Open 表是栈(LIFO):从栈顶取、孩子也压回栈顶,所以先访问孩子、再访问兄弟
- DFS 结果依赖孩子的顺序,课件默认从左到右选;压栈时把最先要访问的孩子放在栈顶
- DFS 在无限深或有环的空间里不完备;沿路检查重复状态(Close 表)后只在有限空间完备,而且不保证最短
- 不保存全局 Close 表的树式 DFS 空间 O(d·b):只存一条路径加沿途兄弟;最坏时间 O(b^d),d 可以远大于 m
- BFS 用队列、费内存、保证边数最少;DFS 用栈、省内存、不保证最短;内存吃紧又不要求最短选 DFS
课件例题
例 1(课件 p.32–33):按 DFS 写出一棵 21 个节点的树的访问顺序
见下方完整例题。
例 2(课件 p.34):八数码用 DFS 展开是什么形状?
题面:同一个八数码问题改用 DFS 展开,课件批注 Never come back until there is a dead end。和 BFS 的展开图比,形状有什么不同?
提示
想一想 BFS 每次扫完哪一部分才往下,DFS 呢。
解答
DFS 不到死路不回头,展开图是又细又长的一条线。BFS 一层扫完再下一层,展开图是又宽又浅的扇形。同一个问题,Open 表换个容器,搜索树的形状就完全不同。
例 3(课件 p.35):DFS 在小图上找到的是哪条路?
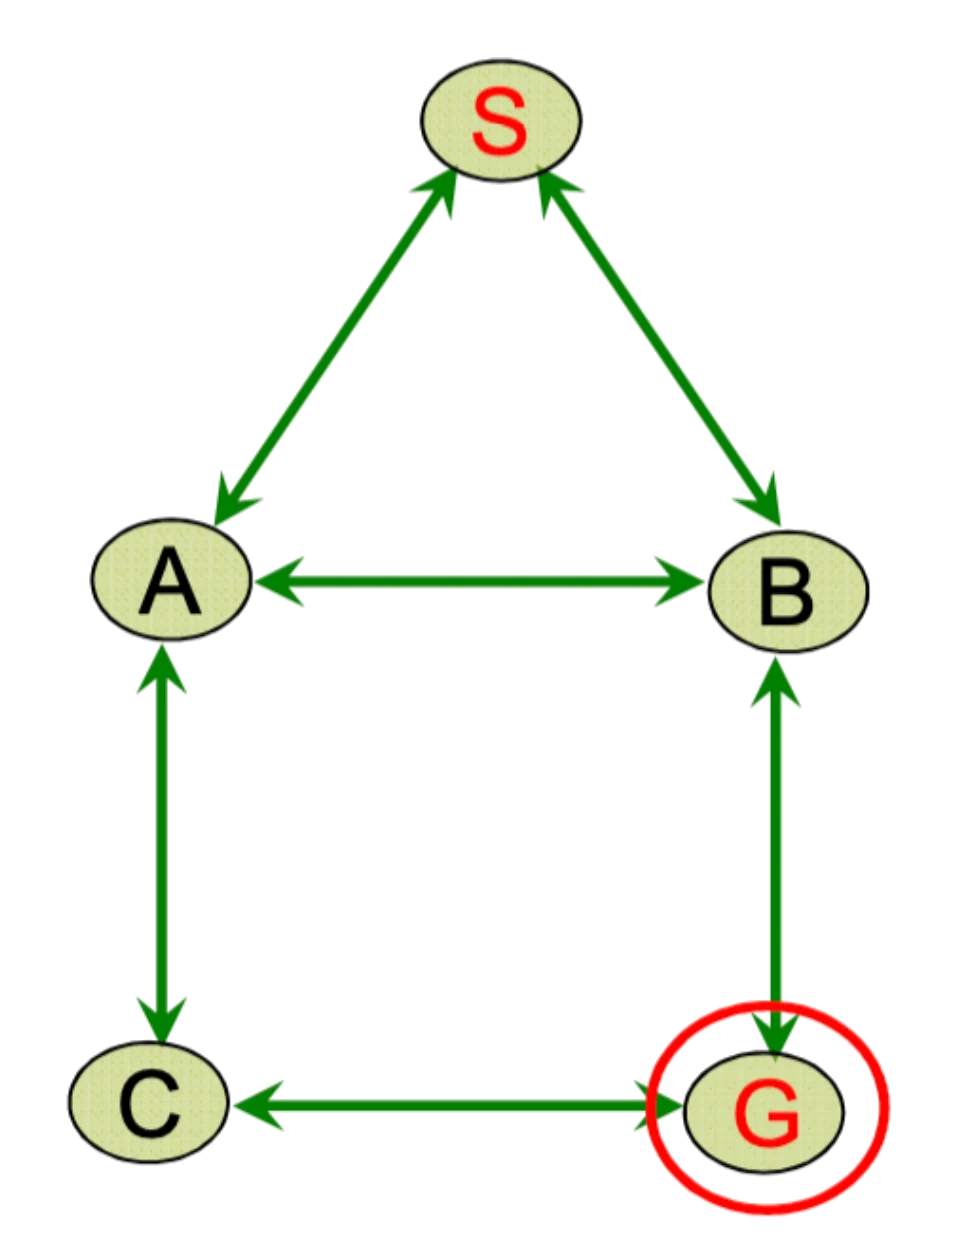
题面:一张无向图,边是 S–A、S–B、A–B、A–C、C–G、B–G。从 S 出发找 G,用 DFS。课件给出的解是哪条路?它是最短的吗?
提示
邻居按字母顺序,S 先走哪个?从那里再一路往下走。
解答
课件里 DFS 从 S 先走 A,再从 A 走到 C,再从 C 走到 G,得到 S-A-C-G,共 3 条边。
图上还有 S-B-G,只有 2 条边,更短。这道题说明 DFS 找到的第一条路通常不是最短的,所以 DFS 不保证最优。
完整例题
题面(课件 p.32–33):一棵 21 个节点的树,起点是 A。A 的孩子是 B、C、D;B 的孩子是 E、F;E 的孩子是 K、L;K 的孩子是 S;L 的孩子是 T;F 的孩子是 M;C 的孩子是 G、H;G 的孩子是 N;H 的孩子是 O、P;P 的孩子是 U;D 的孩子是 I、J;I 的孩子是 Q;J 的孩子是 R。孩子从左到右选,用栈做 DFS,写出访问顺序。
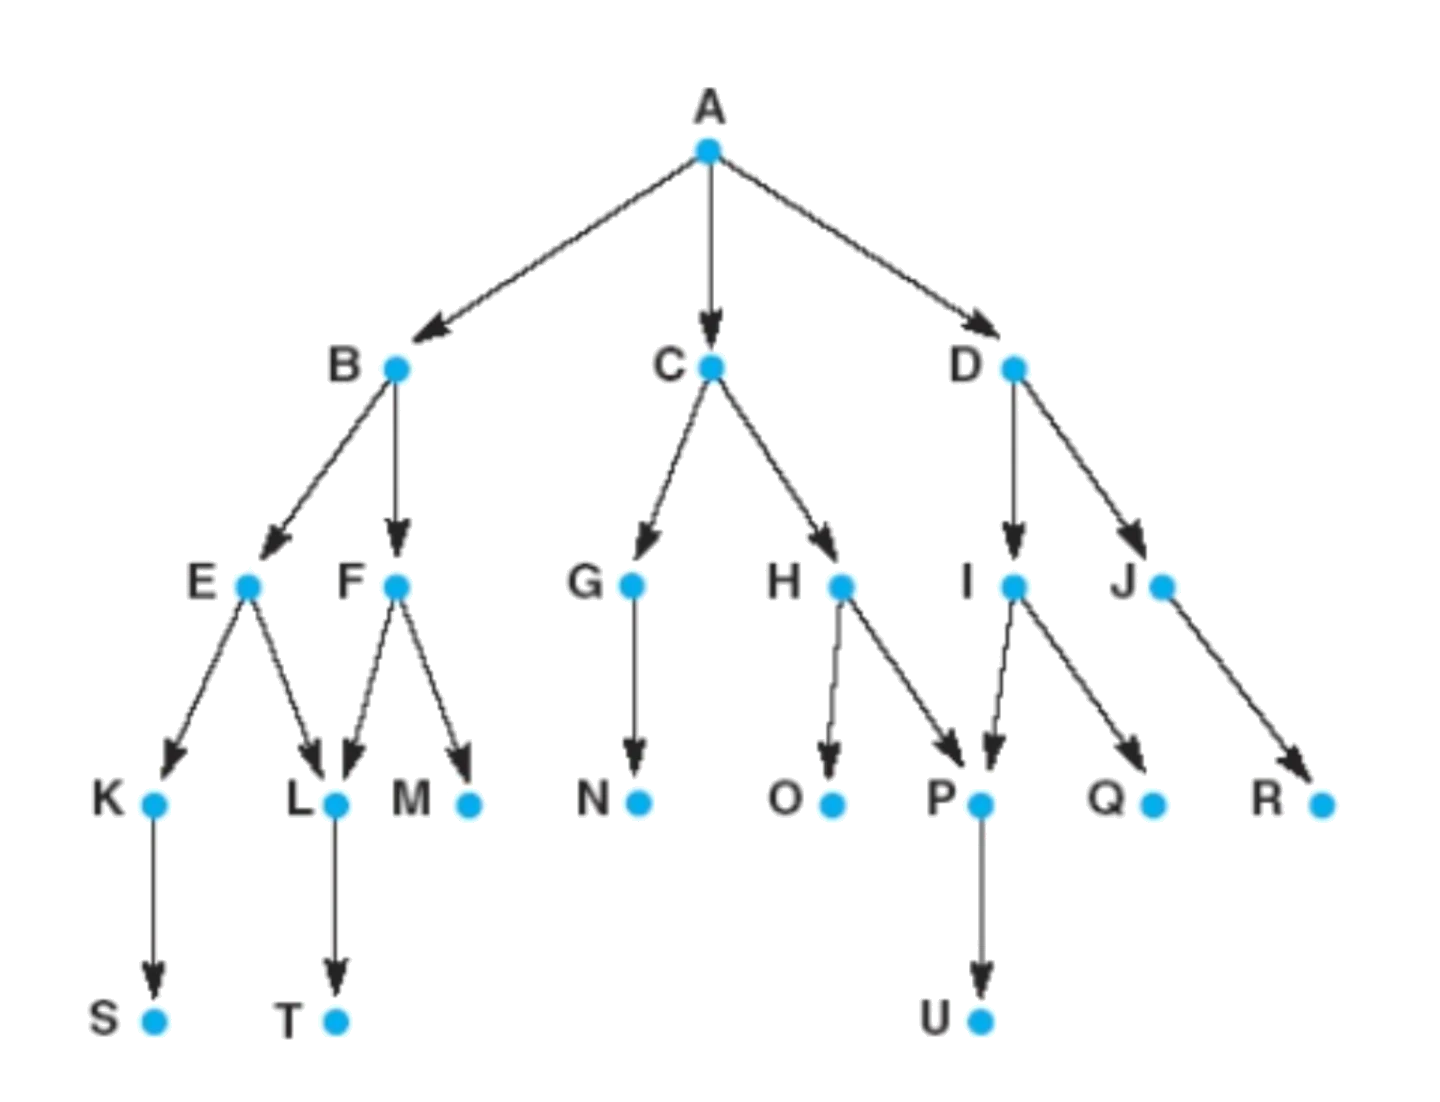
约定:栈顶写在最左边。展开一个节点时,把它的孩子按「最先要访问的放在栈顶」压回去。
解法:
- Open 只有 A。取 A 展开,Open 变成 B, C, D。
- 取 B 展开,Open 变成 E, F, C, D。
- 取 E 展开,Open 变成 K, L, F, C, D。
- 取 K 展开,Open 变成 S, L, F, C, D。这里的 S 只是一个节点名,不是起点。
- 取 S,没有孩子。Open 变成 L, F, C, D。
- 取 L 展开,Open 变成 T, F, C, D。取 T,没有孩子。
- 取 F 展开,Open 变成 M, C, D。取 M,没有孩子。B 这一整支走完了。
- 取 C 展开,Open 变成 G, H, D。取 G 展开得 N,取 N。
- 取 H 展开,Open 变成 O, P, D。取 O;取 P 展开得 U,取 U。
- 取 D 展开,Open 变成 I, J。取 I 展开得 Q,取 Q;取 J 展开得 R,取 R。Open 空了。
- 答案:A B E K S L T F M C G N H O P U D I Q J R。 一共 22 步,最后一步的 Close 表正好就是这个顺序。
要点:DFS 先访问孩子,再访问兄弟。B 下面所有后代访问完,才轮到 B 的兄弟 C。
答题格式:画一张三列表「步 / 展开 / Open」,每行写一次取栈顶;最后单独一行写访问顺序。
变式题(先自己做)
(1) 改编自课件 p.32–33:同一棵树,孩子改成从右到左选,DFS 的前五个访问节点是什么? (2) 改编自课件 p.35:同一张图 S–A、S–B、A–B、A–C、C–G、B–G,DFS 改成邻居按字母倒序访问。找到的路径是什么?是最短的吗? (3) 自编情境:一棵分支因子 b=3 的树,最浅解在第 m=4 层,树深 d=20。BFS 和 DFS 哪个更可能先撑爆内存?哪个更可能跑很久?
提示
(1) 孩子顺序反过来,栈里压回去的顺序也跟着反。(2) 倒序时 S 先走 B。(3) 把 b、m、d 代进 O(b^(m+1))、O(b^d)、O(d·b)。
判分点与答案(非官方评分标准)
判分点:① (1) 要按栈的顺序推,不能凭感觉写;② (3) 时间和空间要分开答,各自点名公式。
(1) A D J R I。A 的孩子从右到左先走 D,D 先走 J,J 往下是 R,R 没有孩子,再回到 D 的另一个孩子 I。
(2) S-B-G。S 的邻居倒序是 B、A,先走 B;B 的邻居倒序是 S、G、A,S 已见过,走 G,到达目标。这次碰巧是最短的 2 条边,但这是孩子顺序凑巧,DFS 本身不保证。
(3) 内存:BFS 的空间是 O(b^(m+1)),要同时存一整层,更容易撑爆;DFS 只存一条路加兄弟,O(d·b)。时间:DFS 最坏 O(b^d),d 远大于 m,可能一头扎进没有解的深分支,更可能跑很久;BFS 只到解那一层。
闪卡自测
1. 栈是什么规则?DFS 为什么用栈?
后进先出(LIFO)。刚生成的孩子最先被取出,所以 DFS 总是先往深处走(p.31)。
2. 把 BFS 改成 DFS 要改哪一处?
只需把 Open 的数据结构从队列换成栈,其余代码几乎一模一样(p.22、p.31)。
3. DFS 的递归写法里栈在哪?
在函数调用栈里。每次递归调用压栈,返回时出栈,本质和手写的栈一样(p.30)。
4. DFS 在什么情况下不完备?加了 Close 表之后能完备到什么程度?
在无限深的空间里、或者有环的空间里会失败。沿路径检查重复状态之后,只能保证在有限空间里完备,无限深的树照样陷进去(p.36)。
5. DFS 的空间为什么是 O(d·b) 而不是指数?
只需要存从根到当前叶子的一条路径,外加路径上每个节点尚未展开的兄弟。路径最长 d 层,每层最多 b 个兄弟,所以是 d × b(p.38)。
6. 为什么 DFS 的时间是 O(b^d),而 BFS 是 O(b^(m+1))?
最坏情况下 DFS 的目标在最右边那支上,得扫完整棵树,所以指数是 d;BFS 不碰比解更深的层,指数是 m。d 可以远大于 m(p.15、p.37)。
7. DFS 和 BFS 谁先访问兄弟、谁先访问孩子?各适合什么用途?
BFS 先兄弟后孩子,适合找两点间最短路径;DFS 先孩子后兄弟,适合需要回溯的问题、找环、拓扑排序(p.39)。
8. p.35 那张图上 DFS 找到哪条路?说明了什么?
S-A-C-G,3 条边;图上有 2 条边的 S-B-G。说明 DFS 不保证最短(p.35、p.36)。
下一讲
盲目搜索讲完了。下一页给搜索加上「离目标还有多远」的估计,从最简单的爬山法开始,见 L02b-1。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。