L02a-2 BFS:像水波一样一圈一圈往外找
从队列讲起,一帧一帧跑一遍广度优先搜索,再推出它为什么总能找到边数最少的路,以及为什么时间还能忍、内存忍不了。
一句话版
BFS(广度优先搜索)从起点出发,先查完离起点 1 步的所有节点,再查 2 步的,再查 3 步的。它一圈一圈往外扩,所以第一次碰到目标时,走的就是边数最少的路。
搜索问题怎么定义、Open 和 Close 两张表是什么,见上一页 L02a-1。这一页从零讲 BFS 一个算法。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| BFS | Breadth-First Search,广度优先搜索 | 一层一层往外扫的找法 |
| 队列 | queue,FIFO(First In First Out) | 排队:先来的先走 |
| 展开 | expand | 把一个节点的下一步(孩子)全部生成出来 |
| Open / Close 表 | 待展开表 / 已展开表 | Open 放排队等着展开的节点,Close 放已经展开过的 |
| 层 / 深度 | level / depth | 离起点几步就在第几层,起点是第 0 层 |
| 分支因子 b | branching factor | 一个节点平均有几个孩子 |
| m | 本课件的记法 | 最浅的那个解在第几层 |
| O(·) | 读「大 O」 | 量级记号,只看增长速度,不看常数 |
一个类比:往池塘里丢一颗石子
石子落水的地方是起点。水波一圈一圈往外推:第一圈碰到的是离落点最近的东西,第二圈稍远,第三圈更远。哪样东西先被波纹碰到,它就离落点最近。
BFS 找目标就是这样。第 1 圈是离起点 1 步的节点,第 2 圈是 2 步的节点。目标在哪一圈第一次被碰到,到它最少就要走几步。
波纹也有代价:圈越往外,周长越长。搜索树里每往外一圈,节点数要乘一次 b。BFS 得把最外面那一整圈都攥在手里,所以它最先撑不住的是内存。
类比在哪里失效:
- 水波是同时往外推的。BFS 一次只处理一个节点,靠队列排好先后,整体看上去才像一圈一圈。
- 池塘里的远近是真实距离。搜索里的远近只数走了几条边,不管每条边有多长,这一点在第 3 个概念里会变成 BFS 的前提。
从零讲起
1. 先补一块:队列(补充)
它解决什么问题
BFS 要求「先发现的节点先处理」。这需要一个容器,能记住节点进来的先后,每次吐出来的都是最早进来的那个。队列就是干这个的。
直觉
食堂排队打饭。新来的人站到队尾,窗口只叫队首的人。谁先来谁先走,没人能插队。英文叫 FIFO,First In First Out,先进先出。
一步一步看
目标:让 A、B、C 依次排队再叫一次号,看队列为什么总是先吐出最早进来的那个。
-
A 来排队,队列里只有 A。
-
B 来了,站到 A 后面。
-
C 来了,站到 B 后面。现在从前到后是 A、B、C。
-
窗口叫人,走的是站在最前面的 A,队列剩 B、C。
队列只有两个动作:入队(enqueue,加到队尾)和出队(dequeue,从队首取走)。
怎么判断
拿到一个容器,问一句:最先放进去的,是不是最先出来?是,就是队列。
反过来,最后放进去的最先出来,像一摞盘子只能从顶上拿,那是栈(stack,LIFO)。DFS 用的就是栈,见 L02a-3。
常见误解
以为队列和栈只是名字不同
两者放进去的方式一样,都是往一头加。区别在取出来的那一头:队列从另一头取,栈从同一头取。BFS 和 DFS 的所有差别都从这一处来。
试一下
依次让 P、Q、R 入队,出队一次,再让 S 入队,再出队一次。两次出队的分别是谁?最后队列里剩什么?
第一次出队走 P,剩 Q、R。S 排到 R 后面,变成 Q、R、S。第二次出队走 Q,最后剩 R、S。
2. BFS 怎么走
它解决什么问题
你手上有一个起点、一个目标,还知道每个节点能走到哪些节点。除此之外什么都不知道,也看不出往哪边离目标更近,只能判断「这个是不是目标」。BFS 给出一种固定的扫法,保证不漏、不重,而且第一次找到目标时用的边数最少。
从哪来(补充)
最早写下 BFS 的是德国工程师 Konrad Zuse。他 1945 年用它求图的连通分量,这部分写在他被拒的 Plankalkül 博士论文里,直到 1972 年才发表。
1959 年,Edward F. Moore 又独立想出了它,用来找走出迷宫的最短路。C. Y. Lee 后来把它发展成电路板的布线算法,1961 年发表。迷宫和布线问的是同一件事:从这里到那里,最少要走几步。
出处:Wikipedia: Breadth-first search
直觉
先把起点排进队列。然后每次从队首叫一个节点出来:是目标就停;不是,就把它的孩子排到队尾。
浅层的节点总是先排进去,所以队列会自然地把一层处理完,再轮到下一层。你不用专门去数层数,队列替你数了。
一步一步看
目标:在同一棵树上逐帧跟着队列走,看 BFS 怎样一层查完才下一层,最后倒推出 A-C-F。
下面这棵树,起点 A,目标 F,孩子从左到右入队。每一帧里,青绿粗圈是这一步正在展开的节点,黑圈在 Open 里排队,灰底的已经进了 Close,浅灰细圈是还没被生成出来的节点。
-
开始:Open 只有起点 A,Close 是空的。
-
A 出队,不是目标,展开它:孩子 B、C 排进队尾。A 进 Close。
-
B 出队,展开:D、E 排到 C 后面。Open 变成 C、D、E,Close 是 A、B。
-
C 出队,展开:F、G 排到队尾。目标 F 已经被生成出来了,但还轮不到它,前面还排着 D、E。
-
D 出队,没有孩子,直接进 Close;E 也一样。Open 剩 F、G。
-
F 出队,是目标,搜索结束。顺着「谁生成了谁」倒推:F 是 C 生成的,C 是 A 生成的,所以路径是 A-C-F。
怎么算
把上面的过程写成伪代码:
BFS(start, goal):
    Open = 队列 [start];标记 start 为已见过
    Close = 空
    while Open 不空:
        n = 出队(取队首)
        if n 是 goal: 顺着父节点倒推出路径,返回
        for n 的每个孩子 c(按题目给的顺序):
            if c 没见过:
                标记 c 为已见过;记下 c 的父节点是 n
                c 入队(加到队尾)
        n 放进 Close
    返回 失败
意思是:每一轮只做四件事,取一个、查一下、孩子排队、它进 Close。
三处最容易写错。第一,「已见过」要在入队时标记;等到出队才标记,同一个节点会被不同的父节点重复排进队列。第二,目标检查放在出队那一刻。第三,孩子按题目给的顺序入队,顺序一变,Close 的顺序跟着变。
课件还给了一种不用队列的写法,按层写集合:
- L₀ = {起点}
- L₁ = 起点的所有邻居
- L_{i+1} = 从 L_i 一步能走到、并且之前没出现过的节点;某一层为空就停
意思是:L_i 里装的,恰好是离起点 i 步的全部节点。上面那棵树里,L₀ = {A},L₁ = {B, C},L₂ = {D, E, F, G}。
常见误解
以为 Close 表的顺序就是路径
Close 记的是访问顺序,上面那题是 A B C D E F。路径要靠父节点倒推,是 A-C-F。题目可能两样都问,别交错。
以为「已见过」等到出队再标记也一样
在有环的图里,一个节点可能被两个父节点先后生成。出队才标记的话,它会在队列里出现两次,白白多展开一遍;图大了以后,重复的节点会成片出现。
试一下
同一棵树,起点 A,目标改成 G,孩子仍然从左到右入队。Close 表最后是什么?路径是什么?
Close 是 A B C D E F G。F 出队时不是目标,没有孩子,进 Close;接着 G 出队,是目标。G 是 C 生成的,C 是 A 生成的,路径是 A-C-G。
同一棵树,目标还是 F,但孩子改成从右到左入队。访问顺序是什么?
A 出队后 C、B 入队;C 出队后 G、F 排在 B 后面;B 出队后 E、D 排到最后。接着 G 出队,然后 F 出队,是目标。访问顺序 A C B G F,路径仍是 A-C-F。
3. 为什么 BFS 一定找到最短的路
它解决什么问题
课件的原话是 BFS ALWAYS finds the shortest path,ALWAYS 全大写。这一节讲清楚它凭什么这么肯定,以及这个「最短」带着什么前提。
直觉
队列里永远是浅的排在前面。离起点 2 步的节点全部出队之前,3 步的节点一个都轮不到。
所以目标第一次出队时,比它更浅的地方都已经查过了,那里没有目标。不存在更短的路。
一步一步看
目标:跟着队列里层数的变化走,看出目标出队前浅层已全部查完,所以 BFS 找到的路边数最少。
- 起点在第 0 层,入队。
- 第 0 层出队时,它的孩子(第 1 层)全部排到队尾。
- 第 1 层的节点一个个出队,它们的孩子(第 2 层)全部排在第 1 层的后面。
- 一直这样下去,队列从前到后,层数只会保持不变或者加 1,不会倒回去。
- 目标在第 k 层。它出队之前,第 0 层到第 k−1 层已经全部查完,没有目标。所以到它最少就是 k 步。
拿上一节那棵树对一下:
| 层 | 节点 | 第几个出队 |
|---|---|---|
| 0 | A | 第 1 个 |
| 1 | B、C | 第 2、3 个 |
| 2 | D、E、F、G | 第 4 到 7 个;F 是第 6 个出队,到它就停了 |
怎么判断
说 BFS「完备并且最优」,三个前提要一起写出来:
- 有限分支:每个节点的孩子个数有限。否则第 1 层就永远扫不完。
- 有有限深的解:解在某个有限的层上。否则永远扫不到那一层,BFS 一直跑下去。
- 最短按边数算:每条边的代价不一样时,边数最少的路不一定最便宜。那种情况要用一致代价搜索或 A*,见 L02b-2。
判断题碰到「BFS 一定找到最优解」,先看边的代价是不是都一样。
常见误解
以为 BFS 找到的一定是代价最小的路
BFS 只数边,不看边上的代价。所有边代价相同时,边数最少就是代价最小;代价不同时,两者可以不一样。课件写的 shortest path 指的是边数最少。
试一下
从 S 到 G 有两条路:S 直连 G 的一条边,代价 10;S-A-G 两条边,每条代价 1。BFS 交出哪条路?它的代价是最小的吗?
BFS 交出 S-G:G 在第 1 层,A-G 那条要到第 2 层才碰得到。它只用了 1 条边,边数最少;代价是 10,而 S-A-G 的代价只有 2。所以这里 BFS 不是代价最优。
4. BFS 要花多少时间、多少内存
它解决什么问题
知道 BFS 一定找得到,下一个问题是找得起吗。时间看总共要生成多少节点,空间看同一时刻要存多少节点。
直觉
每往下一层,节点数乘 b。这种每次乘同一个数的数列有个特点:b 至少是 2 时,最后一项比前面所有项加起来还大。所以估总量时只看最深那一层就够了。
BFS 找到目标那一刻,最深那一整层都还排在队列里,所以内存也和这一层一样大。
一步一步看
目标:一层层数出生成的节点,看 BFS 找到目标时队列里躺着一整层,时间和空间都到 O(b^(m+1))。
假设每个节点都有 b 个孩子,最浅的解在第 m 层。
-
一层一层数:第 0 层 1 个节点,第 1 层 b 个,第 2 层 b² 个,第 i 层 b^i 个。
-
最坏情况,目标是第 m 层最后一个出队的节点。它出队之前,同一层的其他节点都展开过了,它们的孩子已经排进队列。这些孩子在第 m+1 层,接近 b^(m+1) 个。
-
加起来,一共生成了 1 + b + b² + … + b^m,再加上接近 b^(m+1) 个。最后一项最大,量级是 O(b^(m+1)),这是时间。
-
找到目标那一刻,第 m+1 层那一大批节点同时躺在队列里,所以空间也是 O(b^(m+1))。下图左边是 BFS 要存的一整层,右边是 DFS 只存的一条路。
怎么算
时间和空间都是 O(b^(m+1))。
意思是:要处理和要存的节点数,都大约按 b 的 m+1 次方增长。b 大一点、解深一层,数字都会成倍放大。
代进数字:b = 10、m = 10 时,b^(m+1) = 10¹¹,也就是一千亿个节点,任何机器都装不下。时间还可以等,内存不够程序就直接崩了,这就是课件说 BFS 非常吃内存的原因。
指数上是 m,没有用到树的总深度 d。BFS 到第 m 层就找到了,比它更深的层根本不会去碰。
常见误解
以为 BFS 的主要问题是慢
时间和空间同阶,但两者的后果不一样:时间不够可以多等一会儿,内存不够程序直接崩。考试问 BFS 的缺点,要点名是空间。
把 m 写成 d
本课件 d 是搜索树的深度,m 是最浅解的深度,而且 d 可以远大于 m。不少教材的这两个字母正好反过来,考试按本课件的写法答。
试一下
一棵树每个节点 3 个孩子,最浅的解在第 4 层。第 4 层有多少个节点?BFS 的时间量级 b^(m+1) 是多少?
第 4 层有 3⁴ = 81 个节点。b^(m+1) = 3⁵ = 243。前 4 层合起来 1 + 3 + 9 + 27 = 40,比第 4 层的 81 还少,所以估量级只看最深那层。
把它们串起来
BFS 只做一件事:按离起点的步数,从近到远一个一个查。
排出这个先后的是队列。先进先出,保证了浅层的节点一定先出队,所以第一次碰到目标时,走的边数最少。这个结论成立要三个前提:有限分支、有有限深的解、只数边不看代价。
同一件事也决定了它的代价。要从近到远查,就得把当前最外面那一整圈都排在队列里,而每往外一圈就乘一次 b。时间和空间都是 O(b^(m+1)),时间能等,内存等不了。
放到八数码这种具体问题上,每个盘面是一个节点,孩子个数由空格的位置决定:角上 2 个、边上 3 个、中心 4 个,再减掉走回父节点的那一步。这个数就是分支因子 b 的来源。
下一页的 DFS 只改一处:把队列换成栈。它省下了内存,也丢掉了「最短」的保证。
课件里的坑
- [口径差异] 课件定义 d 是搜索树深度、m 是最浅解的深度,所以 BFS 的复杂度写 O(b^(m+1))。不少教材这两个字母正好相反,考试按本课件这套记(p.15、p.25)
- [伪代码细节] 课件的 BFS 伪代码要盯住三处:visited 在入队时标记、目标检查的位置、孩子入队的顺序。考试写伪代码时这三处写对就算对(p.22)
- [最短的含义] 课件写 ALWAYS finds the shortest path,这里的最短是边数最少;边代价不同时 BFS 不保证代价最小(p.24)
- [页码提醒] PDF 第 20 页是一整页 BFS 示意图,页脚没有编号,从第 21 页起页脚印的页码比 PDF 实际页码少 1。本页引用的页码都按 PDF 实际页码(p.20–21)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写队列的四个字「先进先出」,再在纸上画一棵三层小树,自己跑一遍 BFS,写出每一步的 Open 和 Close;然后过一遍两道课件例题;最后回查两个最容易错的地方:最短指边数,BFS 的死穴在空间。
必背
- BFS 的 Open 表是队列(FIFO):从队首取、孩子加到队尾,所以同一层的节点一定先于下一层被展开
- 有限分支、有有限深解时 BFS 完备,并且找到边数最少的路径;边的代价不同时它不保证代价最小
- BFS 时间 O(b^(m+1)),m 是最浅解的深度:它不会去碰比解更深的层,指数上是 m 不是 d
- BFS 空间也是 O(b^(m+1)),要同时存一整层,这是它的死穴:b=10、m=10 时约 10¹¹ 个节点
- 八数码后继数:空格在角 2、边 3、心 4,再减掉回到父节点的那一步;visited 在入队时标记,避免同一节点重复入队
课件例题
例 1(课件 p.17–19):按 BFS 写出 Open 表和 Close 表的每一步
见下方完整例题。
例 2(课件 p.23):八数码 BFS 里为什么这个节点只展开出一个孩子?
题面:根盘面第一行 2 8 3,第二行 1 6 4,第三行「7 空格 5」。它的一个孩子是空格左移后的盘面:第一行 2 8 3,第二行 1 6 4,第三行「空格 7 5」。课件问:为什么这个孩子往下只展开出一个新节点?
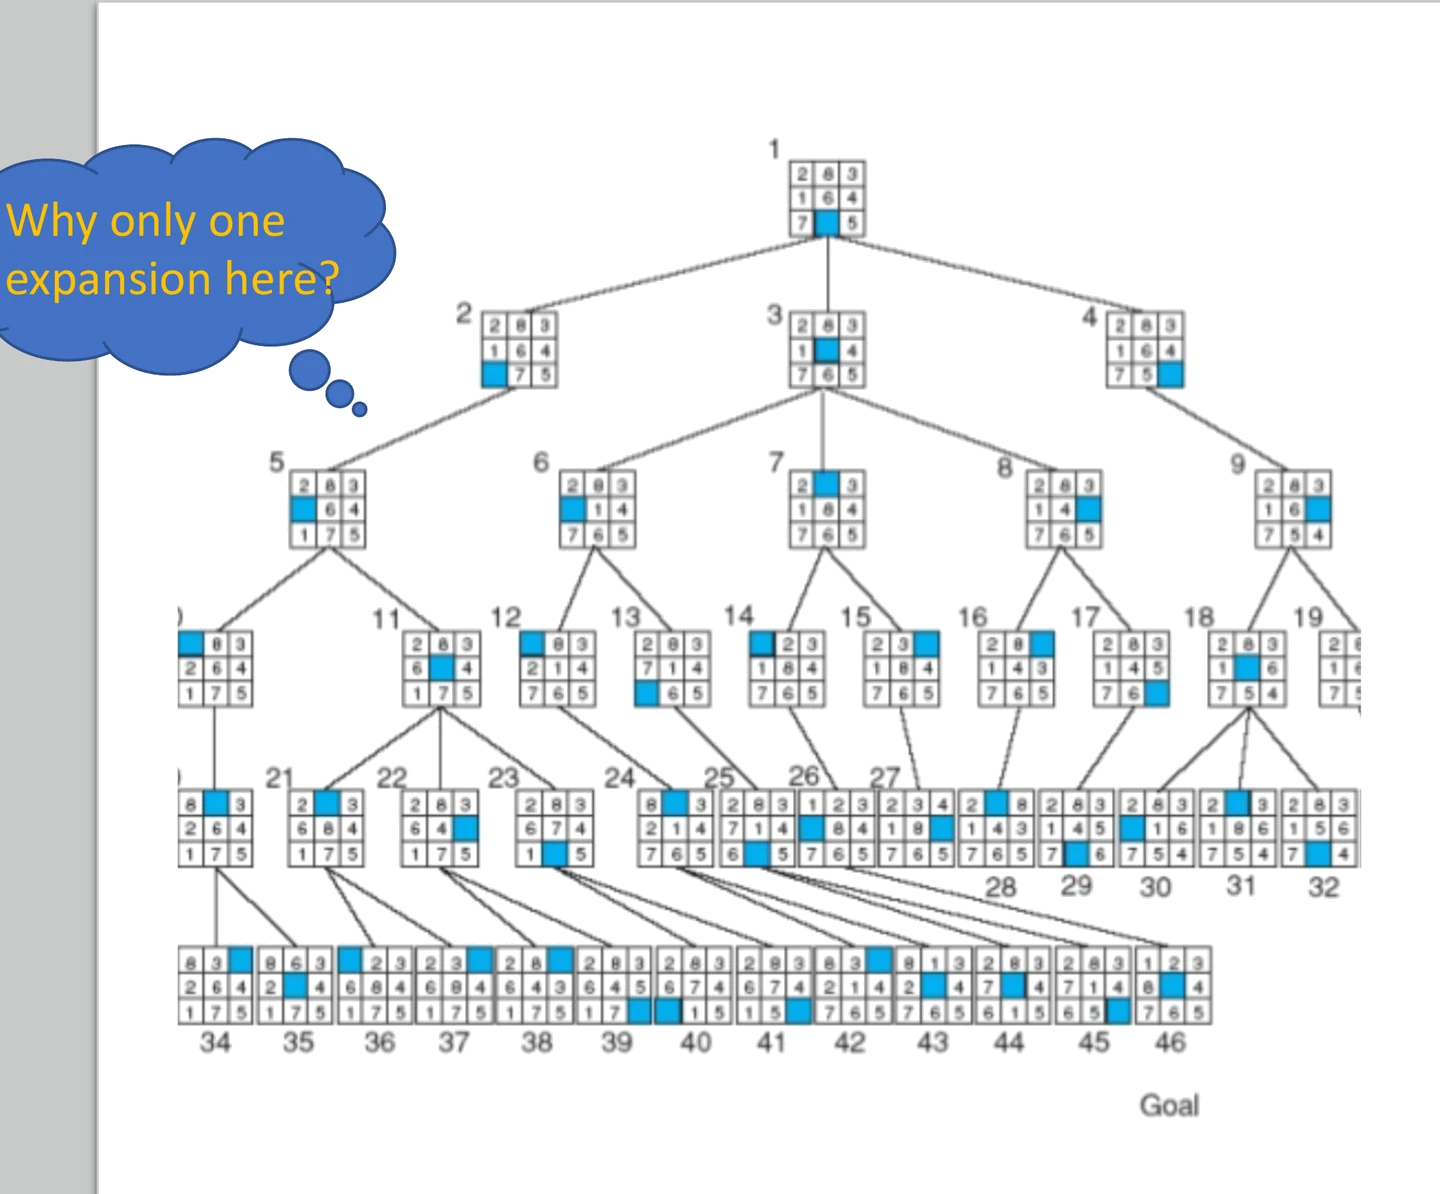
提示
先看空格在根盘面里是在角上、边上还是中心,再看左移以后它到了哪里。
解答
先数根:空格在底边中间,是边,有 3 个动作(上、左、右),所以根有 3 个孩子。
再数这个孩子:空格到了左下角,角上只有 2 个动作,上和右。「右」正好把空格移回原位,那个状态已经见过了。2 个动作减去 1 个回头路,只剩 1 个新孩子:第一行 2 8 3,第二行「空格 6 4」,第三行 1 7 5。
口诀:角 2、边 3、心 4,再减掉回到父节点的那一步。
完整例题
题面(课件 p.17–19):一棵树,根是 1。1 的孩子是 2、3、4;2 的孩子是 5、6;4 的孩子是 7、8;5 的孩子是 9、10;7 的孩子是 11、12;其余节点没有孩子。目标是节点 11。孩子从小到大入队,用 BFS 搜,写出每一步的 Open 表和 Close 表。
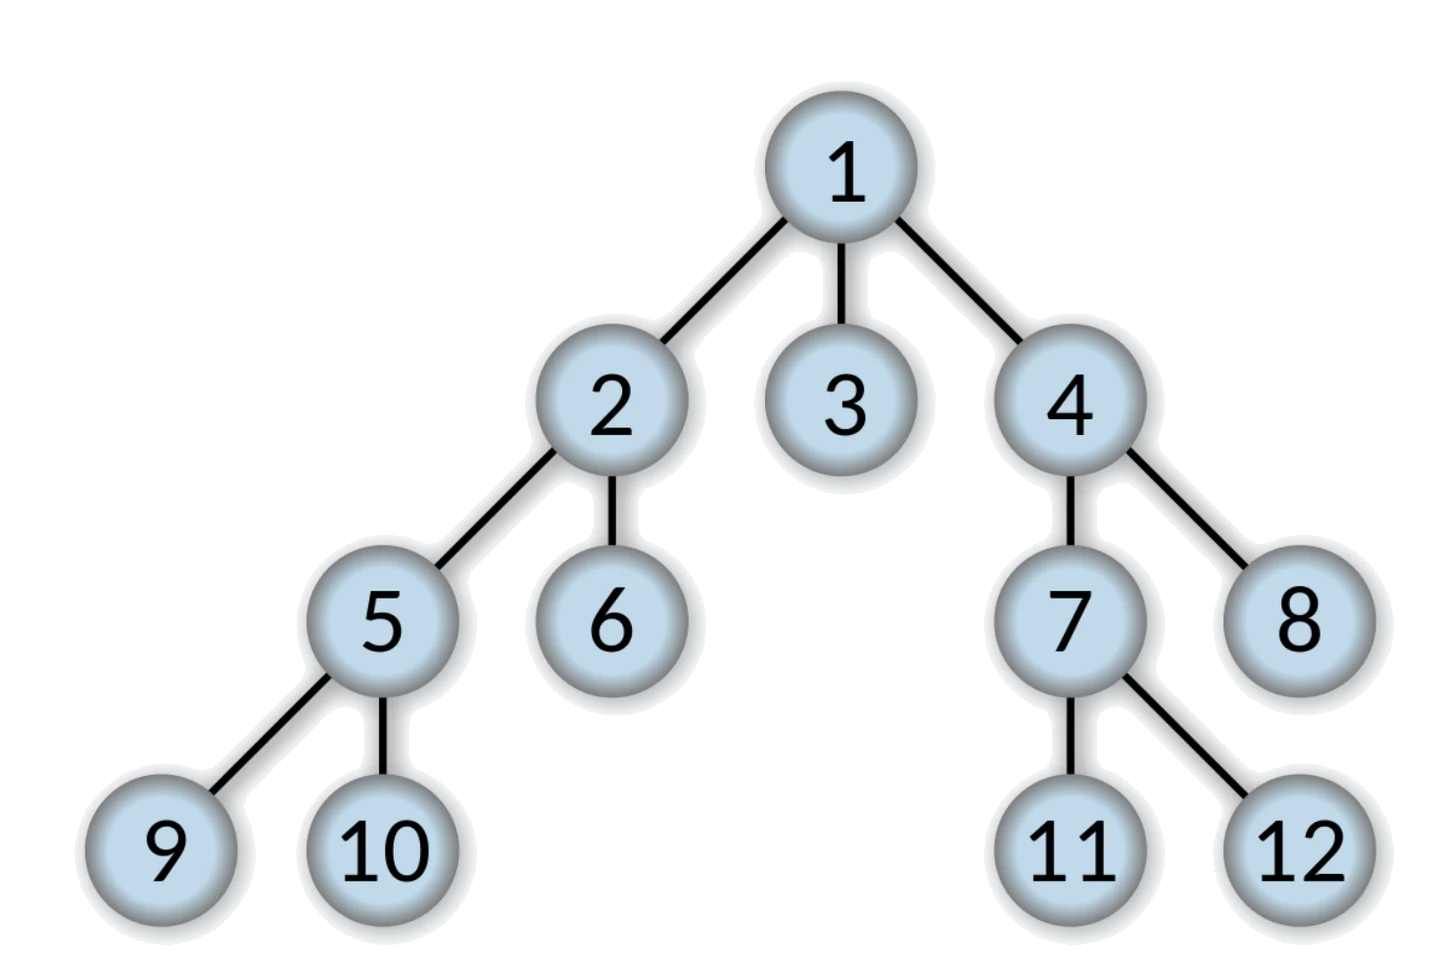
约定:Open 的队首写在最左边。每一步从队首取一个,是目标就停,不是就把孩子加到队尾、它自己进 Close。
解法:
- Open [1],Close []。
- 取 1 展开:Open [2,3,4],Close [1]。
- 取 2 展开:Open [3,4,5,6],Close [1,2]。
- 取 3,没有孩子:Open [4,5,6],Close [1,2,3]。
- 取 4 展开:Open [5,6,7,8],Close [1,2,3,4]。
- 取 5 展开:Open [6,7,8,9,10],Close [1,2,3,4,5]。
- 取 6,没有孩子:Open [7,8,9,10],Close [1,2,3,4,5,6]。
- 取 7 展开:Open [8,9,10,11,12],Close [1,2,3,4,5,6,7]。
- 取 8:Open [9,10,11,12],Close 加上 8。
- 取 9:Open [10,11,12],Close 加上 9。
- 取 10:Open [11,12],Close 到 10 为止。
- 队首取出 11,它就是目标,搜索结束。倒推父节点:11 是 7 生成的,7 是 4 生成的,4 是 1 生成的,路径是 1-4-7-11。
要点:同一层的兄弟一定在它们的孩子之前被访问,这就是队列的效果。11 在第 3 层,到它最少 3 条边。
答题格式:画一张三列表「步 / 取出 / Open / Close」,每行写一次出队;最后单独写访问顺序和路径。
变式题(先自己做)
(1) 改编自课件 p.35:一张无向图,边是 S–A、S–B、A–B、A–C、C–G、B–G。从 S 出发用 BFS 找 G,邻居按字母顺序入队。写出 Close 的顺序和找到的路径。 (2) 同一棵 1 到 12 的树,目标改成 8。到找到为止 Close 是什么?路径是什么? (3) 自编情境:一棵树分支因子 b = 3,最浅的解在第 m = 4 层,树深 d = 20。BFS 的时间和空间量级各是多少?为什么不用 d?
提示
(1) 图里有环,入队时要查「已见过」,见过的不再入队。(2) 照完整例题一步步写,到 8 出队就停。(3) 代进 O(b^(m+1)),再想想 BFS 会不会去碰第 m+1 层以下。
判分点与答案(非官方评分标准)
判分点:① (1) 要写出逐步过程,不能只给路径;② (3) 时间和空间要分开答,都点名公式。
(1) S 出队,A、B 入队;A 出队,邻居 S、B 已见过,C 入队;B 出队,G 入队;C 出队,邻居都见过;G 出队,是目标。Close 顺序 S A B C G,路径 S-B-G,2 条边。
(2) Close 是 1 2 3 4 5 6 7 8,8 出队时就是目标。8 是 4 生成的,4 是 1 生成的,路径 1-4-8。
(3) 时间和空间都是 O(3⁵),也就是量级 243。BFS 在第 4 层就找到解,最多碰到第 5 层,第 6 层到第 20 层一个都不会生成,所以 d = 20 不进公式。
闪卡自测
1. 队列是什么规则?BFS 为什么要用队列?
先进先出(FIFO):从队尾进,从队首出。BFS 要先处理先发现的节点,浅层的节点先入队,所以同一层一定先于下一层出队(p.18、p.22)。
2. BFS 每一轮做哪几件事?
从队首取一个节点;是目标就停;不是就把没见过的孩子加到队尾,并标记它们已见过;它自己进 Close(p.18、p.22)。
3. visited 应该在入队时标记还是出队时标记?为什么?
入队时。出队才标记的话,同一个节点会被不同的父节点重复排进队列(p.22)。
4. Close 表的顺序和找到的路径是一回事吗?
不是一回事。Close 是访问顺序;路径要从目标顺着父节点倒推回起点。
5. BFS 完备、最优要哪几个前提?「最短」指什么?
有限分支、存在有限深的解;最短指边数最少,边代价不同时不保证代价最小(p.24)。
6. BFS 的时间和空间各是多少?m 是什么?
都是 O(b^(m+1))。m 是最浅解的深度,b 是分支因子(p.15、p.25、p.26)。
7. 为什么说 BFS 的死穴是空间而不是时间?
它要同时把一整层节点存在队列里。b=10、m=10 时约 10¹¹ 个节点,任何机器都装不下;时间还能等,内存不够就直接崩(p.26)。
8. 八数码里空格在角、边、中心各有几个后继?
角 2、边 3、心 4。展开时再减掉走回父节点的那一步(p.9、p.23)。
9. 用分层集合写 BFS,L_{i+1} 怎么定义?
从 L_i 一步能走到、并且之前没出现过的节点。L_i 里恰好是离起点 i 步的全部节点(p.21)。
下一讲
把队列换成栈,BFS 就变成 DFS:省下内存,代价是可能一头扎进死胡同。见 L02a-3。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。