L10e 论文工厂与撤稿缺口:把视角从个人拉到整个系统
从零讲清课件最后一部分:研究记录怎样被污染,论文工厂作为一门生意卖什么、怎样过同行评审这道门,被撤的和该撤的差 20 倍,撤稿数量和各国撤稿率怎么读,机器速度的检测,四方各担的责任,激励链与评价改革,以及按下回车前要问的四个问题。
L10d 讲的是个人层面:守则要写成能修订的活指南,用了 AI 要按 WHEN、WHAT、WHERE 写清楚。这一页把视角拉到整个出版系统。
一句话版
有问题的论文会混进发表记录,撤得少、撤得慢;论文工厂借生成式 AI 把造假做成了按篇收费的生意。检测、各方责任和评价改革一起才能修,落到每个研究者身上是按回车前的四个问题。
先认识这几个词
| 词 | 英文 | 一句人话 |
|---|---|---|
| 撤稿 | retraction | 期刊正式宣布一篇已发表的论文作废 |
| 论文工厂 | paper mill | 按订单代写、编数据、卖署名的造假生意 |
| 劫持期刊 | hijacked journal | 仿冒一本名刊的名字、封面和网站,收钱不发表 |
| 守门人 | gatekeeper | 决定稿件能否发表的编辑和审稿人 |
| 引用刷量 | citation boosting | 一伙论文互相引用,把引用数抬上去 |
| 扭曲短语 | tortured phrasing | 把固定术语换成怪异同义词,常见于改写造假稿 |
| 系统综述 | systematic review | 按固定方法汇总某个问题上全部研究的论文 |
| 评价改革 | assessment reform | 改变招聘和晋升时用来衡量研究者的标准 |
一个类比:混进假货的食品供应链
一家工厂专做仿冒食品,贴上名牌包装。要进超市就得过质检,它就收买质检员,或者仿一家超市的门面收了货款不上架。
就算发现了问题,召回的只是一小部分,已经卖出去的还在被人吃。
商场可以装更快的扫描仪,但只要采购员按进货数量拿奖金,假货的需求就不会消失。
类比在哪里失效:
- 买假食品的人多半是被骗的;论文工厂的顾客常常知道自己买的是什么,只有劫持期刊那种情况,投稿人才是受害者。
- 召回的食品会下架;撤稿后的论文仍然在被引用。
- 食品检测查的是成分;论文检测看的是图像、文字、引用和统计里的异常信号,标出来的是嫌疑。
从零讲起
1. 被污染的研究记录
它解决什么问题
前几页讲个人怎样用好 AI。这里先问一个系统层面的问题:一篇有问题的论文发表以后,会造成什么影响?
直觉
已发表的论文是后来者的地基:别人引用它、汇总进综述、写进指南。
一篇坏论文混进来,影响会沿着引用一路往下传。
一步一步看
目标:沿着三个环节,看一篇坏论文怎样一路污染到指南。
-
列出课件给的三个环节和每一环的说法。
环节 课件原话 范围词 混进发表 Fraudulent or unethical articles slip past peer review sometimes(有时) 撤稿不足 Many are never retracted, and retracted papers are still cited many(许多) 记录被污染 三个后果,见下一步 无 -
写出三个后果:研究者追着错误线索做下去;系统综述把坏论文一起汇总进去;循证指南被带偏。
-
注意范围词:课件说的是「有时」通过评审、「许多」没被撤,没有说全部。
怎么判断
判断口诀:坏论文的危害看它被谁用了,用得越往下游,影响越大。
| 谁在用 | 被污染后会怎样 |
|---|---|
| 单个研究者 | 沿着错误线索浪费时间和经费 |
| 系统综述 | 汇总结论被坏数据拉偏 |
| 循证指南 | 指导实践的建议跟着出错 |
常见误解
误解:坏论文只要被撤稿,问题就解决了
课件写的是 retracted papers are still cited:撤了之后仍然有人在引用。撤稿只是更正的一步。
误解:课件说多数造假论文都能通过同行评审
课件用的是 sometimes(有时)。答题时保留这个范围词,不要升级成「通常」或「全部」。
试一下
一篇编造数据的药物论文被三篇综述引用,其中一篇综述又被写进治疗指南。这篇论文后来被撤稿了。污染会自动消失吗?
答案
不会。撤稿只作废了原论文,三篇综述和那份指南还在。课件说的后果正是综述受损、指南被带偏,它们要各自更正。
2. 论文工厂:一门按篇收费的生意
它解决什么问题
造假过去多是个人行为。课件提醒,现在有专门的生意在批量生产假论文,生成式 AI 让它更便宜、更快。
直觉
论文工厂是一门生意,这门生意由四项服务组成:按订单写稿、编造数据、保证录用、按篇开发票。
它过去缺的是产能。生成式 AI 补上了这块:稿子要多少有多少,任何领域都写,随时都能写,格式统一。
它卖给顾客的产品是一份看起来像科学的资格凭证,用来评职称、拿学位、过考核。
一步一步看
目标:把论文工厂卖的东西和它过门的方法拆开看。
-
先看下图上排:工厂卖的三样商品。
-
署名买卖:稿子按订单写好,作者位置单独卖。买家可能什么都没做,这正是商品本身。
-
引用刷量:一伙同盟论文互相引用,数字上去了,科学没往前走。卖的名义是「曝光度」,按每次引用计价。
-
编辑通道:一个能被说动的编辑,或一本能被冒充的期刊。两种方式都是从门里面把门打开。
-
再看下排两种过门方式。劫持期刊仿得和名刊一模一样,收了费,论文哪里都没发表。被收买的守门人让质量控制变成走过场,工厂只要拿到一把钥匙。
怎么判断
判断口诀:先问买家买到了什么,再问稿子从哪道门进去。
| 情况 | 属于哪一类 |
|---|---|
| 交钱后名字被加进一篇自己没参与的论文 | 署名买卖 |
| 一批论文互相大量引用,彼此内容关系不大 | 引用刷量 |
| 编辑收钱保证录用 | 编辑通道 / 被收买的守门人 |
| 投稿网站和名刊几乎一样,交了费却查不到发表 | 劫持期刊 |
常见误解
误解:论文工厂的顾客都是被骗的
署名买卖的买家知道自己什么都没做,买的就是署名。被骗的情况主要是劫持期刊:投稿人交了费,论文从没发表。
误解:同行评审能挡住所有工厂稿
课件说同行评审是信任系统,把门的人很少。编辑能被买、审稿人能被供应时,评审就只剩形式。
试一下
一位研究者收到邮件:付费后可以把名字加进一篇「已接收」的论文,排第三作者。这属于哪一样商品?买家得到了什么?
答案
署名买卖。买家没有任何贡献,得到的是一条发表记录,也就是课件说的看起来像科学的资格凭证。
3. 撤稿缺口:被撤的和该撤的
它解决什么问题
前面说「许多坏论文没被撤」。课件给了两个比例,把缺口量化。
从哪来(补充)
课件没给这两个比例的出处。Nature 2023 年 11 月的新闻引了出版伦理委员会 COPE 2022 年的报告:多数期刊的投稿里约 2% 可能来自论文工厂。这是投稿口径的估计,和课件的「符合撤稿标准」不同,不能当成课件数字的出处。来源:How big is science’s fake-paper problem?, Nature。
直觉
两根柱子差别极大:一根是已经被撤的,一根是够格被撤的。
两根柱子之间的空当,课件叫它「我们需要的更正」和「我们发表的更正」之间的距离。
一步一步看
目标:从两个比例算出 20 倍,并看清它为什么是下限。
-
读出两根柱子:已被撤稿 0.1%,符合撤稿标准 2.0%,纵轴是占已发表论文的百分比。
-
相除:2.0 ÷ 0.1 = 20,这就是 20 倍。
-
看标题措辞:课件写的是「超过 2%」。真实比例高于 2% 时,差距就超过 20 倍,所以 20 倍是下限。
-
换成数量感:每 1000 篇已发表论文里,约 1 篇被撤,至少 20 篇够撤稿标准。
怎么算
缺口倍数 = 符合撤稿标准的比例 ÷ 已撤稿的比例。
意思是:每撤掉一篇,还有至少十九篇够格却留在记录里。
常见误解
误解:撤稿率只有 0.1%,说明学术不端很少
0.1% 只是被撤的。课件说够撤稿标准的超过 2%,撤稿率低反映的是更正不足。
误解:20 倍是个精确值
它按柱子上的 2.0 算出,标题写的是超过 2%,所以是下限。课件也没标数据出处,引用时写「课件给出的数字」。
试一下
如果符合撤稿标准的比例是 3%,已撤稿的比例仍是 0.1%,缺口是多少倍?
答案
3 ÷ 0.1 = 30 倍。这也说明,标题写「超过 2%」时,20 倍只能算最低估计。
4. 撤稿数在涨,各国撤稿率不同
它解决什么问题
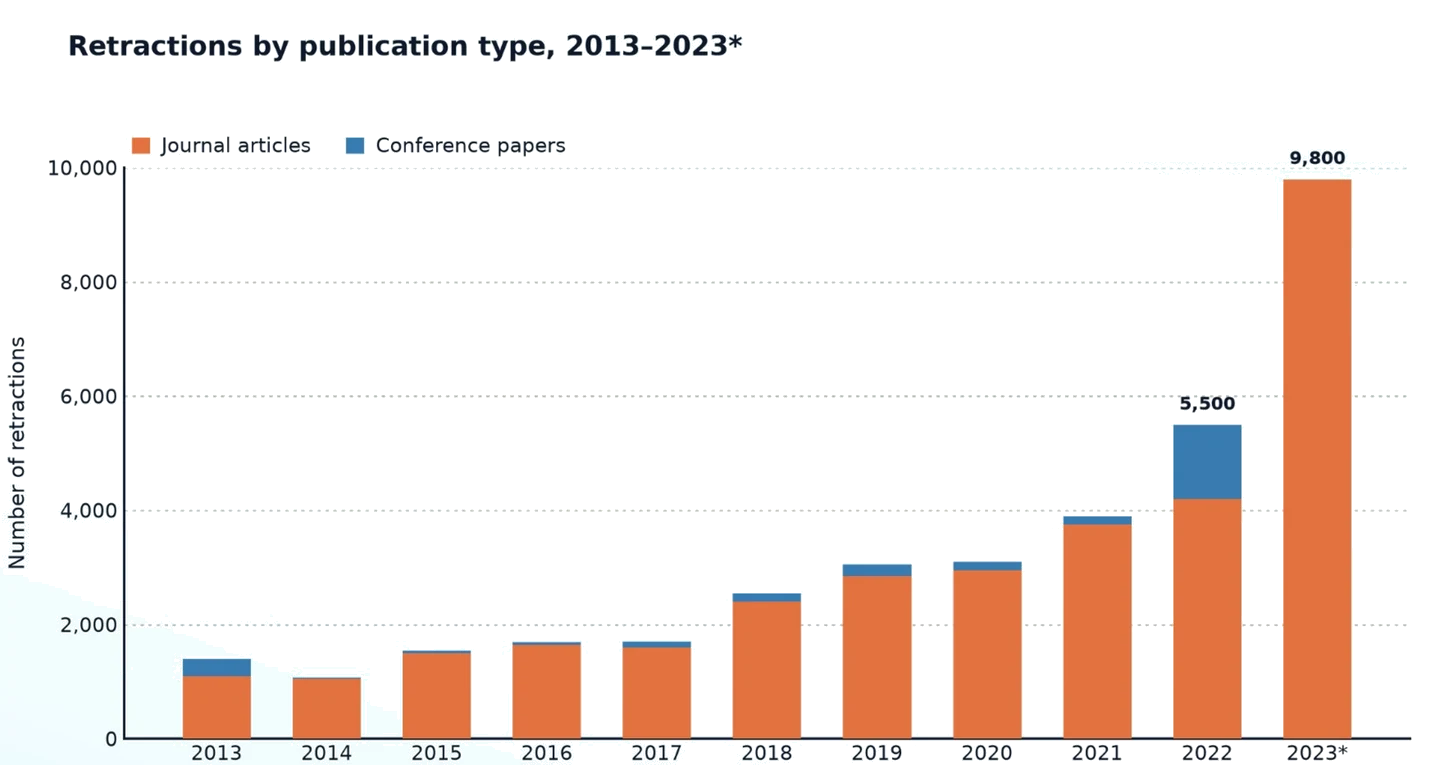
课件用两张整页图说明撤稿在变多,且各国不均。两张图都没印出处。
从哪来(补充)
撤稿增长图:Nature 2023 年 12 月的新闻里有一张结构相同的图(2013–2023*,期刊论文和会议论文两类),星号注明数据截至 2023 年 12 月 8 日,正文说当年撤稿超过 10,000 篇。课件数字与该来源不同:课件 2023* 印的是 9,800,不能断定它是课件图的出处。来源:More than 10,000 research papers were retracted in 2023, Nature。
各国撤稿率图:Nature 后来一篇撤稿率专题用了 Signals 和 Dimensions Author Check 等三家公司的数据,说全球平均约 0.1%;Signals 的论文总数基数更大,算出的撤稿率通常更低,和课件图里蓝点在橙点左边一致。该文印刷版没有这张国家点图,也不能断定它是出处。来源:Exclusive: These universities have the most retracted scientific articles, Nature。
直觉
第一张图看总量:十年里撤稿数一路往上,最后两年跳得最高。
第二张图看比例:九个国家的撤稿率都在全球平均线右边,两家数据源给出的数不一样。
一步一步看
目标:分清两张图上哪些数是印出来的,哪些只能读个大概。
-
看课件的撤稿增长图。图上只印了两个数:2022 年 5,500,2023* 年 9,800。
图片来源:DSAI5T09 LT10.pptx, p.40 -
其余年份只能读个大概:2013 年约 1,400,2018 年约 2,500,2021 年约 3,900。2022 年的会议论文段明显比别的年份厚,约 1,300。
-
再看各国撤稿率图。它没印任何数值,转换后的图还有描边伪影,所以这里用表格列近似读数,不放原图。
国家 Signals(蓝点,约) Dimensions Author Check(橙点,约) Ethiopia 0.46% 0.68% Saudi Arabia 0.38% 0.42% China 0.29% 0.31% Pakistan 0.29% 0.41% Iraq 0.25% 0.47% India 0.17% 0.24% Egypt 0.16% 0.20% Iran 0.14% 0.18% Malaysia 0.13% 0.18% -
横轴是 2014–24 年的撤稿率,从 0 到 0.7%;全球平均线在 0.1% 附近。图上能读出的就是这些:九个国家都在平均线右边,每个国家的橙点都在蓝点右边。
怎么判断
判断口诀:引用图表数字前先问三件事:图上印了吗,出处有吗,两组数据的定义清楚吗。
| 说法 | 能不能这样写 |
|---|---|
| 课件图上 2023* 年撤稿 9,800 | 能,图上印了,注明是课件给出的数字 |
| 2019 年撤稿正好是 3,000 | 不能,只是读图近似 |
| 九个国家都在全球平均线右边 | 能,图上看得出来 |
| 某国研究者更不诚信 | 不能,图只给撤稿率,没给原因 |
常见误解
误解:2023 年的柱子是全年数
课件图上 2023 带星号,但没解释星号的含义。按补充里那篇报道,同类图的星号表示数据截至当年 12 月初,全年数会更高。
误解:两种颜色的点是两年的数据
课件图例写的是两个数据源 Signals 和 Dimensions Author Check。课件没说明二者区别;补充里那篇报道说,两家计算撤稿率时用的论文总数基数不同。
试一下
有人说:「课件图显示 2022 年到 2023 年撤稿数将近翻倍。」这句话哪些部分有根据,哪些要加限定?
答案
增长有根据,图上印了 5,500 和 9,800。要加的限定:2023 带星号且没解释,图也没给出处,应写成「课件图上印的数字」。
5. 机器速度的检测
它解决什么问题
工厂批量产稿,人工审读跟不上,要靠机器筛查。
从哪来(补充)
扭曲短语这个说法来自 Cabanac、Labbé 和 Magazinov 2021 年在 arXiv 发表的论文。他们把它定义为用怪异短语替代既有术语,例子是把 artificial intelligence 写成 counterfeit consciousness。来源:Tortured phrases: A dubious writing style emerging in science, arXiv。
直觉
造假一方和检测一方用的是同一种技术。
能写出一篇像样论文的模型,也能把一万篇读一遍,找出那一段重复的话。
一步一步看
目标:认出四类检测信号,并对上各自抓的造假手法。
-
看下图:左边是造假一方,右边是检测一方的四类信号。
-
图像筛查:找同一张图在不同论文里重复、拼接、复用。
-
文本筛查:看相似度、扭曲短语、模板化的结构。
-
引用图谱:找引用圈、引用卡特尔、异常的自引。
-
统计标记:找不可能出现的分布、好得过头的结果。
怎么判断
判断口诀:先问造假留下了什么痕迹,再选对应的筛查。
| 痕迹 | 用哪类检测 |
|---|---|
| 两篇论文的显微图一样,只是旋转裁剪过 | 图像筛查 |
| 正文把「深度学习」写成怪异的同义词 | 文本筛查 |
| 一小群论文彼此大量互引 | 引用图谱 |
| 每组实验结果都完美落在预期上 | 统计标记 |
常见误解
误解:AI 让造假更容易,所以检测注定落后
课件的结论是同一种技术站在两边:生成稿子的能力,也能用来批量阅读和比对。
误解:查重就能抓住论文工厂
相似度只是文本筛查的一项;引用刷量要靠引用图谱。
试一下
某期刊发现十几篇来自不同作者的论文,结构几乎一样,只是换了研究对象,还频繁互相引用。至少能用哪两类检测抓到?
答案
文本筛查抓模板化结构,引用图谱抓互相引用形成的引用圈。
6. 四方责任和激励链
它解决什么问题
检测只能在出口拦截。课件接着问:谁对这个系统负责,造假的需求从哪里来?
直觉
一个系统的诚信程度取决于最弱的一环。课件说,最弱的一环通常是损失最小的那一方,改革要从杠杆最大的地方下手。
需求的源头在评价方式:只数论文,就会得到论文,假的也算在里面。
一步一步看
目标:把四方各自的责任列清,再找到激励链上杠杆最长的位置。
-
列出四方责任。
谁 负责什么 机构 设定激励,培训研究者,制定数据政策 出版方 守门,规模化筛查,快速更正记录 资助方 握着钱,所以定规则;可以强制要求透明 研究者 决定、披露、核查;最后一道防线是一个亲自核查过的人 -
看激励链的四环:不发表就出局,数量压过质量,论文工厂补上需求,信任被侵蚀。
-
找杠杆:课件认为评价改革的杠杆最长。改变招聘委员会数的东西,喂养工厂的需求就从源头缩小,不需要任何检测算法。
-
换成要数的东西:严谨、开放、肯纠错。
怎么判断
判断口诀:一个措施作用在激励链的哪一环,越靠前,杠杆越长。
| 措施 | 作用在哪一环 |
|---|---|
| 招聘看代表作质量,不数篇数 | 第一、二环:需求源头 |
| 期刊上线图像筛查 | 第三环:拦截工厂产品 |
| 快速撤稿并标注 | 第四环:减少信任损失 |
常见误解
误解:论文工厂是出版方一家的问题
课件标题就是 Everyone owns part of the system:机构、出版方、资助方、研究者各担一部分。
误解:最弱的一环一定是研究者
课件说最弱的一环通常是损失最小的一方,用的是 usually,没有点名哪一方,也不是绝对。
试一下
一所大学把晋升标准改为「提交三篇代表作,由同行评议其严谨性和开放程度」。这项措施作用在激励链哪一环?由四方里的哪一方负责?
答案
作用在第一、二环,改变的是「数量压过质量」的源头。负责的是机构,它负责设定激励。
7. 按回车之前的四个问题
它解决什么问题
课件最后把整讲收成每次用 AI 前问自己的四个问题。
直觉
四个问题一个都不问技术,全都问研究者。
模型会一代代更新,这四个问题不用跟着改,所以原则能撑过每一次模型发布。
一步一步看
目标:按顺序过一遍四个问题,看每一问在什么情况下要收紧。
-
看下图的四张卡。
-
目的:这是思考辅助,还是最终文字?输出一旦进论文,规则就收紧。
-
后果:谁会照着它行动?医生、政策制定者,还是别的研究者?风险越高,核查要求越高。
-
披露:读者看得到吗?工具、版本、提示词、用途写进方法部分。看不到就停下来写清楚。
-
问责:你愿意签名吗?论文上是你的名字,不是模型的。辩护不了,就别投。
怎么判断
判断口诀:四问里任何一问答不上来,就先别按回车。
| 问题 | 要收紧的信号 |
|---|---|
| 目的 | 输出会进论文正文 |
| 后果 | 结论会被医生或政策采用 |
| 披露 | 读者从论文里看不出用过 AI |
| 问责 | 你没法逐句为它辩护 |
常见误解
误解:换了更强的模型,这四个问题就要重写
课件说四个问题都关于研究者,和技术无关,所以原则能撑过每一次模型发布。
误解:只拿 AI 头脑风暴,四个问题就不用管
目的这一问就是要分清:思考辅助较松,输出进了论文就收紧。
试一下
一位研究者用模型起草一篇临床研究的讨论部分,准备直接投稿,方法部分没提用过 AI。四问里哪几问亮红灯?
答案
目的:输出直接进论文,规则收紧。后果:临床研究会有医生照着做,要更严的核查。披露:读者看不到用过 AI。问责:没逐句核查就签名,辩护不了。四问全亮。
把它们串起来
问题的起点是研究记录被污染。论文工厂把造假做成了生意,生成式 AI 给了它产能。
被撤的和该撤的至少差 20 倍;撤稿数在涨,各国撤稿率高低不一,但两张图都没给出处。
应对分三层。机器检测在出口拦截;四方各担一部分责任;评价改革从需求源头下手,杠杆最长。
落到个人,就是按回车前的四个问题:目的、后果、披露、问责。前一页 L10d 讲的披露,正是第三问的具体做法。
课件里的坑
- [数字口径] p.39 标题和正文写 more than 2%,柱子标的是 2.0%,20× 是按 2.0 ÷ 0.1 算的。真实比例超过 2% 时差距就不止 20 倍,20× 是下限。正文那句英文有语病(There are more than 2% meet the criteria…)。
- [无出处] p.39 的 0.1% 和 2%、p.40 和 p.41 两张图,课件都没标数据来源。引用时写「课件给出的数字」,不当作已核实的统计。
- [读图提醒] p.40 的 2023* 星号图上没解释;图上只印了 5,500 和 9,800 两个数,其余年份都是读图近似。
- [读图提醒] p.41 没印任何数值,两组点(Signals、Dimensions Author Check)是什么课件没解释,转换后的图还有描边伪影。本页只用近似读数表。
- [范围词] p.35 用的是 sometimes(有时通过评审)和 many(许多没被撤),p.43 用的是 usually(最弱一环通常是损失最小的一方)。答题时保留这些限定,不要写成绝对。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写论文工厂卖的三样东西和激励链四环;再写出 0.1%、2%、20 倍的关系;最后把四个问题按顺序默写一遍,对照下面检查。
必背
- 研究记录被污染的链条:有缺陷的论文有时能通过同行评审,许多从未被撤稿,被撤的仍在被引用;后果是研究者追错线索、系统综述受损、循证指南被带偏
- 论文工厂是一门生意:按订单写稿、编造数据、保证录用、按篇收费;生成式 AI 补上了缺的厂房,产品是一份看起来像科学的资格凭证
- 论文工厂卖三样东西:署名买卖、引用刷量、编辑通道;劫持期刊仿冒名刊收了费却不发表,被收买的编辑或被供应的审稿人让工厂只需要一把钥匙
- 撤稿缺口:约 0.1% 的已发表论文被撤稿,超过 2% 符合撤稿标准;按 2.0 ÷ 0.1 算出的 20 倍是下限,课件没给数据出处
- 检测用同一种技术:图像筛查、文本筛查、引用图谱、统计标记四类;能生成像样论文的模型,也能读一万篇找出重复的那一段
- 四方各担一部分:机构定激励和数据政策,出版方守门、规模筛查、快速更正,资助方握着钱所以定规则,研究者决定、披露、核查;最弱一环通常是损失最小的一方
- 激励链:不发表就出局 → 数量压过质量 → 论文工厂补上需求 → 信任被侵蚀;杠杆最长的干预是评价改革,改变招聘委员会数的东西
- 按回车前四问:目的、后果、披露、问责;四个问题都问研究者,不问技术,所以这些原则能撑过每一次模型更新
课件例题
例 1(课件 p.39):撤稿缺口
题面:课件给出的三个数字 0.1%、2%、20× 是什么关系?20× 为什么是下限?
提示
先相除,再看标题里的 more than。
解答
约 0.1% 的已发表论文被撤稿,超过 2% 符合撤稿标准。2.0 ÷ 0.1 = 20,课件称之为「我们需要的更正」和「我们发表的更正」之间的距离。标题写超过 2%,所以真实差距不少于 20 倍。
例 2(课件 p.37):论文工厂卖什么
题面:论文工厂实际卖的三样东西是什么?各举一个表现。
提示
署名、引用、编辑。
解答
署名买卖:稿子按订单写,作者位置单独卖,买家可能毫无贡献。引用刷量:同盟论文互相引用,以「曝光度」名义按次计价。编辑通道:能被说动的编辑或能被冒充的期刊,门从里面被打开。
例 3(课件 p.44):激励链
题面:写出激励链四环。课件认为杠杆最长的干预是什么,为什么?
提示
从 Publish or perish 开始。
解答
不发表就出局 → 数量压过质量 → 论文工厂补上需求 → 信任被侵蚀。杠杆最长的是评价改革:改变招聘委员会数的东西,工厂的需求从源头缩小,不需要任何检测算法。要数的是严谨、开放、肯纠错。
完整例题
题目:某大学的晋升标准是「五年内发表二十篇以上论文」。一位讲师收到邮件,说付费即可成为一篇「已接收」论文的第二作者,期刊名和一本知名期刊完全相同,但网址略有差别。按本讲内容分析这件事。
① 认出商品。付费成为作者、没有贡献,是论文工厂的署名买卖。
② 认出门路。期刊名相同、网址不同,可能是劫持期刊:交了费,论文可能哪里都不会发表。
③ 追到需求。晋升只数篇数,对应激励链前两环:不发表就出局,数量压过质量。工厂只是补上了这份需求。
④ 分配责任。机构负责设定激励,出版方负责守门,研究者是最后一道防线,应拒绝并核查期刊真伪。
⑤ 给结论。杠杆最长的是评价改革:机构改掉「数篇数」,这类邮件的市场就会缩小。
变式题(先自己做)
自编情境 1:一位系主任说:「我们领域的撤稿率只有 0.1%,学术不端根本不是问题。」用本讲内容反驳,并指出课件数字本身的局限。
提示
被撤的和该撤的是两回事;再看课件数字有没有出处。
判分点与答案(非官方评分标准)
反驳:0.1% 只是被撤的比例。课件说超过 2% 的论文符合撤稿标准,差距至少 20 倍,撤稿率低反映的是更正不足。
后果:没被撤的坏论文仍在被引用,会让研究者追错线索、污染系统综述和指南。
局限:课件没给 0.1% 和 2% 的出处,20 倍按 2.0 算,是下限;引用时应写成课件给出的数字。
判分点:区分已撤和该撤;算出或说出 20 倍;指出至少一条课件数字的局限。
自编情境 2:一个资助机构想减少它资助的项目里的造假论文,正在考虑两个方案:A 是给合作期刊买一套图像筛查软件;B 是规定结题评审只看三篇代表作,并要求公开数据。按四方责任和激励链比较两个方案。
提示
资助方手里握着什么;两个方案各作用在激励链哪一环。
判分点与答案(非官方评分标准)
方案 A:作用在第三环,拦截工厂产品;守门本是出版方的职责。
方案 B:作用在第一、二环,从源头缩小需求;公开数据用到了资助方可以强制要求透明的权力。
比较:按课件,评价改革杠杆最长,B 更符合;A 可以作为补充。
判分点:两个方案各对上激励链的一环;说出资助方的责任;给出明确取舍并引用「杠杆最长」。
闪卡自测
1. 研究记录被污染的三个后果?
研究者追错线索;系统综述受损;循证指南被带偏(p.35)。
2. 论文工厂的四项服务?
按订单写稿、编造数据、保证录用、按篇开发票(p.36)。
3. 论文工厂卖的三样东西?
署名买卖、引用刷量、编辑通道(p.37)。
4. 劫持期刊怎么运作?
仿冒名刊的名字、封面和网站,收了费,论文哪里都没发表(p.38)。
5. 0.1%、2%、20× 的关系?
0.1% 被撤,超过 2% 够撤稿标准,2.0 ÷ 0.1 = 20,是下限(p.39)。
6. 撤稿增长图上印了哪两个数?
2022 年 5,500,2023* 年 9,800;其余都是读图近似(p.40)。
7. 机器检测的四类?
图像筛查、文本筛查、引用图谱、统计标记(p.42)。
8. 四方各是谁?
机构、出版方、资助方、研究者(p.43)。
9. 激励链四环和杠杆最长的干预?
不发表就出局 → 数量压过质量 → 论文工厂补上需求 → 信任被侵蚀;评价改革(p.44)。
10. 按回车前的四个问题?
目的、后果、披露、问责(p.45)。
下一讲
这是进度表上最后一个内容板块;之后是小组项目展示,没有新的讲义课件。想从头复习这一讲,回到 L10a:生成式 AI 在研究里能帮上什么忙、每一步要怎么核查。回到 课程目录 可以按讲次复习。
下一讲的通俗笔记上完课会补,先回 DSAI5T09 课程页。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。