L08c 类内隐藏偏见、公平的定义和去偏方法:怎样发现和减轻偏见
从零讲清类别数量平衡后为什么还会有偏见、课件的公平公式怎么读、分组评估和交叉评估的区别、对抗多任务训练怎样去掉敏感属性的影响、语言模型类比去偏前后的变化,以及怎样读去偏结果和它的适用边界。
一句话版
类别数量平衡后,每一类里面还可能藏着不平衡;发现它要按子群体、尤其按维度组合去评估,减轻它可以去掉敏感属性的信号,也可以给稀有的样子加分量。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 敏感变量 | sensitive variable,记作 z | 不该影响决定的属性,比如性别、肤色 |
| 真实标签 | y | 这个人实际属于哪一类 |
| 预测 | ŷ,读作 y-hat | 模型给出的答案 |
| 分组评估 | disaggregated evaluation | 按每个维度分别算准确率 |
| 交叉评估 | intersectional evaluation | 按维度组合(如肤色 × 性别)算准确率 |
| 共享表示 | shared representation | 模型中间层对输入的内部编码 |
| 对抗训练 | adversarial training | 让一个部分专门去猜 z,再反着用它的信号 |
| 去偏 | debiasing | 减轻模型对某个属性的依赖或差异 |
一个类比:只按班级平衡的选拔
学校要选合唱队,规定每个班选同样多的人,看上去很公平。
可每个班里,老师习惯挑嗓门亮、站前排的那几个。安静的、坐后排的、口音不一样的,几乎从不被选上。
按班级一数,人数完全平衡;按「班级 × 坐的位置」一数,后排学生几乎为零。
要发现这件事,得把两个维度交叉起来数。要改,可以让老师听歌时看不到座位,也可以专门多给后排学生试唱的机会。
类比在哪里失效:
- 老师能被提醒「别看座位」;模型就算不给它敏感属性,也可能从别的特征里间接认出来。
- 合唱队名单能一眼看完;模型的子群体可以有很多维度,组合起来非常多。
- 多给后排试唱,靠的是老师的意识;模型里的「多给机会」靠加权或重采样这样的数学手段。
从零讲起
1. 类别内部藏着的偏见
它解决什么问题
上一页把类别之间的数量调平了:人脸和非人脸一样多。很多人以为问题解决了。
课件接着说:每一类内部藏着的偏见,可能更危险。
直觉
一个人脸检测模型要分「是人脸」和「不是人脸」。两类数量平衡了。
可「人脸」这一类里面,黑发、棕发、金发、红发各有多少张?如果某种发色很少,模型在这种发色的人脸上就差。
这种差距在「人脸 vs 非人脸」的总准确率里看不出来,因为它藏在一类的内部。
一步一步看
目标:读课件发色案例的两张图,看「金标准」数据集和现实的差别怎样变成准确率的差别。
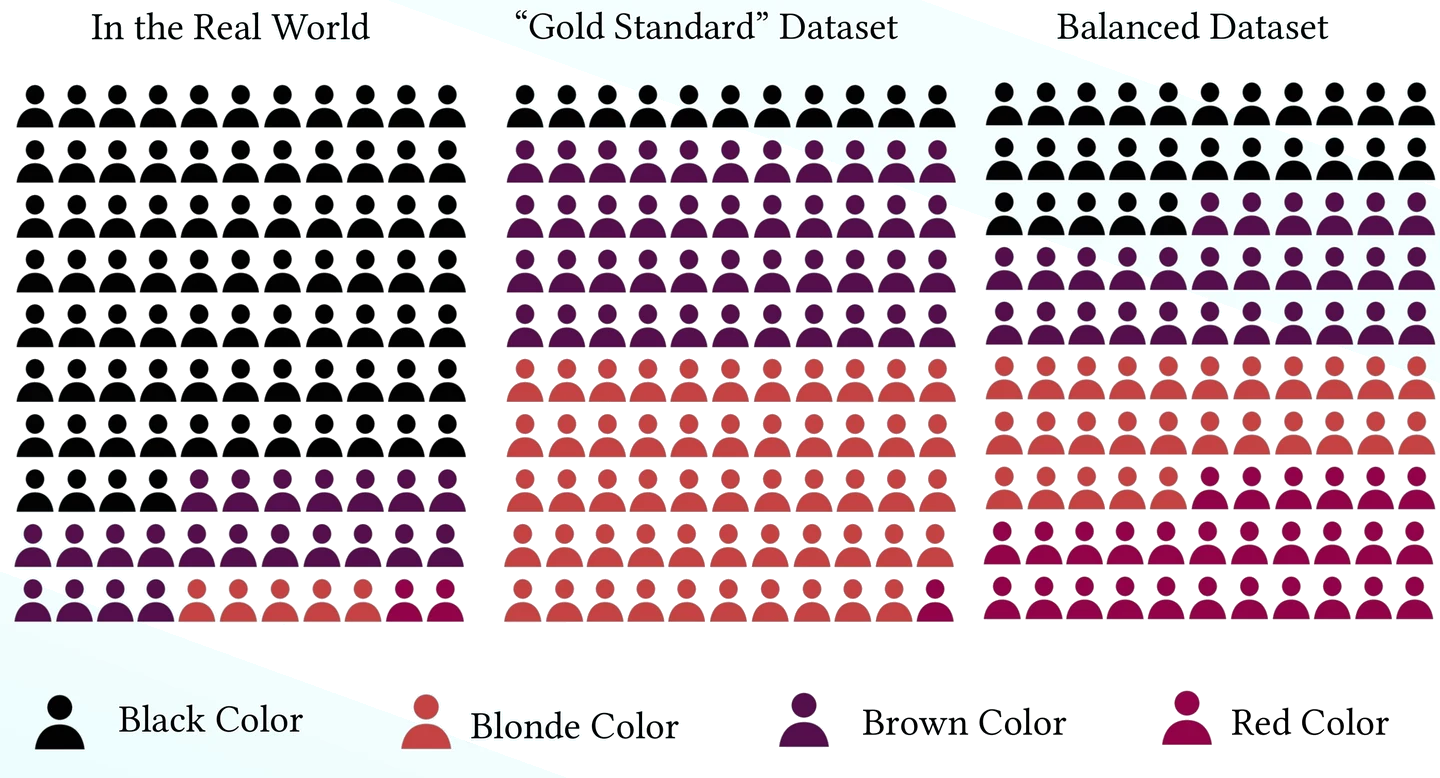
-
数课件的图标格子(每组 110 个,按图数出,只是示意)。
发色 现实世界 「金标准」数据集 平衡数据集 黑发 81 11 27 棕发 22 44 28 金发 5 54 27 红发 2 1 28 -
看「金标准」数据集上训练出的人脸检测准确率。
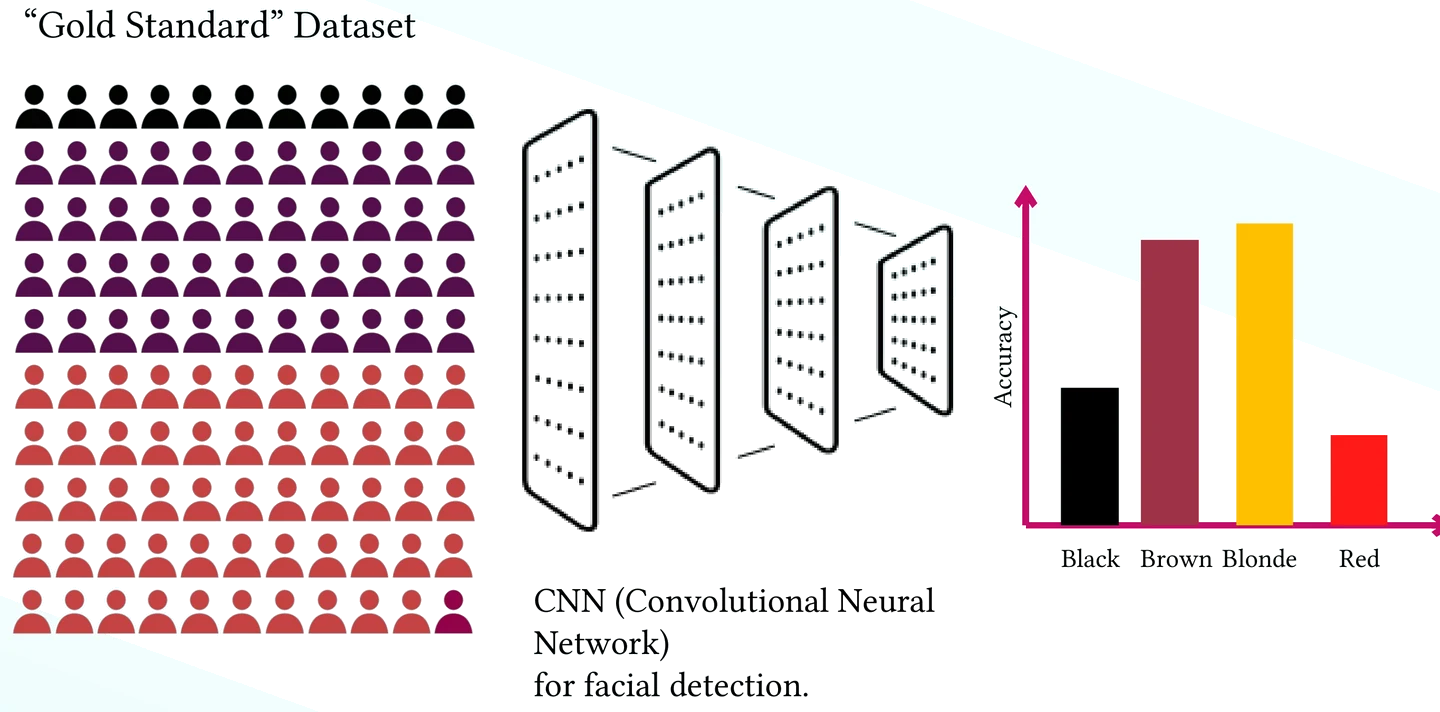
图片来源:DSAI5T09 LT8.pptx, p.38 -
对照两张图。
发色 数据集里 准确率(读图) 金发、棕发 多 高 黑发 远少于现实 偏低 红发 只有 1 个 最低
怎么判断
判断口诀:类别平衡之后,再往每一类里面拆一层。
| 检查 | 能发现什么 |
|---|---|
| 各类别的总数 | 类别之间是否平衡 |
| 每一类内部的属性分布 | 类内是否藏着不平衡 |
| 按属性分组的准确率 | 不平衡有没有变成表现差距 |
意思是:「金标准」只说明标注质量好,不说明代表性好。
常见误解
误解:叫「金标准」的数据集就没有偏见
课件特意给「金标准」打了引号:标得准不等于覆盖全,里面黑发远少于现实,红发只有一个。
误解:类内不平衡没有类间不平衡严重
课件的原话正相反:类内藏着的偏见可能更危险,因为总准确率根本看不出来。
试一下
课件的「平衡数据集」里四种发色各约四分之一。这和现实世界的比例不同,为什么还要这样做?
答案
目的是让模型在每种发色上都学得一样好,不是复制现实比例。照现实比例,红发只有极少几个,模型学不会。
2. 公平怎么定义:一个公式和两种评估
它解决什么问题
说一个模型「不公平」,得有能检查的标准。课件给了一个公式,又给了两种把人分组去检查的办法。
从哪来(补充)
课件的公式叫 equality of opportunity,由 Hardt、Price、Srebro 2016 年提出,等价于各组的真正例率相等。出处:arXiv 1610.02413。
只把敏感属性从输入里拿掉不够:别的特征可能和它高度相关,间接把它带回来。出处:Wikipedia: Fairness (machine learning)。
直觉
课件的公式:P(ŷ=1 | z=0, y=1) = P(ŷ=1 | z=1, y=1)。竖线右边是条件,意思是「先只看这些人」。
公式读法:在真实答案是「是」(y = 1)的人里,不管敏感属性 z 是 0 还是 1,模型答「是」的概率要一样。
换句话说:同样够格的人,不因为属于哪一组而更容易被漏掉。
课件还给了另一个说法:如果模型在多知道一个敏感信息后改变了决定,它就是有偏的;f(x) 和 f(x, z) 一样时,才对 z 公平。
找出不公平要拆组。拆法有两种:
一步一步看
目标:用一个贷款模型的数字,逐步套课件的公式,判断它公不公平。
-
先圈定该看的人。
-
算各组被判为正类的比例。
-
比较两组,下结论。
怎么判断
判断口诀:先固定真实答案,再比各组被判对的比例。
| 评估方式 | 怎么分组 | 会漏掉什么 |
|---|---|---|
| 只看整体 | 不分组 | 所有子群体差距 |
| 分组评估 | 每个维度单独分 | 维度组合出来的子群体 |
| 交叉评估 | 维度两两或多个组合 | 漏得最少,但组多、每组样本少 |
意思是:公式给出检查标准,交叉评估决定拿哪些组去比。
常见误解
误解:模型输入里没有性别,就一定对性别公平
别的特征(比如姓名、购物记录)可能和性别高度相关,模型照样能间接用上。要用公式检查结果。
误解:分组评估都正常,交叉评估也会正常
人脸分类表就是反例:单看肤色或性别也能看出差距,但最差的 79.2% 只有交叉成「深肤色 × 女性」才完整露出来。
试一下
一个模型在「真的有病」的人里,男性被查出 80%,女性被查出 80%。按课件公式,它对性别公平吗?
答案
按这个公式是公平的:真实为正的人里,两组被判为正的比例相等。但这只检查了这一条,其他指标(比如误报)仍要另外看。
3. 去偏方法:对抗多任务训练
它解决什么问题
发现偏见后要动手减轻。课件把思路分成两条路:去掉有问题的信号,或者为想要的特征加信号、重新加权。
对抗多任务训练走的是第一条路:让模型的内部表示里认不出敏感属性。
从哪来(补充)
课件语言模型的例子出自 Zhang、Lemoine、Mitchell 2018 年的论文 Mitigating Unwanted Biases with Adversarial Learning,表中 doctor 的去偏结果和课件一致。出处:arXiv 1801.07593。
把梯度取负传回共享层的做法叫梯度反转层,出自 Ganin 和 Lempitsky 的领域自适应论文。出处:arXiv 1409.7495。
直觉
模型分两个头:任务头预测要做的事 y,属性头专门去猜敏感属性 z。
属性头越猜越准,说明共享表示里还留着 z 的信息。
于是把属性头的梯度取负传回共享表示:属性头想往「猜得更准」走,共享表示就被推向「让它猜不准」。最后表示里认不出 z,任务头只能靠别的信息做决定。
一步一步看
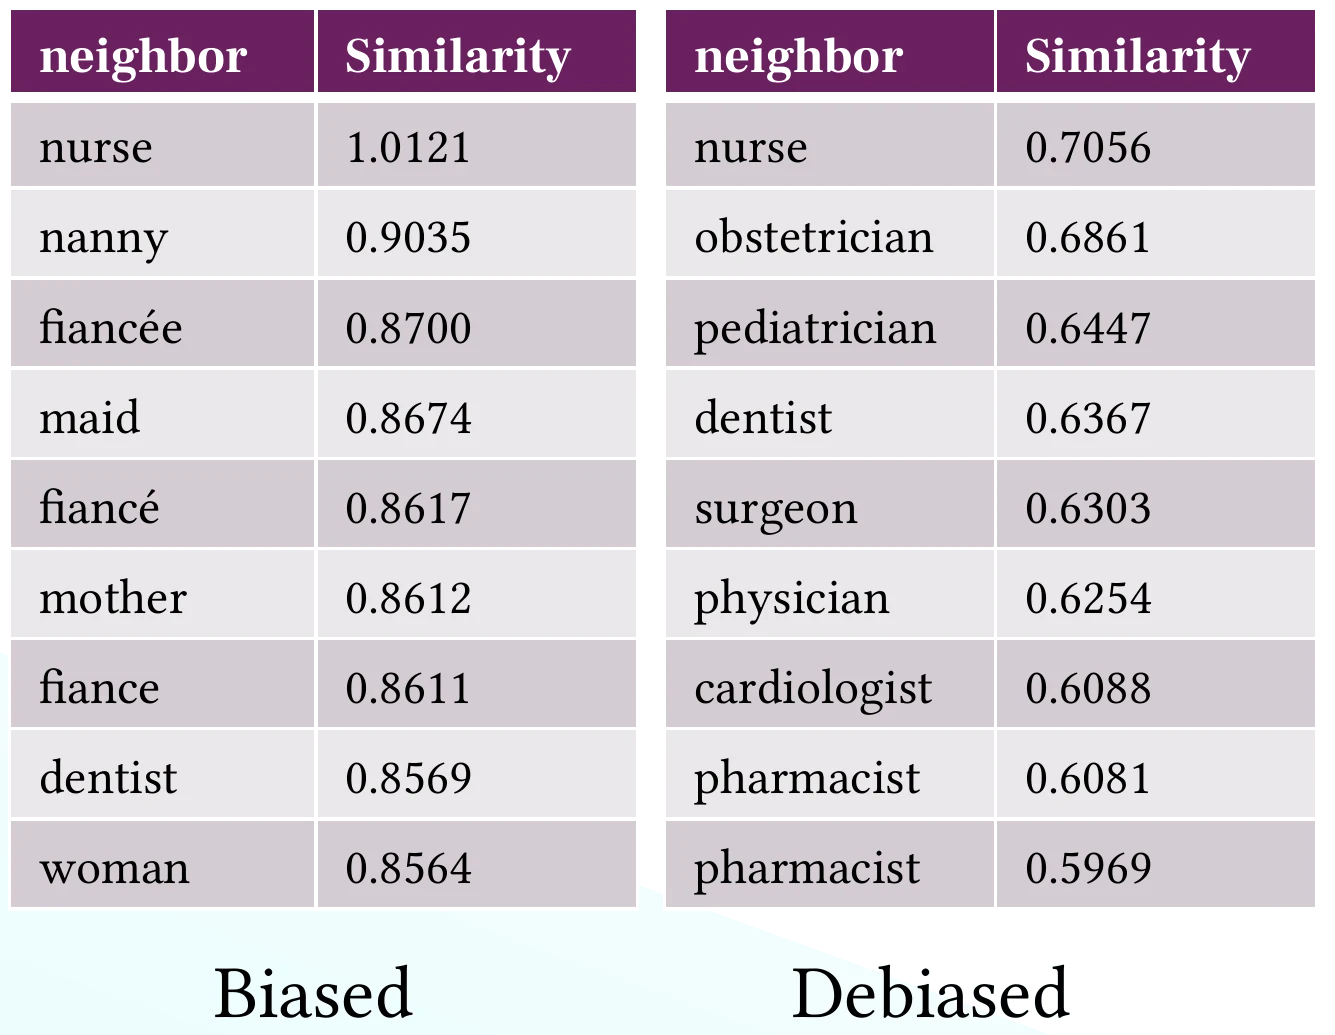
目标:读课件语言模型类比的去偏前后两列,一步步看 doctor 的「女性版」怎样变了。
-
读去偏前的前几名。
排名 词 相似度 1 nurse 1.0121 2 nanny 0.9035 3 fiancée 0.8700 4 maid 0.8674 -
读去偏后的前几名。
排名 词 相似度 1 nurse 0.7056 2 obstetrician 0.6861 3 pediatrician 0.6447 4 dentist 0.6367 -
对比:去偏前多是保姆、女仆、未婚妻这类性别化的词;去偏后多是医疗职业。nurse 仍排第一,但相似度明显下降。
怎么判断
判断口诀:对抗训练看属性头:它猜不出 z,表示里就少了 z。
| 方法 | 走哪条路 | 做法 |
|---|---|---|
| 对抗多任务 | 去掉有问题的信号 | 属性头梯度取负,让表示认不出 z |
| 加权、重采样 | 加入信号、重新加权 | 让少见的样子分量更大 |
意思是:两条路可以一起用,一条减掉不该有的,一条补上该有的。
常见误解
误解:属性头的目的是把 z 预测准
属性头自己确实在学着猜 z,但取负的梯度让共享表示朝相反方向走;整个设计的目标是让 z 猜不出来。
误解:去偏后 nurse 消失才算成功
nurse 本来就是医疗职业,仍排第一不奇怪。变化在于性别化的非职业词被医疗职业取代,相似度也降了。
试一下
如果训练完属性头还能把 z 猜得很准,说明什么?
答案
说明共享表示里仍保留着 z 的信息,去偏没有做到位,任务头的决定仍可能受 z 影响。
4. 读去偏结果:学习潜在结构再重采样
它解决什么问题
前面的加权要先知道谁是少数,比如要先标出发色、肤色。可敏感属性很多,一一人工标注很费时。
课件最后的结果来自一种不用人工标注的做法:让模型自己学出数据的潜在结构,再给稀有的样子更多训练机会。
从哪来(补充)
这项结果出自 Amini、Soleimany 等 2019 年的 DB-VAE 论文。模型学出人脸的潜在结构,给潜在空间里稀有的样本更高的重采样概率;训练用了约 400,000 张图片,在一个按肤色和性别标注的人脸基准上评估。论文把偏见量化为各组准确率的方差,各组一样准时方差为 0。出处:论文 PDF。
直觉
模型先把每张脸压成几个潜在变量,比如肤色深浅、有没有头发、脸朝哪边。
在这些变量上数一数:哪些样子很常见,哪些很稀有。稀有的样子,训练时多抽几次。
这就是上一页重采样的思路,只是「谁稀有」交给模型自己学。
一步一步看
目标:按课件的结果描述,逐步读出去偏力度加大后各组怎样变化,再说出结论的边界。
-
不去偏时。
子群体 准确率 深肤色男性 最低 浅肤色男性 最高 -
去偏力度加大后。
指标 变化 整体准确率 上升 深肤色男性、深肤色女性 提升 深肤色男性和浅肤色男性的差距 明显缩小 -
结论的适用边界。
限制 意思 只在一个人脸检测基准上测 换数据未必一样 用的是该基准自带的类别 别的分组方式没测 假设潜在变量相互独立 现实中变量常常相关
怎么判断
判断口诀:读去偏结果三看:最差组升没升、差距缩没缩、在哪测的。
| 结果描述 | 能下的结论 |
|---|---|
| 整体升、最差组也升、差距缩小 | 这个基准上去偏有效 |
| 只有整体升 | 还不能说更公平 |
| 只在一个基准上测 | 不能宣称对所有场景有效 |
意思是:去偏结果也要按子群体读,还要守住它的测试范围。
常见误解
误解:去偏一定会牺牲整体准确率
课件这项结果里整体准确率反而上升,因为模型在原来学得差的样子上学好了。
误解:这个方法证明了对所有人脸系统都有效
课件自己写了边界:一个基准、基准自带的类别、独立性假设。超出这个范围要另外验证。
试一下
去偏后整体准确率上升,但浅肤色男性的准确率基本不变。这是好事还是坏事?
答案
是好事:最差的组被提上来,最好的组没被拉下去,差距因此缩小。
把它们串起来
类别之间平衡了,偏见还可能藏在每一类里面:「金标准」人脸数据集里黑发远少于现实,红发只有一个,准确率就跟着差。
要发现它,先有一个能检查的标准:同样够格的人,不因为属于哪一组而更容易被漏掉。再按子群体去比,最好把维度交叉起来,最差的往往藏在组合里。
要减轻它,一条路是去掉有问题的信号,比如对抗训练让表示里认不出敏感属性;另一条路是加入信号、重新加权,比如让模型学出哪些样子稀有,再多给它们训练机会。
读去偏结果时,看最差组有没有提上来、差距有没有缩小,也要记住它在哪个基准上测过。
课件里的坑
- [课件错误] p.44 去偏后一列 pharmacist 出现两次;来源论文(Zhang 等 2018)这张表最后一行是 hospital 0.5969
- [概念混写] p.41 把两种定义放在一页:公式是 equality of opportunity(各组真正例率相等);「f(x) = f(x, z) 才公平」来自另一篇论文,那里的 z 指模型学出的潜在特征。只做到输入里不放 z 并不够,别的特征可能是 z 的代理
- [画法提醒] p.43 的「共享表示 + 属性头梯度取负」是梯度反转层的画法;来源论文用的是单独的对抗网络,结构不完全一样。答题按课件的结构写
- [读图提醒] p.37 的人形图标格子是示意,数出来的数字(如红发 1 个)只说明相对多少,不是真实数据量
- [重复页] p.39 重复了 p.9 的表和图,只是换了一个问题
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写公平公式和每个符号的意思、两条去偏路线、对抗多任务的结构;再对照课件 p.36–45 做课件例题和变式题;最后回查一个易错点:属性头的梯度是取负后传回,目标是让 z 猜不出来。
必背
- 每一类内部藏着的偏见可能更危险:人脸和非人脸平衡了,人脸里的发色、肤色仍可能不平衡
- 公平公式 P(ŷ=1|z=0,y=1) = P(ŷ=1|z=1,y=1):真实答案为正的人里,各组被判为正的概率相等
- 分组评估逐个维度看,交叉评估看维度组合;最差的往往是组合出来的子群体
- 去偏两条路:去掉有问题的信号(mitigation),为想要的特征加信号或重新加权(inclusion)
- 对抗多任务:共享表示接两个头,属性头预测 z,把它的梯度取负传回,让表示里认不出 z
- 去偏后整体准确率上升、深肤色子集提升、深浅肤色男性的差距缩小;结论只在一个基准上验证过
课件例题
例 1(课件 p.36–38):发色案例
题面:「金标准」人脸数据集里各发色的数量和现实不同,训练出的人脸检测模型在黑发和红发上准确率低。解释原因,并说出课件给的改法。
提示
人脸和非人脸已经平衡了,问题藏在哪一层?
解答
偏见藏在「人脸」这一类内部:数据集里黑发远少于现实,红发只有一个,模型在这些发色上学得少,准确率就低。课件的改法是用发色平衡的数据集,让四种发色各约四分之一。
例 2(课件 p.39–40):两条去偏路线
题面:课件问学习流程怎样发现和减轻偏见,并给出 Bias Mitigation 和 Inclusion 两条路。分别说明。
提示
一条做减法,一条做加法。
解答
Bias Mitigation:去掉有问题的信号。Inclusion:为想要的特征加入信号,对信号重新加权。
例 3(课件 p.41):读公平公式
题面:解释 P(ŷ=1|z=0,y=1) = P(ŷ=1|z=1,y=1) 里每个符号,并用一句话说出它要求什么。
提示
竖线后面是条件:先固定了什么?
解答
ŷ 是预测,y 是真实标签,z 是敏感变量。要求:在真实标签为正的人里,z = 0 和 z = 1 两组被预测为正的概率相等,也就是同样够格的人不因所属组别而更容易被漏掉。
例 4(课件 p.42):两种评估
题面:说明分组评估和交叉评估的区别,并用人脸分类表说明为什么需要交叉评估。
提示
最差的那一组是单一维度还是组合?
解答
分组评估按颜色、按形状分别看;交叉评估看颜色 × 形状的组合。人脸分类表里最差的是「深肤色 × 女性」这个组合,只按肤色或只按性别看也能看出差距,但最差的 79.2% 只有交叉后才完整露出来。
例 5(课件 p.43):对抗多任务
题面:画出或描述课件的对抗多任务结构,说明 z 头的梯度怎样处理、为什么。
提示
两个头接在哪?回传时符号怎样变?
解答
输入 x 进共享表示(embedding + 隐藏层),接两个头:任务头预测 y,属性头预测 z。属性头的梯度取负后传回共享表示,使表示朝「猜不出 z」的方向更新,从而去掉 z 对决定的影响。
例 6(课件 p.44):语言模型类比
题面:对比 He : She = doctor : ? 去偏前后的结果,说明变化。
提示
看前几名是什么类型的词,再看相似度。
解答
去偏前前几名是 nurse、nanny、fiancée、maid 这类性别化的词;去偏后多是 obstetrician、pediatrician、dentist、surgeon 等医疗职业。nurse 仍排第一,相似度从 1.0121 降到 0.7056。另外课件去偏列 pharmacist 重复了,原论文最后一行是 hospital。
例 7(课件 p.45):读去偏结果
题面:说出去偏力度加大后各组准确率的变化,以及课件写的结论边界。
提示
整体、深肤色两组、深浅肤色男性的差距;边界有三条。
解答
不去偏时深肤色男性最低、浅肤色男性最高。去偏力度加大:整体准确率上升,深肤色男性和女性都提升,深浅肤色男性的差距明显缩小。边界:只在一个人脸检测基准上测,用的是基准自带的类别,并假设潜在变量相互独立。
完整例题
题目:一个简历筛选模型的输入里已经去掉了性别。审计发现,在后来证明能胜任的候选人里,男性 200 人中 160 人进了面试,女性 100 人中 60 人进了面试。团队说:「我们根本没用性别,不可能有偏见。」请按本页内容分析并给出改法。
① 套公式。只看能胜任(y = 1)的人。男性 160 ÷ 200 = 0.8,女性 60 ÷ 100 = 0.6,两组不相等,不满足课件的公平公式。
② 为什么没用性别也会偏。简历里的社团、用词、毕业院校等特征可能和性别相关,模型间接用上了性别。输入里不放 z 不等于决定不受 z 影响。
③ 怎样查得更细。做交叉评估,比如性别 × 专业、性别 × 年龄段,找出最差的组合。
④ 改法一:去掉信号。加一个属性头预测性别,梯度取负传回共享表示,让表示里认不出性别。
⑤ 改法二:加入信号。对女性中稀有的简历样子加权或重采样。改完按组重新算比例,确认差距缩小,并说明只在这批数据上验证过。
变式题(先自己做)
自编情境:一个医院的分诊模型按「是否需要紧急处理」分类。真正需要紧急处理的病人里,65 岁以上 300 人中有 240 人被判为紧急,65 岁以下 500 人中有 450 人被判为紧急。按性别单独看,差距不大。请用本页的方法分析,并设计一个去偏方案。
提示
先算两组的比例;「单独看都不大」提醒你还该怎么拆;去偏方案可以从两条路里选。
判分点与答案(非官方评分标准)
公式:240 ÷ 300 = 0.8,450 ÷ 500 = 0.9,两组不等,65 岁以上的紧急病人更容易被漏判,不满足公平公式。
交叉评估:按年龄 × 性别等组合再算,最差的可能是某个组合,单看一个维度看不全。
去偏方案:对抗多任务,属性头预测年龄组,梯度取负传回;或对 65 岁以上紧急病例加权、重采样。
验证:改完按组和组合重算比例,看最差组是否提升、差距是否缩小,并说明验证范围。
判分点:两个比例算对;提到交叉评估;方案对应两条路之一并写出验证方法。
闪卡自测
1. 类内偏见为什么更危险?
它藏在一类内部,类别之间的总准确率看不出来(p.36)。
2. 「金标准」数据集里哪种发色只有一个?
红发(p.37)。
3. 去偏的两条路?
去掉有问题的信号;加入信号、重新加权(p.40)。
4. 公平公式里 z 是什么?
敏感变量(p.41)。
5. 交叉评估看什么?
维度的组合,比如颜色 × 形状(p.42)。
6. 对抗多任务里 z 头的梯度怎么处理?
取负后传回共享表示(p.43)。
7. 去偏前 doctor 的「女性版」第一名和相似度?
nurse,1.0121(p.44)。
8. 不去偏时准确率最低和最高的组?
深肤色男性最低,浅肤色男性最高(p.45)。
下一讲
下一讲 L09a Algorithmic Fairness:从偏见从哪来、怎样减轻,转到公平怎样定义和度量。回到 课程目录 可以按讲次复习。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。