L02b-3 不制造 WMD 的 AI 流程:可解释性四类受众与反事实审计
从零讲清 AI 四阶段流程各防哪一个坑、上线后要守住哪四件事,SHAP、PDP、ICE 各自看的是谁,以及怎样用生成式 AI 造反事实图像,审计皮肤癌分类器到底在看病灶还是在看毛发。
一句话版
模型上线后要有人盯着,没把握时能交还给人,还要让不同的人都看懂它在依赖什么。
前两页回答了「谁来负责」。这一页回答「具体怎么做」:一套不制造 WMD 的流程,四类人各要什么样的解释,以及怎样用反事实图像查出一个皮肤癌模型其实在看毛发。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 谦逊 AI | Humble AI | 遇到没把握的输入时,模型主动交还给人 |
| 漂移检测 | Drift Detection | 盯着输入数据的分布有没有偏离训练时 |
| 挑战者模型 | Challenger Models | 候补模型持续和现役模型比,候补赢了就说明假设失效 |
| SHAP | 读作「沙普」 | 算一次预测里每个特征贡献了多少 |
| 显著图 | saliency map | 高亮图像里模型最关注的像素 |
| 反事实 | counterfactual | 只改一个因素,看结果会不会翻转 |
| 伪相关 | spurious correlation | 模型抓住了碰巧同时出现、但没有因果的特征 |
一个类比:只看最后一张照片的阅卷老师
设想一位老师批改「辨认鸟种」的作业。学生交上来的每张照片里,喜鹊都站在电线上,乌鸦都站在树枝上。一个学生全对,老师很满意。
老师想知道他到底会不会认鸟,于是拿一张喜鹊站在树枝上的照片去问。学生答「乌鸦」。他认的一直是背景,鸟本身没看。
这就是这一页最后要审计的东西。老师做的那一步叫反事实:只换掉一个因素,看答案翻不翻。只看「全对」这个准确率,永远发现不了问题。
类比在哪里失效:
- 老师自己就知道喜鹊长什么样;医学影像里,「模型应该看什么」要靠医生和文献来定,审计必须有外部标准对账。
- 老师换一张照片很容易;给医学影像造反事实要专门训练一个生成模型,每个分类器配一个,还要多位专家看图,成本很高。
从零讲起
1. 四阶段流程与上线后四件事
它解决什么问题
前面讲了很多模型怎样出事。这个概念把防御落成一条工程流程:从收集数据到长期监控,每个阶段都对着前面讲过的某个坑。
直觉
课件给出的四个阶段是:收集并准备数据、构建并验证多种模型、部署并接入业务、长期监控。
几个要素要和前面对着看。阶段 2 要求「多种」建模方法,防的是所有机构用同一套假设。阶段 4 的漂移检测防历史近视,挑战者模型持续挑战现役假设,2008 年缺的正是有人去挑战「房价不会全国下跌」。阶段 3 的护栏叫 Humble AI:模型没把握时退让给人工或安全的默认规则,不硬给一个分数。
交付之后还有四件事:保持参与、跟踪漂移、回退流程、整体性指标。保持参与那句原话是 Don’t throw models “over the wall”。
一步一步看
目标:拿 2008 年的风险模型逐个阶段对照,看每一步当时能拦住什么。
拿 2008 年的风险模型做对照,逐个阶段问「如果当时有这一步,会拦住什么」。
-
阶段 2,多种模型:如果各家用不同的建模方法,就不会所有人同时信同一个假设,HOMOGENEOUS LOGIC 被打破一角。
阶段 要素 2008 年缺的 2 多种建模方法 全行业同一套假设 -
阶段 3,Humble AI:遇到训练数据里没见过的行情,模型应该说「这一例我不知道」,交给人判断。
阶段 要素 2008 年缺的 2 多种建模方法 全行业同一套假设 3 Humble AI 没见过的行情照样打分 -
阶段 4,漂移检测:房价开始下跌,输入分布偏离训练时,系统应当报警。
-
阶段 4,挑战者模型:一个假设「房价可能全国下跌」的候补模型开始赢,就说明现役模型的假设失效了。
阶段 要素 2008 年缺的 4 Drift Detection 没人发现行情变了 4 Challenger Models 没人挑战核心假设 -
上线后的整体性指标:只看准确率,测的仍是作者定义的成功。要测受影响者真正的目标,得跟踪公众情绪、安全调查这类模型之外的东西。
怎么判断
评价一个 AI 项目的流程,按四个问题过一遍:
- 有没有建不止一种模型,保留意见分歧?
- 模型没把握时,有没有交还给人的出口?
- 上线后有没有人盯漂移、有没有挑战者模型?
- 验收只看准确率,还是也看了模型之外的影响?
每一条答「没有」,就对应前面讲过的一个坑。
常见误解
以为建多个模型是为了挑最准的那个
它的用处是保留意见分歧,让同质化的假设有人挑战。挑战者模型同理,它存在的意义是在现役模型失效时先赢。
以为准确率达标就能验收
只看准确率,测的仍然是作者定义的成功。要测受影响者真正的目标,得引入模型指标之外的东西。回退流程也一样重要:它在模型开始自我强化时切断链条。
试一下
一个学校评分模型上线后,没人跟进,也没有人工复核渠道,学校只看「预测和期末成绩的吻合度」。按四个问题找缺口。
没有交还给人的出口(缺 Humble AI 和回退流程),上线后没人盯(缺保持参与和漂移检测),验收只看吻合度这一种准确率(缺整体性指标)。上一页的「低潜力」回路正好能在这些缺口里转起来。
2. 四类受众与 SHAP、PDP、ICE
它解决什么问题
「模型要可解释」这句话太笼统。同一个模型,被拒的申请人、一线信贷员、管理层、合作方要的解释完全不同。这个概念先分清受众,再给每类受众配工具。
从哪来(补充)
SHAP 的名字来自 Shapley 值,是 Lloyd Shapley 1951 年在合作博弈论里提出的分配方法。2017 年 Lundberg 和 Lee 在 NIPS 上把它用到机器学习的单次预测解释上,提出了 SHAP。PDP 由 Friedman 在 2001 年的梯度提升论文里提出;ICE 由 Goldstein 等人在 2013 年提出,用来补 PDP 把个体差异平均掉的问题。出处:Shapley 值词条、SHAP 论文、PDP 讲解、ICE 论文。
直觉
四类受众各有一个关键词:
| 受众 | 关键词 | 解释要做到 |
|---|---|---|
| 被影响的个人 | FAIRNESS | 可行动:我该做什么才能通过 |
| 战术决策者(如信贷员) | CONFIDENCE | 可核对:这个分数合不合理 |
| 战略决策者(管理层) | STRATEGY | 可聚合:整体上有没有系统性偏见 |
| 合作方 | ACCOUNTABILITY | 可问责:出事谁负责 |
工具跟着受众选。SHAP 解释一次预测,服务被影响的个人。PDP 看整个数据集的平均,ICE 给每个个体各画一条线,两者服务战略决策者。
PDP 是 ICE 的平均。某个特征对一半人是正作用、对另一半人是负作用时,PDP 会画出一条近乎水平的线。
一步一步看
目标:用四位申请人的自编数字先画 ICE 再求平均,看 PDP 怎样把相反的影响抵消成一条平线。
用一组自编的数字看 PDP 怎样把差异平均掉。设模型里有一个特征 x,四位申请人在 x 从 0 变到 1 时,预测分数的变化如下。
-
先给每个人画一条 ICE 线,记下 x = 0 和 x = 1 时的分数。
申请人 x = 0 x = 1 变化 甲 4 8 +4 乙 5 9 +4 丙 8 4 −4 丁 9 5 −4 -
求 x = 0 时的平均:(4 + 5 + 8 + 9) ÷ 4 = 6.5。
-
求 x = 1 时的平均:(8 + 9 + 4 + 5) ÷ 4 = 6.5。
-
画 PDP:两个端点都是 6.5,是一条水平线,看起来 x 对预测没有影响。
-
回到 ICE:甲乙随 x 上升、丙丁随 x 下降,影响很大,只是方向相反、互相抵消。所以 PDP 平的时候,一定要回头看 ICE。
怎么判断
设计可解释方案时,按两步走:
- 先问这份解释给谁看,对着四类受众表找关键词。
- 再选工具:给个人看一次决定为什么这样,用 SHAP;给管理层看整体依赖,用 PDP,并配 ICE 检查有没有被平均掉的差异。
看到 PDP 是平的,下结论前先看 ICE 有没有两簇方向相反的线。
常见误解
看到 PDP 是平的就说这个特征没影响
「没影响」和「影响相互抵消」在 PDP 上长得一样,要看 ICE 才分得开。
以为给个人一个分数和每个特征的贡献就算解释了
对个人来说,解释要可行动:将来怎么改善自己的处境。只告诉他分数和贡献,他仍然不知道该改什么。这正是下一个概念里反事实方法要补的。
试一下
一家银行想向董事会说明「年龄」这个特征在贷款模型里起什么作用,分析师只交了一张 PDP,线几乎是平的,结论写「年龄不影响审批」。这份汇报缺什么?
受众是战略决策者,工具选 PDP 没错,但只交 PDP 不够。要配 ICE 检查年龄是否对某些人提分、对另一些人降分、互相抵消。若是这样,「不影响审批」的结论就错了,而且可能藏着针对某个年龄段的系统性偏见。
3. 从显著图到反事实审计
它解决什么问题
在医学影像上,通用的解释工具说不清模型在看什么临床特征。这个概念给出一条替代路线:让生成式 AI 把差异画出来,再让医生命名差异,最后和文献对账,判断模型可不可信。
直觉
显著图在医疗场景不够用。它告诉你模型在看哪一块像素,医生想知道的是模型在看色素网络还是在看毛发。解释必须落在使用者的概念里才算解释。
课件的替代路线借自人脸识别:用生成式 AI 改一个特征,看模型判断变不变。在皮肤病变上,生成模型把参考图改得更「良性」或更「恶性」,专家对比成对图像,说出差在哪里。
这里的「更恶性」意思是「让分类器 f 更倾向判恶性」。所以这套方法测的是模型认为什么重要,它和医学上什么重要之间的差距,正是要审计出来的东西。
一步一步看
目标:跟一张皮肤病变参考图走完审计,看专家怎样从成对改图里分出模型看的是病变还是背景。
跟着一张参考图走一遍审计流程。
-
把一张皮肤病变参考图送进分类器 f,f 给出恶性或非皮肤癌的判断。
-
为这个分类器训练一个生成模型,把参考图改成两个版本:一个让 f 更倾向判良性,一个让 f 更倾向判恶性。
步骤 输出 生成 一对只在关键处不同的图 -
请皮肤科专家对比这一对图,说出差在哪:颜色变深了?出现了毛发?背景变红了?
-
把专家说出的差异归类:属于病变本身(Lesion)还是属于背景(Background)。
专家看到的差异 归类 色素更深 Lesion 出现毛发 Background -
在大量图像、多个数据集、多位专家、多个分类器上重复,汇总成热力矩阵,再和文献公认的临床特征那一列对账。
怎么判断
读审计结果时,问三句:
- 这个模型的色块集中在 Lesion 行还是 Background 行?
- Lesion 行的方向和 Literature 列一致吗?
- Background 行有没有显眼的色块?有,就是伪相关。
集中在 Lesion 行、方向和文献一致,模型用的是恰当的特征。Background 行显眼,模型在用和病情无关的东西判断,换到别的医院就会失效。
常见误解
以为「更恶性」是医学上更恶性
方向由分类器的预测定义。这套方法测的是模型认为什么重要,它和医学上什么重要之间的差距正是要审计出来的东西。
以为显著图高亮了病灶区域,模型就是在看病灶
显著图只指出位置,说不出模型在那块区域里用的是色素网络、颜色数量还是别的什么。要知道用的是哪个临床特征,得靠反事实加专家命名。
试一下
审计发现某模型的反事实图里,「更恶性」的版本总是背景更红、病变本身几乎没变。按三句判断下结论。
色块会落在 Background 行(红斑一类),Lesion 行变化很小,和 Literature 列对不上。模型在用背景颜色判断皮肤癌,这是伪相关。它在原测试集上可能准确率很高,换一种拍摄条件就会失效。
把它们串起来
前两页回答「谁来负责」,这一页回答「具体怎么做」。
先是流程:四个阶段各自防一个前面讲过的坑,Humble AI 把「别把算法当成不会犯错的东西」变成了技术动作。上线后还有四件事,最关键的是准确率不够。
然后是解释。同一个模型要给四类人四种解释,工具跟着受众选。到了医学影像,像素级的解释落不到医生的语言里,于是改用反事实:让模型自己把差异画出来,再让人去命名。
最后的审计图把全讲收住。模型学到的东西和我们以为它学到的东西可能不一样,这一节第一次让这个差距能被看见。
课件里的坑
- [补充] p.37 的流程图在幻灯片文字里顺序是乱的,四个阶段各自的四个要素要按阶段归位读:阶段 3 才有 Guardrails / Humble AI,阶段 4 才有 Drift Detection 和 Challenger Models
- [补充] p.44 右侧的乘号表示整套流程要在大量图像、多个数据集、多位专家、多个分类器上重复。课件没提成本,评价这个方法时,可扩展性差、依赖专家人力是最实在的局限
- [补充] p.45 的热力矩阵里,色块颜色表示特征主要出现在哪一类反事实里:红是恶性、蓝是良性、灰是不明显;色块大小表示出现比例。ISIC 和 Fitzpatrick17k 两个数据集的 Background 行不一样,读图时分开看
- [补充] 本页 PDP 与 ICE 那组四位申请人的分数是自编演示,p.40 没有给数字
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条:四类受众各要什么、SHAP/PDP/ICE 各看谁、审计图的 Lesion 行和 Background 行各代表什么。再做下面的「变式题」。最后回查两个最容易错的地方:看到 PDP 平就说没影响、把反事实的「更恶性」读成医学真相。
Online Quiz 偏向有唯一答案的点:三种工具的粒度、四类受众的关键词、Humble AI 的定义。Written Assignment 可能让你为某个系统设计可解释方案,那时要先分清受众,再选工具。
必背
- AI 四阶段流程的防御含义:阶段 2 建多种模型防同质化,阶段 4 的 Drift Detection 防历史近视、Challenger Models 持续挑战现役假设;Humble AI 让模型主动承认「这一例我不知道」
- 上线后四件事:保持参与(别把模型扔过墙)、跟踪漂移、回退流程、整体性指标——准确率不够
- 可解释性对四类受众意味着不同的东西:个人要可行动、战术决策者要可核对、战略决策者要可聚合、合作方要可问责
- SHAP 解释单次预测、PDP 看全局平均、ICE 逐个体画线;PDP 会把方向相反的效应平均掉,「无影响」和「相互抵消」在 PDP 上长得一样
- 显著图在医疗场景的局限:像素级高亮不落在临床概念上,医生需要知道模型用了哪些临床特征
- 反事实方法只改一个因素看结果是否翻转;方向由模型的预测定义,不是由医学真相定义
- 审计的落点是 Lesion 行还是 Background 行:模型靠毛发、红斑、背景色判断皮肤癌,学的就是伪相关,换到真实场景就会失效
课件例题
例 1(课件 p.42):改「是否微笑」,看人脸识别模型受不受影响
题面:研究者用生成式 AI 修改一张人脸照片里的单个特征,比如这个人是否在微笑,然后观察人脸识别模型还能不能认出这张图。这个做法叫什么?它回答的问题和 SHAP 有什么不同?
提示
注意「只改一个特征、其余不变」这个动作。再想想 SHAP 给出的是什么:每个特征的贡献大小,还是改什么才会翻转?
解答
这就是反事实:只改一个因素,其余保持不变,看结果变不变。SHAP 回答「哪些特征贡献大」,反事实回答「改什么,结果才会翻转」。对被影响的个人来说,后者才是可行动的解释。
例 2(课件 p.43–45):用生成式 AI 反事实图像审计皮肤癌分类器
见下方完整例题。
完整例题
课件 p.43–45 原题:一张皮肤活检的病变参考图送进分类器 f,f 输出恶性或非皮肤癌。为每个分类器训练一个生成模型,把参考图改得在该分类器看来更良性或更恶性,生成成对的反事实图像,交给多位皮肤科专家辨认差异。审计结果画成热力矩阵:列是 DeepDerm、ModelDerm、Scanoma、SSCD、SIIM-ISIC 五个模型,最右一列是 Literature;行分成 Lesion(色素更深、颜色数量、非典型色素网络等)和 Background(偏粉、褐斑、毛发、红斑等)。红色块表示该特征主要出现在恶性反事实里,蓝色块表示主要出现在良性反事实里。问:怎样读这张图判断一个模型是否可信?如果某个模型在 Hair 行有显眼的红色块,说明什么?
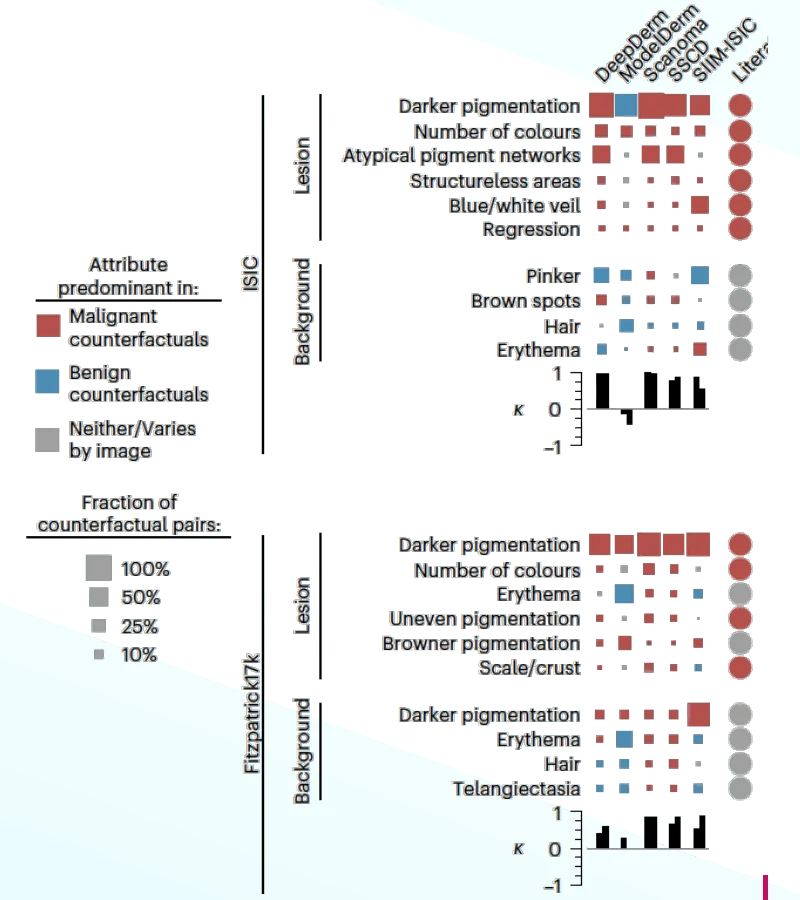
① 先说方法在测什么:生成的方向由分类器 f 的预测定义。所以这张图展示的是每个模型认为什么让病变「更像癌」,它不是医学真相。
② 拿 Literature 列对账:Literature 列是文献公认的临床特征,是整张图的校准锚。一个可信的模型,色块应该集中在 Lesion 那几行,并且和 Literature 列的方向一致。
③ 读 Background 行:如果某个模型在 Hair 行有显眼的红色块,意思是生成模型为了让它更倾向判恶性,往图里加了毛发。这个模型在用毛发判断癌症。毛发和恶性之间没有因果关系,这是伪相关。
④ 后果:这类模型在原测试集上可能准确率很高,换一家医院、换一种拍摄条件就会失效,而且预测往往带偏。显著图只会告诉你模型在看某块区域,说不出它在看毛发。
⑤ 结论:这套审计能判断模型用的是恰当还是不恰当的特征,是独立审计在技术层面真正落地的样子:有一个外部标准可以对账。局限是成本高,每个分类器要配一个生成模型,还要多位专家人工看图。
答题格式:先一句说方向由 f 定义,再写对账方法(Lesion 行 + Literature 列),然后解释 Hair 行红块的含义和后果,最后一句评价方法与局限。
变式题(先自己做)
自编情境:一家医院用深度学习模型从胸部 X 光片判断是否有肺炎,测试准确率很高。后来发现,病情重的病人多数在床边用便携机拍片,片子角落会印上便携机的标记。
(1) 这个模型可能学到了什么?用本页的哪个概念命名它?(2) 要查清楚,用显著图够不够?课件的哪套方法更合适?(3) 对被诊断的病人和对医院管理层,解释分别该给什么?
提示
想想「便携机标记」属于病灶本身还是背景。第三问回到四类受众那张表。
参考答案与自检(非官方评分标准)
自检要点:① 给出伪相关并说明为什么会失效;② 说清显著图的不足;③ 两类受众的解释要不同。
(1) 模型可能在用角落的便携机标记判断病情,这和肺炎本身没有因果关系,是伪相关。换一家把所有病人都在放射科拍片的医院,它就会失效。
(2) 显著图可能高亮角落,但说不出模型在看「标记」还是在看那里的什么组织结构,单靠它不够。更合适的是反事实:把标记去掉或加上,看判断是否翻转;再请放射科医生对照成对图像命名差异,并和文献公认的肺炎影像特征对账。
(3) 对病人,解释要可行动、可理解,例如这次判断依据的是哪些肺部表现,以及可以申请人工复核。对管理层,解释要可聚合:整体上模型有没有依赖背景特征、在不同拍片条件下表现差多少。
闪卡自测
1. 什么是 Humble AI?它对应本讲哪句核心论断?
模型遇到自己没把握的输入时主动退让,交给人工或安全的默认规则。它对应「危险在于我们把算法当成不会犯错的东西来信任」,让模型自己承认这一例不知道(p.37)。
2. 上线后四件事里,哪一条直接回应错配表?
整体性指标那一条:准确率不够。只用准确率验收,测的仍是作者定义的成功(p.38)。
3. 四类受众各自的关键词是什么?
被影响的个人 FAIRNESS,战术决策者 CONFIDENCE,战略决策者 STRATEGY,合作方 ACCOUNTABILITY(p.39)。
4. PDP 和 ICE 是什么关系?PDP 的陷阱在哪?
PDP 是 ICE 的平均。某个特征对一半人是正作用、对另一半人是负作用时,PDP 会画出接近水平的线,「没有影响」和「影响相互抵消」在 PDP 上长得一样,ICE 能把两簇曲线分开(p.40)。
5. 显著图在医疗场景缺什么?
它指出像素位置,说不出模型用的是哪个临床特征,而医生要靠临床特征判断结果能不能接受(p.41)。
6. 审计热力图最右的 Literature 列起什么作用?
它是校准锚:把模型实际依赖的特征和文献公认的临床特征逐行比对(p.45)。
下一讲
下一讲把镜头从系统拉回到个人:在没人看着的时候,一个数据从业者具体该怎么处理数据。L03a
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。