L08a-2 VR 换届与恢复:主节点没了,从过半的日志里拼回账本
VR 的另外两个子协议:先弄懂 k 是「多数副本都已完成的最新操作号」,再一帧一帧跑一遍 view change,最后看崩溃的机器怎样补课、以副本身份回来。
一句话版
VR 的主节点崩溃后,剩下的副本换一个视图、选一台新主节点。新主节点从过半的副本那里收日志,拼出所有已经提交的操作,再接着往下排号。崩溃的机器修好后,先找过半的人把日志补齐,然后只当普通副本。
正常操作的四条消息、2f+1 和多数集交集,见上一页 L08a。这一页讲 VR 剩下的两个子协议:view change 和副本恢复。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 视图 / 视图号 v | view | 一任主节点的任期,换主节点时 v 加一 |
| 视图切换 | view change | 主节点失联后选新主节点、开新视图的子协议 |
| 日志 l | log | 一台副本按顺序记下的全部操作 |
| k | 课件记法 | 多数副本都已完成的最新操作号 |
| 副本恢复 | recovery | 崩溃的机器修好后补齐日志、重新加入 |
| 超时 | timeout | 等了太久没回音,就当对方出事了 |
一个类比:值班经理断线以后
四家分行轮值,本周一分行当值班经理。某天一分行突然断线,客户的转账请求石沉大海,其他分行也联系不上它。
剩下的分行按事先排好的顺序,请二分行接任。三、四分行把各自的账本交给二分行。二分行凑齐过半的账本后,挑出那些「过半分行都已经记下」的流水,作为确定无误的旧账,然后宣布:从现在起我是值班经理,新流水号接着旧账往下编。
一分行修好回来,发现值班经理已经换了。它先找过半的分行把这段时间的账抄回来,然后老老实实当一个普通分行。
类比在哪里失效:
- 分行能打电话问一分行是不是真倒了。协议里的副本只能靠超时去猜,主节点也许只是网慢,协议得保证猜错了也不出错。
- 类比里「事先排好顺序」一笔带过。课件没有展开新主节点具体怎样确定,只说换到下一个视图、由新主节点接手。
从零讲起
1. k:多数副本都已完成的最新操作号
它解决什么问题
换届时,各副本的日志长短不一。有的记到了 op 10,有的只到 op 8。新主节点要知道:哪些操作是一定已经定下、必须保留的?
k 就是这条分界线。k 以内的操作,已经在过半的副本上落了地,按上一页的交集论证,它们可能已经回复过客户端,必须保留。
直觉
一条操作算「已提交」,前提是过半的机器记下了它。那么从各家日志里找一个号码,使得「过半的副本都至少做到这里」。这个号码越往后越好,但不能超过过半的那条线。
一步一步看
目标:看三家副本日志长短不一时,怎样找出过半都做到的那个操作号 k。
课件的例子:主节点 Branch-I 崩溃后,三家副本的日志如下。
-
Branch-II 做到 op 9。
-
Branch-III 做到 op 10。
-
Branch-IV 做到 op 8。
-
从后往前试。至少做到 op 10 的只有 Branch-III 一家,不够过半。
-
至少做到 op 9 的有 Branch-II、Branch-III 两家,3 家里的 2 家,构成多数。所以 k = op 9。
怎么算
把各副本做到的操作号从大到小排好,取第「过半人数」个。
这里三个号是 10、9、8,过半是 2,从大到小数到第 2 个,是 9。
意思是:排在第「过半人数」位的那个号,正好是「有过半的副本至少做到这里」的最大值。比它大的号,做到的人数不够过半。
常见误解
以为 k 取最长那份日志的号
最长的日志里,最后几条可能只有它一家记了,还没过半,不能算已提交。k 要的是过半都做到的那一条。
以为 k 取最短那份日志的号
取最短的太保守,会把已经过半的操作丢掉。op 9 已经在两家落地,取 op 8 就漏了它。
试一下
5 台副本分别做到 op 6、op 9、op 7、op 9、op 5。过半是几?k 是多少?
5 台的过半是 3。从大到小排:9、9、7、6、5,第 3 个是 7,所以 k = op 7。做到 op 7 的有三家(9、9、7),够过半;做到 op 9 的只有两家,不够。
2. 视图切换(view change)
它解决什么问题
主节点崩溃了,没人排号,系统停住。view change 要做两件事:选出新主节点,并且保证旧主节点已经回复过客户端的操作一条都不丢。
直觉
旧主节点每条回复过的操作,都已经落在过半的副本上。新主节点只要也凑齐过半的日志,两组过半必有交集,那条操作至少出现在一份交上来的日志里。
所以 view change 的核心动作就是「收过半的日志」。
一步一步看
目标:看新主节点怎样靠收齐过半的日志上任,让旧主节点回复过的操作一条不丢。
四家分行,Branch-I 是旧主节点,Branch-II 接任。每一帧里近黑的是这一步的消息,灰色的是前面走完的步骤。
-
Branch-I 崩溃。客户端长时间收不到回复,或副本联系不上主节点,换届开始。
-
副本把 ⟨doviewchange v, l, k, i⟩ 发给新主节点 Branch-II。v 是新视图号,l 是自己的日志,k 是自己知道的已提交位置,i 是自己的编号。
-
Branch-II 连自己在内收齐过半的 doviewchange,把视图号从 1 改成 2,从这些日志里拼出完整的已提交操作,发 ⟨startview v, l, k⟩ 给所有副本。
-
各副本执行还没执行的已提交操作。新主节点回复客户端,开始接受新请求,操作号接着旧日志往下排。
怎么判断
新主节点在第 3 步问自己:收到的 doviewchange,连自己在内,够不够过半?
意思是:够了才能宣布新视图,因为只有过半的日志才一定和旧主节点的每一组确认重叠;不够就继续等,宁可停着也不带着残缺的日志上任。
2f+1 台时,过半就是 f+1。坏的是主节点,剩下 2f 台,还够凑 f+1 份。
常见误解
原主节点修好后会重新当主节点
它崩溃期间系统已经换了视图,新主节点在岗,它回来只能当副本。
以为换届时旧主节点手里没确认完的操作也会被保留
不一定。只有过半记下、已经提交的操作才保证保留。没凑够过半的操作,旧主节点也没回复过客户端成功,丢了不违反任何承诺,客户端会重试。
试一下
3 台机器跑 VR,主节点崩溃。剩下 2 台能完成 view change 吗?再坏一台呢?
3 = 2 × 1 + 1,f = 1,过半是 2。剩下 2 台正好够,能完成。再坏一台只剩 1 台,凑不到 2 份 doviewchange,换届完成不了,系统停住但不会出错。
3. 副本恢复(recovery)
它解决什么问题
一台机器崩溃后修好了,它的日志停在崩溃那一刻,这期间别人可能已经提交了新操作,甚至换了主节点。它要先补齐,才能重新参与投票。
直觉
它自己的记忆已经不可信,那就去问别人。问过半的人,过半里一定包含所有已提交操作的见证者。
一步一步看
目标:看崩溃后修好的 Branch-I 怎样向别人补齐日志,以普通副本身份回归。
-
Branch-I 修好,向所有节点发 dorecoveryrequest(v, i),i 是自己的编号。
-
各节点回 dorecoveryresponse(v, l, k),带上视图号、日志和 k。
-
Branch-I 收到 f+1 个响应,按其中的日志同步自己的状态。
-
这时系统已经是 Branch-II 当主节点的新视图,Branch-I 以普通副本身份回归。
怎么判断
恢复中的节点问自己:响应够 f+1 个了吗?
意思是:够了,这些响应里一定有人见证过每条已提交操作,按它们同步就不会漏;不够,就继续等,在补齐之前不参与投票。
常见误解
以为恢复的节点用自己硬盘上的旧日志直接回来就行
旧日志缺了它崩溃期间提交的操作,直接回来会让它按过时的状态回应,可能把别人带偏。必须先从过半的节点那里补齐。
试一下
5 台机器跑 VR,一台副本崩溃后修好。它最少要收到几个 dorecoveryresponse?
5 = 2 × 2 + 1,f = 2,要 f+1 = 3 个。
把它们串起来
正常操作靠「过半确认才回复」把每条已提交操作放到了过半的机器上。这一页的两个子协议,都是在用这个事实。
view change 让新主节点收过半的日志,两组过半必有交集,已提交的操作一条都漏不掉。k 标出了「过半都做到」的那条线,线以内的必须保留。
副本恢复反过来,让回来的机器去问过半的人。三个子协议用的是同一个门槛。
代价也一样:凑不够过半,系统就停住。停住不会出错,只是暂时不可用。
课件里的坑
- [读图提醒] p.13 旁注写「Branch-III lacks op 10」,同页列表写 Branch-III 到了 op 10,两处矛盾;k = op 9 的结论不受影响(p.13)。
- [页码说明] 课堂批注版比原版多 3 页,分别插在原版 p.19、p.29、p.42 之后。本页写「批注版 p.N」的按批注版计,其余页码按原版。
- [读图提醒] p.15 的换届图画了四家分行,对话框写「After f+1 responses」。四个节点凑不成 2f+1,课件没交代这里 f 取几。图里两个副本都发了 doviewchange,连新主节点自己是 3 个节点,已超过半数。以下是推断:如果按 f = 1 数成 f+1 = 2 份并把新主节点自己算进去,四个节点里的 2 个不是多数;节点数不是 2f+1 时,按「超过半数」去数更稳妥。同一问题在 p.17 Exercise 1 的四节点图里也出现(p.15、p.17、p.19)。
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,默写 doviewchange、startview、dorecoveryrequest、dorecoveryresponse 四条消息的字段;再把 k 的算法用自己的话讲一遍;然后按时间线画完整例题,最后做变式题。
必背
- VR view change:doviewchange(v,l,k,i) 收 f+1 后换视图,startview(v,l,k);恢复节点收 f+1 个响应后以副本身份回归
- k 是多数副本都已完成的最新操作号:三家分别到 op 9、op 10、op 8 时 k = op 9
- 触发 view change:客户端长时间收不到回复,或副本联系不上主节点
- 换届后操作号接着旧日志往下排;新主节点从 f+1 份日志里拼回所有已提交操作
- 备份 PREPAREOK 少于 f 个时操作不提交,主节点不能回复成功;客户端在换届后重试
课件例题
例 1(课件 p.13):新主节点的 k
Branch-II 到 op 9,Branch-III 到 op 10,Branch-IV 到 op 8。新主节点的 k 取几?
提示
数一数至少做到每个号的有几家。
解答
k 是多数副本都完成的最新操作号。至少到 op 9 的有两家,构成多数,所以 k = op 9。
例 2(课件 p.18,Example 1):主节点崩溃前后的两次写入
见下方完整例题。
例 3(课堂批注版 p.20):只有一个备份回应时,主节点能不能回复成功
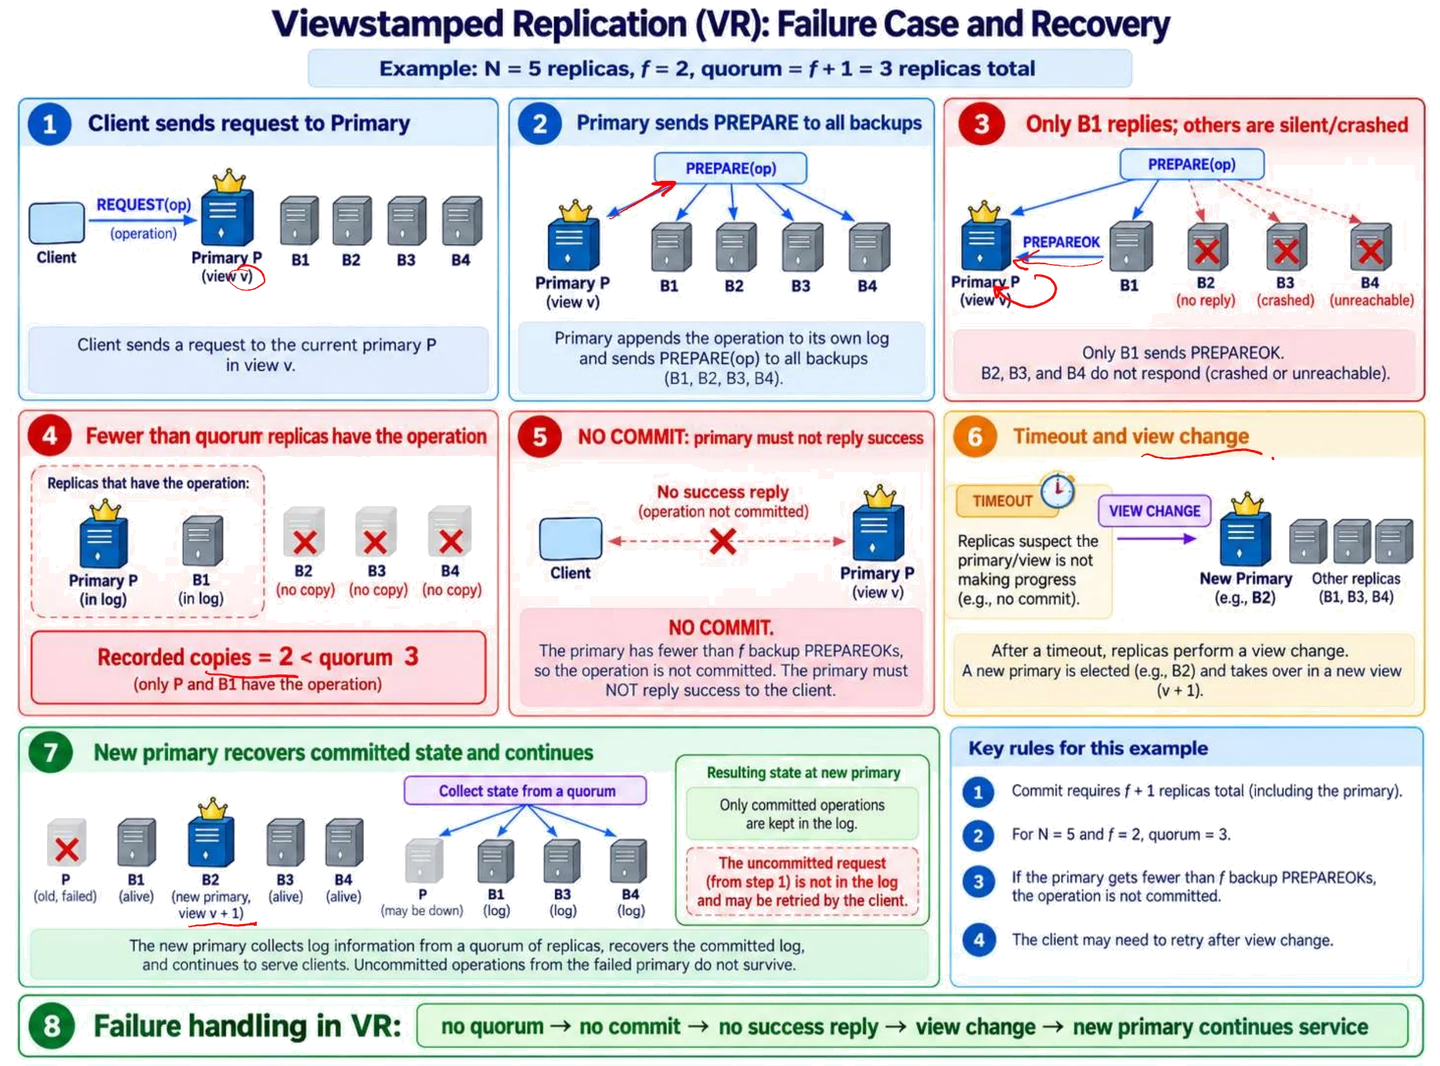
5 个副本(f 为 2,法定人数 3),主节点 P 在视图 v 收到请求,给 B1–B4 发 PREPARE。只有 B1 回 PREPAREOK,B2 没回、B3 崩溃、B4 不可达。P 该怎么做?之后系统怎样继续?
提示
先数有几份副本记下了这个操作,再和法定人数比。
解答
记下操作的只有 P 和 B1 两份,少于法定人数 3。主节点拿到的备份 PREPAREOK 少于 f 个,操作不算提交,P 不能回复客户端成功。副本等不到进展就超时,发起 view change,选出新主节点(图中是 B2,视图 v+1)。B2 从多数副本收集日志,只保留已提交的操作;这条未提交的请求不在日志里,客户端换届后重试。整条链是:凑不够法定人数 → 不提交 → 不回复成功 → 换届 → 新主节点接着服务。
例 4(课件 p.39–40):三台服务器用 VR 写入 set x=1
A、B、C 三台服务器,A 是主节点。写出 set x=1 的正常流程,以及 A 失效后系统怎样继续。
提示
前半段是正常操作四步,后半段是 view change。
解答
主节点 A 收到请求,给 B、C 发 prepare(set x=1, view=1);B、C 回 ack(view=1);A 拿到过半确认后提交,并通知 B、C 提交。A 失效时,B、C 发现后发起 view change,选出新主节点(比如 B),B 接着处理请求。
完整例题
题面:三个副本 R1、R2、R3,R1 是主节点。客户端先发「Set X = 5」,再发「Set X = 6」,但第二条请求到达前 R1 崩溃。按时间线写出四步:正常操作、主节点失效、视图切换、新操作。(课件 p.18,Example 1)
约定:3 台机器,f = 1,过半是 2;课件这页把 prepareok 简写成 ack,把通知副本执行写成 commit。
解法:
- 正常操作。R1 收到请求,分配序号 1,向 R2、R3 发 prepare(1, X=5);R2、R3 回 ack(1);R1 拿到过半确认后发 commit(1) 并回复客户端。
- 主节点失效。R1 崩溃,客户端把「Set X = 6」发给 R1,收不到回应。
- R2、R3 超时后开始视图切换,新视图是 View 2,主节点是 R2。
- 视图切换。R2 从 R3(和自己)收集状态,2 份 = 过半,确认所有已提交的操作都在,然后以主节点身份恢复处理请求。
- 新操作。R2 收到「Set X = 6」,分配序号 2,向 R3 发 prepare(2, X=6);R3 回 ack(2)。
- R2 加 R3 已是 3 个里的 2 个,构成多数,R2 发 commit(2) 并回复客户端。
要点:换届之后序号接着往下排,新主节点靠过半的状态保证 X = 5 没丢(p.15、p.18)。
答题格式:按四个阶段分段写,每段写清谁发什么消息、凑了几份、为什么够。
变式题(先自己做)
(1) 5 个节点跑 VR,主节点是 R1,R4、R5 都已崩溃。如果 R1 此时也崩溃,剩下的节点能完成 view change 吗?(改编自课件 p.17)
提示
先算 5 个节点的过半是几,再数崩溃后还剩几台。
判分点与答案(非官方评分标准)
5 = 2 × 2 + 1,f = 2,过半是 3。R1 再崩溃就只剩 R2、R3 两台,凑不到 3 份 doviewchange,view change 完成不了,系统停住。停住不会出错,只是不可用。
(2) 3 台副本换届时,新主节点收到的两份日志分别做到 op 4 和 op 6。k 是多少?op 5、op 6 一定会被保留吗?(自编情境)
提示
3 台的过半是 2,看两份日志都做到哪里。
判分点与答案(非官方评分标准)
两份都做到的最新号是 op 4,k = op 4。op 5、op 6 只在一份日志上,不保证已提交,旧主节点也不会因为它们回复过客户端成功,不保证保留。
(3) 5 台机器跑 VR,主节点发出 prepare 后只收到 1 个 prepareok 就崩溃了。客户端会看到什么?这条操作一定会出现在新视图里吗?(改编自课堂批注版 p.20)
提示
f = 2 时要几份记录才算提交?
判分点与答案(非官方评分标准)
主节点加 1 个副本是 2 份,5 台的过半是 3,不够,操作没提交,主节点也没回复成功。客户端收不到回应,换届后重试。新主节点只保证保留已提交的操作,这条不在保证范围内。
闪卡自测
1. 什么情况会触发 VR 的 view change?
客户端长时间收不到回复,或副本联系不上主节点(p.15)。
2. doviewchange 带了哪些字段?
v、l、k、i:新视图号、自己的日志、已提交位置、自己的编号(p.15)。
3. 三家副本分别到 op 9、op 10、op 8,k 取几?
op 9:至少到 op 9 的有两家,构成多数(p.13)。
4. 新主节点收齐 doviewchange 后发什么?
startview(v, l, k),所有副本执行还没执行的已提交操作(p.15)。
5. 崩溃的副本修好后怎样重新加入?
发 dorecoveryrequest,等 f+1 个 dorecoveryresponse,同步日志后以普通副本身份回归(p.16)。
6. 5 个副本里只有 1 个备份回了 PREPAREOK,主节点能回复客户端成功吗?
不能。连主节点在内只有 2 份记录,少于法定人数 3,操作不提交;超时后换届,客户端要重试(批注版 p.20)。
7. 换届后新操作的序号从几开始?
接着旧日志往下排,Example 1 里 X = 5 是序号 1,换届后 X = 6 是序号 2(p.18)。
下一讲
下一页是 L08b Paxos 两阶段:同样靠过半交集,但没有固定主节点,谁都可以提议。带着问题读:没有主节点排号,怎样保证已经选定的值不会被后来的提议换掉?
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。