T03b Tutorial 3 下半:把注意力装成 Transformer 层,拼出图像分类器
Tutorial 3 后两个填空和主程序:TransformerEncoderLayer 的残差与 LayerNorm,图片怎么变成 28 个元素的序列,位置编码与 max pooling,174,218 个参数怎么数,以及照注释换成官方层时的 batch_first 陷阱。
一句话版
上半场写好了多头注意力,这一页把它装进 Transformer 层,再拼成完整的分类器:把一张 28 × 28 的手写数字看成 28 行组成的序列,让各行互相交换信息,最后合成一个向量判断是哪个数字。
页面里所有张量形状和参数量都是按代码推算的,没有实际运行过,也不写任何训练结果。
先认识这几个词
读之前最好先读完 T03a,并懂 L07e 讲的 Transformer 结构。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| encoder layer | 编码器层 | Transformer 的一个基本块:多头注意力加前馈网络,各带一条残差和一次归一化 |
| 残差 | residual connection | 把子层的输入直接加到输出上,信息和梯度都能抄近路 |
| LayerNorm | Layer Normalization | 对每个元素自己的 128 个数做归一化,和 batch 里其他样本无关 |
| FFN | feed-forward network,前馈网络 | 对每个元素单独过两层全连接,元素之间不交换信息 |
| 位置编码 | positional encoding | 给第几个元素加一个专属向量,让模型知道顺序 |
| ModuleList | 模块列表 | 装一串子模块的列表,PyTorch 能自动找到里面的参数 |
| batch_first | 读「batch first」 | 官方层的开关:张量第一维是 batch 还是序列 |
题目地图
下半场两处填空加主程序,代码在同一个 .py 文件里。
| 部分 | 代码位置 | 要写什么 | 主要失分点 |
|---|---|---|---|
| 填空五 | Line #136~164,TransformerEncoderLayer |
注意力、残差、归一化、前馈 | 残差加在归一化之后 |
| 填空六 | Line #203~218,分类器 forward |
fc1、位置编码、叠层、max、fc2 | torch.max 返回两个值 |
| Stage 0 | 数据 | 与 Tutorial 2 相同,batch 改为 256 | 测试集 download=False |
| Stage 2、3 | 训练与评估 | 与 Tutorial 2 相同的四步 | 图片先 reshape 成三维 |
主程序的模型配置:输入 28 维、2 层、128 维、4 个头、10 类、序列长 28。
概念卡
1. 图片怎么变成序列
人话定义:Transformer 吃的是一串元素。把 28 × 28 的图按行切开,每一行 28 个像素就是一个元素,整张图是 28 个元素的序列。
例子:代码写 images.reshape(-1, 28, 28),把 (256, 1, 28, 28) 变成 (256, 28, 28),去掉的是通道那一维。L07 课堂演示的 LSTM 代码也是这样喂图片的,区别在于 LSTM 一行一行按顺序读,Transformer 让 28 行同时互相看。
常见误解
以为序列长必须等于每个元素的维度 → 两者都是 28 只是巧合。序列长由图有几行决定,元素维度由每行几个像素决定,fc1 会把元素维度升到 128。
回讲义:L07c-2 课堂代码:LSTM 把一张手写数字读成 28 步序列
2. 残差加 LayerNorm
人话定义:每个子层(注意力、前馈)的输出先加回它自己的输入,再做一次 LayerNorm。这样子层只需学「在输入上改多少」,叠深了也好训练。
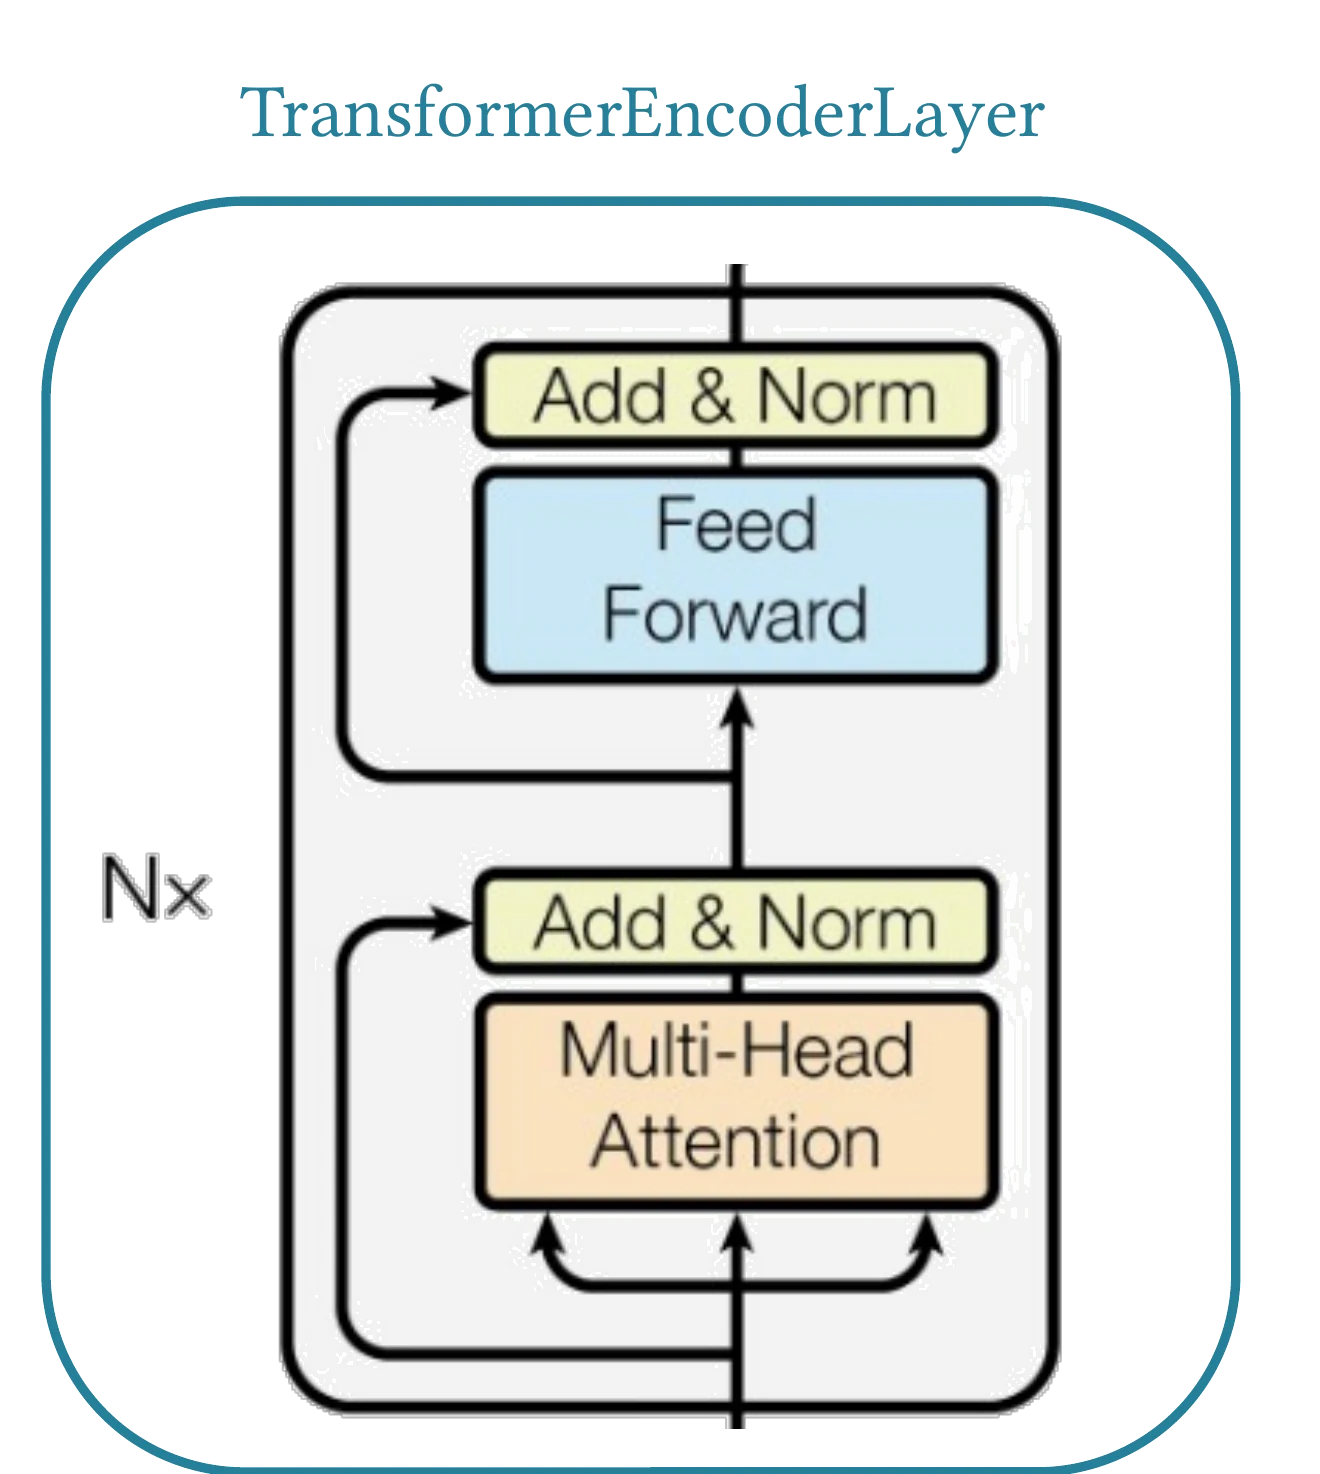
例子:填空五的 forward 就是两遍同样的套路:x = LN(attn(x) + x),out = LN(ff(x) + x)。两个子层进出形状都是 (256, 28, 128),整层也是,所以想叠几层就叠几层。
常见误解
以为 LayerNorm 和 Tutorial 2 的 BatchNorm 一样跨样本求均值 → LayerNorm 只在一个元素自己的 128 个数里求均值方差,训练和测试行为相同,不需要 model.eval() 来切换。
回讲义:L07e Transformer 自注意力:去掉循环,只留 attention
3. 位置编码:告诉模型谁在第几行
人话定义:注意力只看内容相似度,把 28 行打乱顺序,每行得到的结果也只是跟着换位置。要让模型知道第几行,就得给每个位置加一个专属向量。
例子:代码用 nn.Embedding(28, 128),相当于一张 28 行、每行 128 个数的可学习表。pos_embedding(torch.arange(28)) 取出整张表,形状 (28, 128),加到 (256, 28, 128) 上时自动广播到每张图。
常见误解
以为位置编码一定是正弦函数 → 原论文用正弦,课件的图也画了正弦符号,但这份代码用的是可学习的表。两种都可以,区别是可学习的版本只认训练时见过的长度。
回讲义:L07e Transformer 自注意力:去掉循环,只留 attention
4. 把 28 个元素合成一个向量
人话定义:分类只要一个答案,但 Transformer 输出的是 28 个向量。代码在序列维上取最大值:128 个维度各自在 28 行里挑最大的那个,得到一个 128 维向量。
例子:out, _ = torch.max(x, dim=1),(256, 28, 128) 变成 (256, 128)。torch.max 指定维度时返回最大值和下标两样东西,这里只要最大值。
常见误解
以为 max 的是 128 那一维 → dim=1 是序列维(28),被消掉的是它。和 CNN 的 max-pooling 一样,都是在一个范围内留最强的响应。
回讲义:L06c max-pooling 与典型 CNN:把图快速缩小,再把零件装起来
逐题拆解
填空五:TransformerEncoderLayer
课件给出的结构如下:多头注意力、残差加归一化、前馈网络、再一次残差加归一化,整块重复 N 次。
class TransformerEncoderLayer(nn.Module):
    def __init__(self, emb_dim, num_heads):
        super().__init__()
        self.attn = MultiHeadAttention(emb_dim, num_heads=num_heads)
        self.layer_norm = nn.LayerNorm(emb_dim)
        self.ff = nn.Sequential(
            nn.Linear(emb_dim, emb_dim),
            nn.ReLU(),
            nn.Linear(emb_dim, emb_dim)
        )

    def forward(self, x):
        res = x
        x = self.attn(x)
        x = x + res
        x = self.layer_norm(x)
        res = x
        out = self.ff(x)
        out = out + res
        out = self.layer_norm(out)
        return out
res 先存下进子层之前的值,子层算完加回去,再归一化。注意整个类只建了一个 self.layer_norm,两处共用,和图上两个独立的 Add & Norm 不一样,见「课件里的坑」。前馈网络的中间层也是 128 维;官方实现默认会把中间层放大到 2048。
填空六:分类器的 forward
def forward(self, x):
    bs, seq_len, C = x.shape
    x = self.fc1(x)
    positions = self.pos_embedding(torch.arange(seq_len, device=x.device))
    x = x + positions
    for layer in self.transformer_layers:
        x = layer(x)
    out, _ = torch.max(x, dim=1)
    out = self.fc2(out)
    return out
torch.arange(seq_len, device=x.device) 生成 0 到 27 这 28 个位置编号,放在和输入相同的设备上,否则 GPU 上会报设备不一致。self.transformer_layers 是 __init__ 里用 nn.ModuleList 装好的 2 层;用普通 Python 列表装的话,优化器找不到这些层的参数。
一步一步看
目标:跟着 256 张图的一个 batch 走完分类器,看清每一步之后形状是什么。
每帧多露出一行,青绿色是这一步新出现的形状。
-
图片变序列:
(256, 1, 28, 28)reshape 成(256, 28, 28)。
-
fc1 加位置编码:每个元素从 28 维升到 128 维,得
(256, 28, 128)。
-
两层 encoder:形状不变,28 行之间交换了信息。
-
沿序列维取最大值:
(256, 128)。
-
fc2:
(256, 10),交给交叉熵损失。
主程序:训练与评估
数据、损失函数、优化器和 Tutorial 2 一样,只有三处不同:batch 改成 256,图片 reshape 成 (-1, 28, 28) 而不是拉平,模型和数据都 .to(device)。
按 batch 256 推算:训练集每轮 235 步,最后一批 96 张;每 100 步打印一次,每轮打印 2 次,10 轮共 20 行、2350 次参数更新。测试集 40 批,最后一批 16 张。
参数量
按公式数出来(未实跑)。Linear(128, 128) 有 16,512 个参数,多头注意力三个、前馈网络两个;一个 LayerNorm 有 256 个。
两层 encoder 一共 165,632,占全部参数九成以上。
完整脚本
带答案版代码本身完整可跑。下面原样保留模型部分,主程序只改两处,标了 # [改]:训练打印换成不带续行的写法,测试前切 model.eval()。本页没有运行过它。
import math
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms


class Attention(nn.Module):
    def __init__(self, emb_dim):
        super().__init__()
        self.linear_q = nn.Linear(emb_dim, emb_dim)
        self.linear_k = nn.Linear(emb_dim, emb_dim)
        self.linear_v = nn.Linear(emb_dim, emb_dim)

    def forward(self, x):
        x_q, x_k, x_v = self.linear_q(x), self.linear_k(x), self.linear_v(x)
        qk = torch.bmm(x_q, x_k.permute(0, 2, 1))
        qk /= math.sqrt(x_q.shape[-1])
        attn = qk.softmax(-1)
        return torch.bmm(attn, x_v)


class MultiHeadAttention(Attention):
    def __init__(self, emb_dim, num_heads):
        super().__init__(emb_dim)
        self.num_heads = num_heads

    def _reshape_to_batches(self, x):
        batch_size, seq_len, emb_dim = x.shape
        sub_dim = emb_dim // self.num_heads
        x = x.reshape(batch_size, seq_len, self.num_heads, sub_dim)
        x = x.permute(0, 2, 1, 3)
        return x.reshape(batch_size * self.num_heads, seq_len, sub_dim)

    def _reshape_from_batches(self, x):
        batch_size, seq_len, sub_dim = x.shape
        batch_size //= self.num_heads
        x = x.reshape(batch_size, self.num_heads, seq_len, sub_dim)
        x = x.permute(0, 2, 1, 3)
        return x.reshape(batch_size, seq_len, self.num_heads * sub_dim)

    def forward(self, x):
        x_q, x_k, x_v = self.linear_q(x), self.linear_k(x), self.linear_v(x)
        if self.num_heads > 1:
            x_q = self._reshape_to_batches(x_q)
            x_k = self._reshape_to_batches(x_k)
            x_v = self._reshape_to_batches(x_v)
        qk = torch.bmm(x_q, x_k.permute(0, 2, 1))
        qk /= math.sqrt(x_q.shape[-1])
        attn = qk.softmax(-1)
        out = torch.bmm(attn, x_v)
        if self.num_heads > 1:
            out = self._reshape_from_batches(out)
        return out


class TransformerEncoderLayer(nn.Module):
    def __init__(self, emb_dim, num_heads):
        super().__init__()
        self.attn = MultiHeadAttention(emb_dim, num_heads=num_heads)
        self.layer_norm = nn.LayerNorm(emb_dim)
        self.ff = nn.Sequential(nn.Linear(emb_dim, emb_dim), nn.ReLU(),
                                nn.Linear(emb_dim, emb_dim))

    def forward(self, x):
        x = self.layer_norm(self.attn(x) + x)
        return self.layer_norm(self.ff(x) + x)


class TransformerImageClassifier(nn.Module):
    def __init__(self, input_dim, num_layers, transformer_emb_dim,
                 transformer_num_heads, num_classes, seq_len):
        super().__init__()
        self.fc1 = nn.Linear(input_dim, transformer_emb_dim)
        self.transformer_layers = nn.ModuleList(
            [TransformerEncoderLayer(transformer_emb_dim, transformer_num_heads)
             for _ in range(num_layers)])
        self.fc2 = nn.Linear(transformer_emb_dim, num_classes)
        self.pos_embedding = nn.Embedding(seq_len, transformer_emb_dim)

    def forward(self, x):
        bs, seq_len, C = x.shape
        x = self.fc1(x)
        x = x + self.pos_embedding(torch.arange(seq_len, device=x.device))
        for layer in self.transformer_layers:
            x = layer(x)
        out, _ = torch.max(x, dim=1)
        return self.fc2(out)


if __name__ == '__main__':
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    batch_size = 256
    tf = transforms.ToTensor()
    train_dataset = torchvision.datasets.MNIST(root='data', train=True, download=True, transform=tf)
    test_dataset = torchvision.datasets.MNIST(root='data', train=False, download=False, transform=tf)
    train_dataloader = torch.utils.data.DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
    test_dataloader = torch.utils.data.DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

    model = TransformerImageClassifier(input_dim=28, num_layers=2, transformer_emb_dim=128,
                                       transformer_num_heads=4, num_classes=10, seq_len=28).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

    num_epochs = 10
    total_step = len(train_dataloader)
    for epoch in range(num_epochs):
        for i, (images, labels) in enumerate(train_dataloader):
            images = images.reshape(-1, 28, 28).to(device)
            labels = labels.to(device)
            outputs = model(images)
            loss = criterion(outputs, labels)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            if (i + 1) % 100 == 0:
                print(f'Epoch [{epoch + 1}/{num_epochs}], '              # [改] 不用反斜杠续行
                      f'Step [{i + 1}/{total_step}], Loss: {loss.item():.4f}')

    model.eval()                                                         # [改]
    num_correct, num_total = 0, 0
    with torch.no_grad():
        for images, labels in test_dataloader:
            images = images.reshape(-1, 28, 28).to(device)
            labels = labels.to(device)
            _, predictions = torch.max(model(images), dim=1)
            num_total += labels.shape[0]
            num_correct += (predictions == labels).sum().item()
    print(f'Accuracy: {num_correct / num_total * 100:.2f}%')
模型里没有 BatchNorm 和 Dropout,所以 model.eval() 在这里不影响结果。加上它是为了以后换成带 Dropout 的官方层时不出错。
课件里的坑
- [与图不符] p.22 的图有两个独立的 Add & Norm,代码只建了一个
self.layer_norm两处共用,两个子层被迫共享同一组缩放和平移参数。能跑,但不是图上的结构。标准写法是self.norm1、self.norm2各建一个,见变式 1。 - [与图不符] p.23 在 encoder 下方画的是正弦位置编码的符号,代码用的是可学习的
nn.Embedding。两种都能用,课件没有说明换了。 - [坑] 代码注释里给了换成官方
nn.TransformerEncoderLayer的写法,但官方层默认batch_first=False,要求输入是(序列, batch, 维度)。本代码传的是(batch, 序列, 维度),照注释替换不会报错(都是三维),注意力却会在 256 张图之间做,而不是在 28 行之间做。要加batch_first=True。官方层还默认dropout=0.1,换上之后测试前必须model.eval()(官方文档)。 - [课件留白] 训练打印用 f-string 加反斜杠续行,续行开头的缩进空格会原样打进输出,一行里夹着一大段空白。
- [课件留白] p.18 的代码截图 batch 是 64,主程序实际用 256。上面的步数都按 256 算。
- [课件留白] 测试集写
download=False,靠的是训练集那一行已经下载过:torchvision 的 MNIST 下载时训练和测试的四个文件一起下(torchvision 源码)。单独先建测试集会报找不到文件。
课后 10 分钟:考点复习
这 10 分钟怎么用:先遮住必背清单默写七条;再做完整例题,按组件逐个数参数;最后做两道变式题,先写形状或公式再下结论。
必背
- Encoder 层两个子层:x = LN(attn(x) + x),out = LN(ff(x) + x);进出形状都是 (B, S, E),所以可以叠任意多层
- 图片变序列:(B, 1, 28, 28) reshape 成 (B, 28, 28),每一行像素是一个元素,共 28 个元素、每个 28 维
- 分类器四步:fc1 升到 128 维并加位置编码 → 叠 Transformer 层 → 沿序列维 max 合成 (B, 128) → fc2 输出 (B, 10)
- 位置编码 nn.Embedding(28, 128) 是可学习的,形状 (28, 128) 靠广播加到每张图上;没有它注意力分不出元素的先后
- 参数量 174,218:fc1 3,712,每层 encoder 82,816(MHA 49,536 + LN 256 + FFN 33,024),pos 3,584,fc2 1,290
- 官方 nn.TransformerEncoderLayer 默认 batch_first=False,吃 (S, B, E);直接喂 (B, S, E) 不报错但注意力做在 batch 维上
- batch 256 时训练集每轮 235 步、最后一批 96 张;测试集 40 批、最后一批 16 张
完整例题
把主程序的模型改成 transformer_emb_dim=64、num_layers=3,其余不变(输入 28 维、4 个头、10 类、序列长 28)。数出全部可训练参数。
第一步,fc1。 Linear(28, 64):28 × 64 + 64 = 1856。
第二步,一层 encoder。 一个 Linear(64, 64) 是 64 × 64 + 64 = 4160。多头注意力三个:12,480。LayerNorm 一个:2 × 64 = 128。前馈网络两个:8320。一层合计 12,480 + 128 + 8320 = 20,928。
第三步,三层。 3 × 20,928 = 62,784。
第四步,位置编码和 fc2。 Embedding(28, 64):28 × 64 = 1792。Linear(64, 10):64 × 10 + 10 = 650。
合计。 1856 + 62,784 + 1792 + 650 = 67,082。
头数不影响参数量:切成几个头都是同一个 Linear(64, 64) 的输出。
变式题(先自己做)
变式 1 按课件图的结构改代码:每层用两个独立的 LayerNorm(norm1、norm2),多头注意力在拼回之后再加一个输出 Linear(128, 128)。其余配置同主程序。(a)TransformerEncoderLayer 的 __init__ 和 forward 怎么写?(b)每层参数变成多少?(c)全模型多少?
提示
多出来的只有两样:一个 LayerNorm,一个 Linear(128, 128)。先算每层多多少,再乘层数。
参考答案与自检(非官方评分标准)
(a)
def __init__(self, emb_dim, num_heads):
    super().__init__()
    self.attn = MultiHeadAttention(emb_dim, num_heads=num_heads)
    self.linear_o = nn.Linear(emb_dim, emb_dim)
    self.norm1 = nn.LayerNorm(emb_dim)
    self.norm2 = nn.LayerNorm(emb_dim)
    self.ff = nn.Sequential(nn.Linear(emb_dim, emb_dim), nn.ReLU(), nn.Linear(emb_dim, emb_dim))

def forward(self, x):
    x = self.norm1(self.linear_o(self.attn(x)) + x)
    return self.norm2(self.ff(x) + x)
(b)每层多 256 + 16,512 = 16,768,变成 82,816 + 16,768 = 99,584。
(c)两层多 33,536,全模型 174,218 + 33,536 = 207,754。
自检:(b)答出 99,584 就对了。只加了 LayerNorm 没加输出层的,回头对照课件图里 Concat 之后那个 Linear。
变式 2 有人照注释把自己的层换成 nn.TransformerEncoderLayer(d_model=128, nhead=4, dim_feedforward=128),其余不动。(a)传进去的张量形状是什么,官方层把它理解成什么?(b)会报错吗?(c)怎么改?
提示
官方层默认 batch_first=False,把第一维当序列长、第二维当 batch。
参考答案与自检(非官方评分标准)
(a)传进去的是 (256, 28, 128)。官方层把它当成序列长 256、batch 28:每个「样本」是 28 行中的某一行,注意力在 256 张不同的图之间做。
(b)不报错。三维、最后一维 128,形状完全合法,只是含义错了。模型仍能训练,但每张图的预测会受同一 batch 里其他图影响,评估时换个 batch 大小结果就会变。
(c)加 batch_first=True。另外官方层默认 dropout=0.1,测试前要 model.eval()。
自检:说出「不报错、注意力做在图与图之间」才算对。
闪卡自测
Encoder 层的 forward 写成两行是什么?
x = LN(attn(x) + x);out = LN(ff(x) + x)。
为什么 encoder 层能随便叠几层?
进出形状相同,都是 (B, S, E)。
一张 MNIST 图变成序列后,序列多长、每个元素几维?
28 个元素,每个 28 维。fc1 再把每个元素升到 128 维。
位置编码的形状?怎么加到 (256, 28, 128) 上?
(28, 128),靠广播加到每张图上。
torch.max(x, dim=1) 返回什么?消掉哪一维?
最大值和下标两样;消掉序列维 28,得 (256, 128)。
为什么用 nn.ModuleList,不用普通列表?
普通列表里的层不会被注册,model.parameters() 找不到它们,优化器就不会更新。
LayerNorm 和 BatchNorm 的区别?
LayerNorm 在一个元素自己的特征上归一化,与 batch 无关,训练和测试行为一样;BatchNorm 跨 batch 求统计量。
一层 encoder 多少参数?
82,816:多头注意力 49,536、LayerNorm 256、前馈网络 33,024。
官方层的 batch_first 默认值?
False,输入要 (序列, batch, 维度)。
batch 256 时一轮训练多少步?
235 步,最后一批 96 张。
下一步
- 不看代码,默写
TransformerEncoderLayer的forward和分类器forward,标出每行之后的形状。 - 有 GPU 环境的话跑一遍完整脚本;再把位置编码那一行注释掉跑一次,对比测试准确率。
- 做完变式 1 的改写,用
sum(p.numel() for p in model.parameters())核对 207,754。 - 回到 L07e 对照原论文结构,找出本代码还省掉了哪些部件(输出 Linear、dropout、前馈层放大)。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。