L04b 搭网络:加宽加深、选激活函数、配输出层
隐藏层能解决 XOR 之后,网络怎么搭:加宽和加深各是什么、参数怎么一层层数,激活函数为什么必须是弯的,输出层和损失函数怎么按任务配对。
一句话版
神经网络就是把很多个神经元横着并排(加宽)、竖着叠起来(加深)。参数按层数,每层是「(上一层宽度 + 1)× 本层宽度」。隐藏层的激活函数必须是弯的,输出层接什么激活、配什么损失,由任务是回归还是分类决定。
上一页 L04a 讲了为什么需要隐藏层。这一页讲网络怎么搭起来。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 宽度 | width | 一层里有几个神经元 |
| 深度 | depth | 网络有几层 |
| 全连接 | fully connected | 上一层每个神经元都连到下一层每个神经元 |
| 偏置 | bias | 每个神经元自带的那个「基础分」,也是一个参数 |
| ReLU | Rectified Linear Unit,读「瑞路」 | 负数变 0、正数原样输出的激活函数 |
| tanh | hyperbolic tangent,双曲正切 | 形状像 sigmoid,但输出在 −1 到 1 之间 |
| softmax | 读「软 max」 | 把一组得分变成一组加起来为 1 的概率 |
| one-hot | 独热编码 | 真实类别那一位是 1、其余全是 0 的标签写法 |
一个类比:搭一支评审团
一个评审员看一份材料打一个分,这是一个神经元。
请三个评审员并排各看一遍,这是加宽:同一层多了几个人,各自从不同角度打分。让第一轮评审的打分再交给第二轮评审去看,这是加深:后面的人看的是前面的人的结论。
每个评审员要记住对每份输入材料的看重程度(权重),还有自己的基础分(偏置)。评审团的「参数」就是所有这些数字加起来。
最后一轮要交出结果。如果要报一个数(价格),直接报总分;如果要在几个候选里选一个,就要把分数换成「各有几成把握」,加起来正好十成。这一步就是输出层的激活。
类比在哪里失效:
- 真评审员会讨论、会改主意。网络里每个神经元只做一次加权求和加激活,前向时信息只往一个方向流。
- 评审员的看重程度是自己定的。网络的权重是训练出来的,开始时是随机数。
从零讲起
1. 加宽、加深与数参数
它解决什么问题
一个神经元不够,就要多放几个。放的方式只有两种:同一层里并排多放(加宽),或者再往上叠一层(加深)。不管怎么放,都得知道网络里一共有多少个要学的数,因为参数越多,要的数据和算力越多。
直觉
参数存在两个地方。一是连线上的权重,两层全连接时,每一对神经元之间都有一条线,所以线数是两层宽度相乘。二是每个神经元自己的偏置,一个神经元一个。
所以数参数时,一次只看相邻两层。可以把偏置想成上一层多了一个永远输出 1 的神经元,于是每层的参数就是「(上一层宽度 + 1)× 本层宽度」。
一步一步看
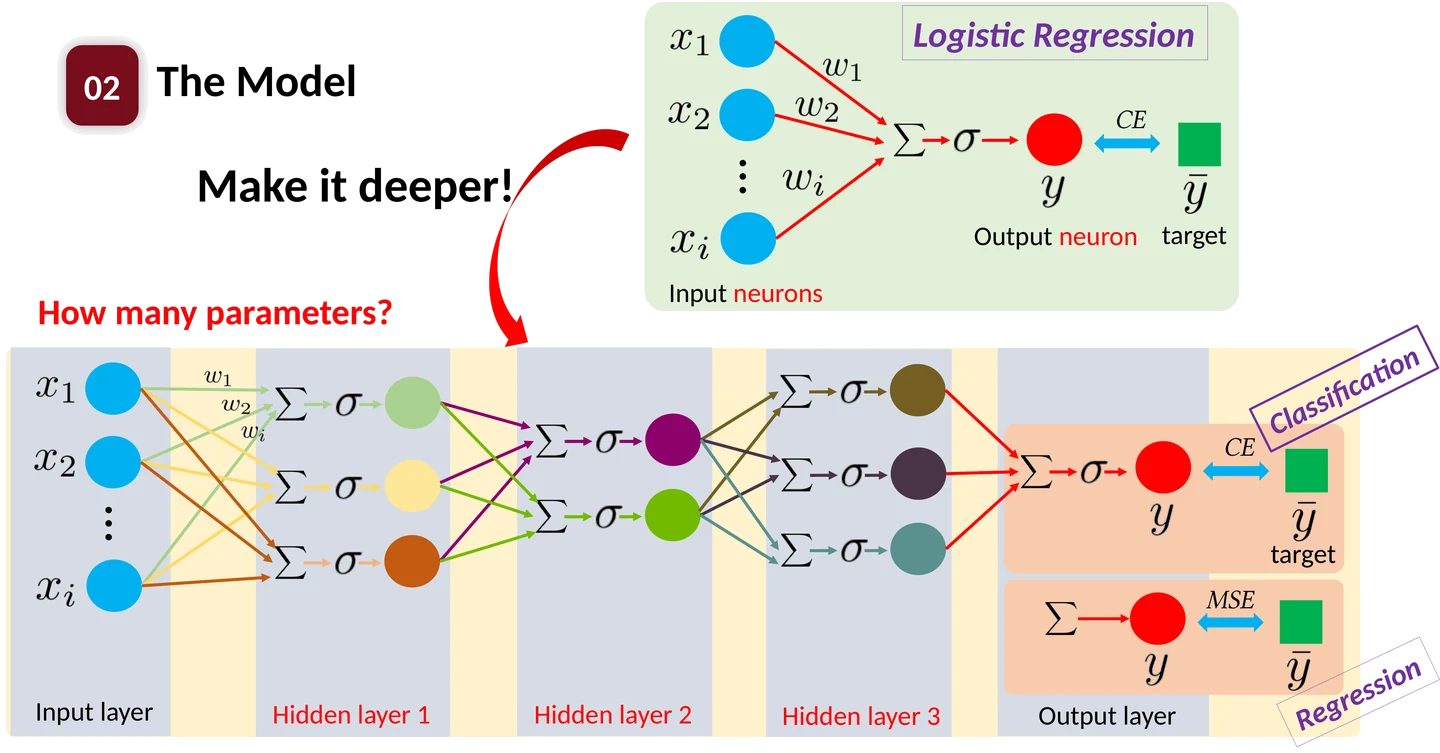
目标:把 i-3-2-3-1 网络的连线和偏置一组组数完,看每组都是上一层加 1 再乘本层宽度。
下面这个网络有 i 个输入,三个隐藏层的宽度依次是 3、2、3,输出 1 个。每一帧把正在数的那一组连线描成青绿。
-
输入层到隐藏层 1:每个隐藏神经元连 i 个输入,再加 1 个偏置。
-
隐藏层 1 到隐藏层 2:上一层 3 个加 1 个偏置,乘本层 2 个。
-
隐藏层 2 到隐藏层 3:(2 + 1) × 3 = 9。
-
隐藏层 3 到输出:(3 + 1) × 1 = 4。四组加起来就是总数。
怎么算
带偏置时:
总数 = (i + 1)·3 + (3 + 1)·2 + (2 + 1)·3 + (3 + 1)·1 = 3i + 3 + 8 + 9 + 4 = 3i + 24
不带偏置时,每层去掉那个 +1:
总数 = i·3 + 3·2 + 2·3 + 3·1 = 3i + 15
意思是:把相邻两层的宽度两两相乘再加起来,就是连线数;每个非输入的神经元再加一个偏置。i = 4 时,不带偏置是 27 个,带偏置是 36 个。
一般地,宽度依次是 n₀、n₁、…、n_L 的全连接网络:
参数总数 = (n₀ + 1)·n₁ + (n₁ + 1)·n₂ + … + (n_{L−1} + 1)·n_L
常见误解
以为参数个数等于神经元个数
参数存在连线上(权重)和神经元上(偏置),神经元本身只是计算的地方。两层全连接时,连线数是两层宽度的乘积,比神经元个数多得多。
给输入层也加了偏置
输入层只是把数据递进来,不做计算,没有偏置。偏置跟着「做计算的神经元」走:隐藏层和输出层每个神经元一个。
试一下
输入 5 维,隐藏层宽度 4、3,输出 2 个,都带偏置,共多少参数?
(5 + 1) × 4 + (4 + 1) × 3 + (3 + 1) × 2 = 24 + 15 + 8 = 47。
2. 激活函数:为什么必须是弯的
它解决什么问题
上一页说过,隐藏层的本事全在非线性激活上。这里回答两件事:常用的激活函数长什么样,为什么一定要弯。
直觉
直线接直线还是直线。如果每个神经元只做加权求和,第二层拿到的是第一层的线性组合,第二层算出来的又是一个线性组合,叠一百层也只等于一层。
激活函数在每一层后面「折一下」。有了这些折痕,叠起来的网络才能拼出弯曲的边界。
三个常用的激活函数,折法不同:sigmoid 和 tanh 是平滑的 S 形,ReLU 是在 0 处折一个角。
一步一步看
目标:把 −2、0、2 代进 sigmoid、ReLU、tanh 比输出,看三者形状各有什么特点,又为什么都不是线性的。
-
先看三条曲线的形状:sigmoid 和 tanh 是 S 形,ReLU 在负半轴是 0、正半轴是斜线。
-
取三个输入 −2、0、2,分别代进去,对比输出:
输入 sigmoid ReLU tanh −2 0.1192 0 −0.9640 0 0.5 0 0 2 0.8808 2 0.9640 -
观察:sigmoid 的输出都是正数;tanh 关于原点对称,正负成对;ReLU 对正数原样放行,对负数一律给 0。
-
三者都不满足「输入翻倍,输出也翻倍」,所以都是非线性的。
怎么算
三个公式:
- sigmoid(x) = 1 / (1 + e⁻ˣ)
- ReLU(x) = max(0, x)
- tanh(x) = 2 / (1 + e⁻²ˣ) − 1
意思是:sigmoid 把任意数压进 0 到 1;ReLU 只砍掉负数;tanh 把任意数压进 −1 到 1。
tanh 和 sigmoid 其实是一家:tanh(x) = 2·σ(2x) − 1。也就是先把输入放大 2 倍过 sigmoid,再把 (0,1) 拉伸平移到 (−1,1)。验算 x = 1:2 / (1 + e⁻²) − 1 ≈ 0.7616,与 tanh(1) 一致。
为什么一定要非线性,可以直接展开看。两层都不加激活时:
y = w₂(w₁x + b₁) + b₂ = (w₂w₁)x + (w₂b₁ + b₂)
意思是:两层合起来仍是「某个数乘 x 再加某个数」,和一层没有区别。
常见误解
以为输出层也必须带非线性
课件写的是输出层 may not 带非线性。回归任务常常直接输出加权和。必须带非线性的是隐藏层。
以为 ReLU 只是一条直线,不算非线性
ReLU 在 0 处折了一个角,负半轴和正半轴是两段不同的直线,合起来不是一条直线。很多个 ReLU 叠在一起,可以拼出任意折线形状。
试一下
算 ReLU(−3)、ReLU(1.5)、sigmoid(0)、tanh(0)。
ReLU(−3) = 0,ReLU(1.5) = 1.5,sigmoid(0) = 0.5,tanh(0) = 0。
3. 输出层怎么配激活和损失
它解决什么问题
隐藏层定好了,最后一层接什么、损失用什么?这取决于任务要输出什么。要报一个数,就是回归;要在两类里选一个,是二分类;要在 K 类里选一个,是多分类。三种任务各有固定搭配。
从哪来(补充)
softmax 这个名字是 John S. Bridle 在 1989 年的两篇会议论文里起的。同一个函数更早出现在统计力学里,叫 Boltzmann 分布,可以追到 Boltzmann 1868 年的工作。
出处:Wikipedia: Softmax function
直觉
回归要的是一个任意实数,输出层直接给加权和就行;如果目标不可能为负(价格、计数),可以套一个 ReLU 保证不出负数。
二分类要的是「属于正类的概率」,一个 0 到 1 的数,sigmoid 正好干这个。
多分类要的是 K 个概率,每个都是正数,加起来是 1。softmax 先用 exp 把每个得分变成正数,再除以总和。得分越高,分到的概率越大。
损失跟着走:回归量距离,用 MSE 或 MAE;分类量「真实类别的概率有多低」,用交叉熵。
一步一步看
目标:拿三类得分 (2, 1, 0) 走一遍 softmax 再算交叉熵,看得分怎样变成概率,预测越偏损失越大。
拿三类得分 (2, 1, 0) 走一遍 softmax。
-
输出层给出三个原始得分 2、1、0。它们可正可负,加起来不是 1,还不能当概率。
-
每个得分取 exp:7.389、2.718、1.000。全变成正数,总和 11.107。
-
各除以总和,得 0.665、0.245、0.090,加起来是 1。真实类别是第 1 类时,交叉熵 = −ln 0.665 ≈ 0.408。
-
如果真实类别是第 3 类,交叉熵 = −ln 0.090 ≈ 2.408。预测越偏,损失越大。
怎么算
三种任务的配对:
| 任务 | 输出层激活 | 损失 |
|---|---|---|
| 回归 | 不加,或加 ReLU | MSE 或 MAE |
| 二分类 | sigmoid | 交叉熵 CE |
| 多分类 | softmax | 交叉熵 CE |
softmax 和多分类交叉熵的公式:
- softmax(xᵢ) = exp(xᵢ) / Σⱼ exp(xⱼ),j 取遍全部 K 个类别
- CE = −Σᵢ ȳᵢ · ln yᵢ
意思是:softmax 先把每个得分变成正数,再按比例分掉总量 1。ȳ 是 one-hot 标签,只有真实类别那一位是 1,所以 CE 的求和里只剩一项,就是「真实类别那个概率取负对数」。概率越接近 1,损失越接近 0。
回归的两个损失:
- MSE = (1/N) Σᵢ (yᵢ − ȳᵢ)²
- MAE = (1/N) Σᵢ |yᵢ − ȳᵢ|
常见误解
以为多分类时每类各接一个 sigmoid 就行
每类一个 sigmoid,K 个输出各自在 0 到 1 之间,但加起来不一定是 1,不能当成「选一个类」的概率。softmax 把 K 个输出绑在一起,一个变大,其余必然变小。
以为分类也可以用 MSE
上一讲已经看到,sigmoid 配 MSE 时,预测很错的地方梯度反而接近 0,学得很慢。分类配交叉熵是这个原因。
试一下
三类得分改成 (1, 0, −1),softmax 结果是多少?和 (2, 1, 0) 比有什么发现?
exp 依次是 2.718、1.000、0.368,总和 4.086,softmax = (0.665, 0.245, 0.090),和 (2, 1, 0) 完全一样。所有得分同时加减同一个数,softmax 不变,因为分子分母同乘了同一个 exp。
把它们串起来
隐藏层能解决 XOR 之后,剩下的是搭网络的手艺。
加宽和加深是两种放神经元的办法。不管怎么放,参数都按相邻两层来数:上一层宽度加 1,乘本层宽度,逐层加起来。
隐藏层后面一定接一个弯的激活函数,sigmoid、ReLU、tanh 都行。没有这一步,再深的网络也只是一层线性模型。
输出层看任务配:回归直接输出(或加 ReLU)配 MSE/MAE,二分类配 sigmoid 和交叉熵,多分类配 softmax 和交叉熵。
结构搭好以后,参数还是靠梯度下降去找。问题变成:网络这么多层套在一起,损失对每个权重的导数怎么求。下一页从链式法则讲起。
课件里的坑
- [下标错误] p.22 softmax 分母的求和写成 j 从 0 到 K,共 K+1 项,而同页 CE 是 i 从 1 到 K,共 K 项。K 个类别时两处应对同一组 K 项求和,考试按「对所有类别求和」理解即可(p.22)
- [措辞] p.18 写的是输出层 may not 带非线性,意思是「可以不带」,不是「不能带」。回归任务目标不为负时,输出层加 ReLU 也是课件认可的做法(p.18、p.22)
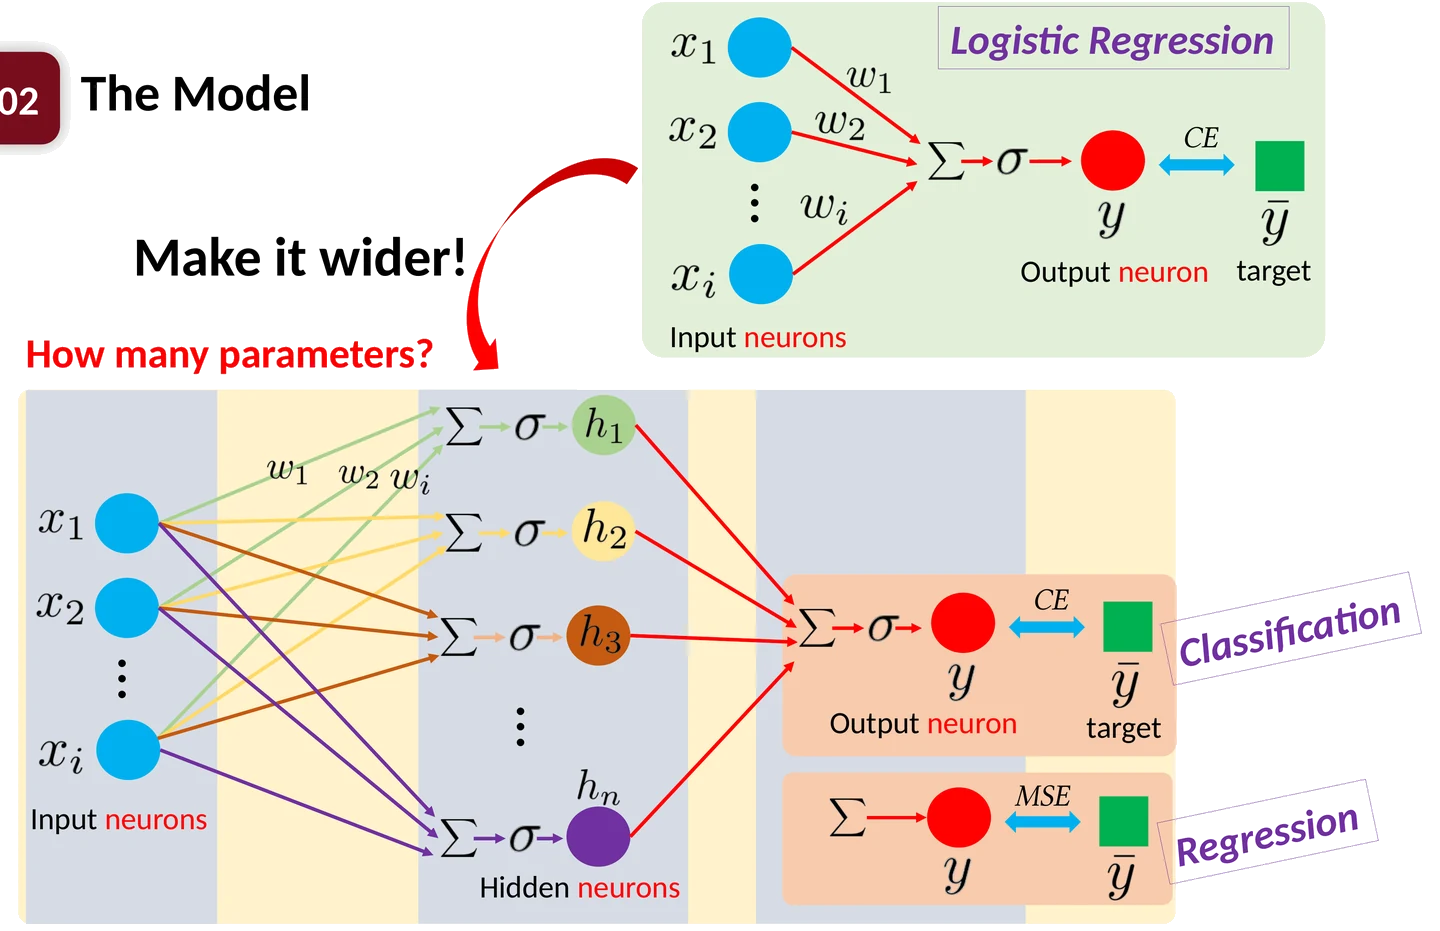
- [读图提醒] p.12 的加宽图没画偏置。课件只问「多少参数」时,先看清题目是否计偏置,两种答案都写出来最稳(p.12)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先在纸上画一个 i-3-2-3-1 的网络,自己数一遍带偏置和不带偏置的参数;再画出 sigmoid、ReLU、tanh 三条曲线,标出值域;然后默写三种任务的输出层配对表;最后把 (2, 1, 0) 的 softmax 手算一遍。
必背
- 全连接层参数个数 =(上一层宽度 + 1)× 本层宽度,不计偏置时去掉 +1。
- 加宽是同一层并排放更多神经元,加深是往上叠更多层;层数叫深度,每层神经元数叫宽度。
- 三种常用激活:sigmoid 值域 (0,1),ReLU 把负数截成 0,tanh 值域 (−1,1)。
- 隐藏层必须带非线性激活,输出层可以不带(课件原文 may not)。
- 输出层配对:回归配线性或 ReLU 加 MSE/MAE,二分类配 sigmoid 加 CE,多分类配 softmax 加 CE。
- softmax 把 K 个得分变成 K 个加起来为 1 的正数,再和 one-hot 标签一起算交叉熵。
课件例题
例 1(课件 p.12):把逻辑回归加宽,数参数
题面:输入 x₁…xᵢ 共 i 个,全部连到 n 个隐藏神经元,每个隐藏神经元是 Σ 后接 σ;n 个输出再进一个输出神经元。问一共多少个参数。
提示
分两组数:输入到隐藏层一组,隐藏层到输出一组。先按图(没画偏置)数一遍,再给每个 Σ 加上偏置数一遍。
解答
- 图里没画偏置。输入到隐藏层每个神经元 i 个权重,共 i·n 个;隐藏层到输出 n 个。合计 n(i+1)。
- 每个 Σ 都带偏置时,隐藏层 (i+1)·n,输出层 n+1,合计 (i+1)n + (n+1)。
- 验算:i = 2、n = 2 时不含偏置 6 个、含偏置 9 个,正好是上一页 p.16 回归网络的 w₁…w₉。
例 2(课件 p.13):把网络加深,数参数
题面:输入 i 个,三个隐藏层依次 3、2、3 个神经元,输出 1 个,相邻层全连接。问一共多少个参数。
提示
一次只看相邻两层,用「(上一层宽度 + 1)× 本层宽度」,四组加起来。
解答
- 不含偏置:3i + 3·2 + 2·3 + 3·1 = 3i + 15。
- 含偏置:(i+1)·3 + 4·2 + 3·3 + 4·1 = 3i + 24。
- 例如 i = 4 时分别是 27 和 36。
完整例题
题面(改编自课件 p.13 和 p.22):一个三分类网络,输入 4 维,三个隐藏层宽度依次 3、2、3,输出层 3 个神经元接 softmax,所有神经元带偏置。(1) 共多少参数?(2) 某样本输出层得分为 (2, 1, 0),求 softmax 概率;(3) 真实类别分别是第 1 类和第 3 类时,交叉熵各是多少?
约定:exp 和 ln 保留三位小数。
解法:
- 输入到隐藏 1:(4 + 1) × 3 = 15。
- 隐藏 1 到隐藏 2:(3 + 1) × 2 = 8。
- 隐藏 2 到隐藏 3:(2 + 1) × 3 = 9。
- 隐藏 3 到输出:(3 + 1) × 3 = 12。合计 15 + 8 + 9 + 12 = 44。
- 得分取 exp:e² = 7.389,e¹ = 2.718,e⁰ = 1.000,总和 = 11.107。
- softmax = 7.389 / 11.107, 2.718 / 11.107, 1.000 / 11.107 = (0.665, 0.245, 0.090)。
- 真实类别是第 1 类:ȳ = (1, 0, 0),CE = −ln 0.665 ≈ 0.408。
- 真实类别是第 3 类:ȳ = (0, 0, 1),CE = −ln 0.090 ≈ 2.408。
要点:输出层从 1 个变成 3 个,最后一组参数从 4 变成 12,前三组不变。交叉熵只看真实类别那一个概率。
答题格式:参数逐层列式再相加;softmax 先列 exp、再列总和、最后列商;CE 写出 ȳ 再代入。
变式题(先自己做)
改编自课件 p.13 和 p.22。输入 6 维,两个隐藏层宽度 5、4,输出 3 类 softmax,都带偏置。(1) 共多少参数?不带偏置呢?(2) 输出得分 (3, 1, 0),求 softmax 和真实类别为第 2 类时的交叉熵。
提示
三组相邻层,每组「(上一层 + 1)× 本层」。softmax 先算 e³ ≈ 20.086。
判分点与答案(非官方)
判分点:① 三组参数分别写对;② 不带偏置时去掉每组的 +1;③ softmax 三个值加起来是 1;④ CE 取的是第 2 类的概率。
- 带偏置:(6 + 1) × 5 + (5 + 1) × 4 + (4 + 1) × 3 = 35 + 24 + 15 = 74。
- 不带偏置:6 × 5 + 5 × 4 + 4 × 3 = 30 + 20 + 12 = 62。
- exp:20.086、2.718、1.000,总和 23.804;softmax ≈ (0.844, 0.114, 0.042)。
- 真实类别第 2 类:CE = −ln 0.114 ≈ 2.17。
闪卡自测
1. 加宽和加深各指什么?
加宽是同一层多放神经元,加深是多叠几层。层数叫深度,每层神经元数叫宽度(p.12、p.13)。
2. 输入 5 维,隐藏层宽度 4、3,输出 2 个,都带偏置,共多少参数?
(5+1)×4 + (4+1)×3 + (3+1)×2 = 24 + 15 + 8 = 47。
3. i-3-2-3-1 网络不带偏置有多少参数?
3i + 15;带偏置是 3i + 24(p.13)。
4. sigmoid、ReLU、tanh 的值域各是什么?
sigmoid (0,1);ReLU [0, +∞),负数截成 0;tanh (−1,1)(p.18)。
5. tanh 和 sigmoid 是什么关系?
tanh(x) = 2σ(2x) − 1。
6. 多分类输出层用什么激活和损失?
softmax 加交叉熵(p.22)。
7. 回归任务什么时候在输出层加 ReLU?
目标值不可能为负时(价格、计数),加 ReLU 保证预测不为负(p.22)。
8. p.22 的 softmax 公式哪里有问题?
分母求和写成 j 从 0 到 K,多了一项;应和 CE 一样对 K 个类别求和(p.22)。
9. 判断:输出层一定要带非线性激活。
错。课件写输出层 may not 带非线性,回归常直接输出加权和(p.18)。
下一讲
本讲下一页从梯度下降要什么讲起,补上链式法则,再把示例网络的每个局部导数列出来:L04c。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。