L03a-3 为什么非得是交叉熵:L2 的梯度在两端归零
把损失换回平方差,同样走三段链式,看 y(1−y) 约不掉以后梯度在错得最离谱的地方归零;再从最大似然出发,把交叉熵重新推一遍。
一句话版
逻辑回归能不能沿用上一讲的平方差损失?不能。平方差的梯度里留着 sigmoid 的导数 y(1 − y),预测贴到 0 或 1 时它趋于 0,模型错得最离谱的时候反而学不动。交叉熵能把这一项约掉,而且它可以从「让训练数据出现的概率最大」这条原理推出来。
梯度的三段链式推导见上一页 L03a-2,这一页直接拿来用。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| L2 loss | 平方差损失 (ȳ − y)² | 上一讲线性回归用的损失,预测和答案差的平方 |
| 损失曲面 | loss landscape | 把损失画成参数 w、b 的函数,得到的一张起伏的面 |
| 似然 | likelihood | 用当前参数,训练数据「恰好长这样」的概率 |
| 最大似然估计 | MLE,maximum likelihood estimation | 挑一组参数,让训练数据出现的概率最大 |
| 负对数似然 | NLL,negative log-likelihood | 似然取对数再加负号,把求最大变成求最小 |
| 连乘 | 符号 Π,读「派」 | 把一串数全部乘起来,和 Σ 全部加起来对应 |
一个类比:教练与装睡的学生
两位教练纠正投篮。第一位按「偏差」开口:偏得越多,说得越重。第二位的嗓门要再乘一个「学生现在有多清醒」:学生半睡半醒时他才大声,学生睡死了或者已经投得很准时,他都几乎不出声。
问题出在睡死的那位。他投得最差,最需要纠正,第二位教练却在这时候闭了嘴。
L2 loss 就是第二位教练。「清醒程度」是 sigmoid 的导数 y(1 − y),预测贴到 0 或 1 时它几乎为 0。交叉熵是第一位,嗓门只看偏差 y − ȳ。
类比在哪里失效:
- 预测贴近 1 而答案也是 1 时,L2 不出声是对的,那时本来就不该再推。L2 的毛病只在「贴到错的那一端」时暴露。
- 真实的教练能看出学生睡着了。梯度下降看不出,它只会按梯度大小迈步,梯度近 0 就原地踏步。
从零讲起
1. L2 的梯度在两端归零
它解决什么问题
上一讲的线性回归用平方差,这一讲换成了交叉熵。为什么要换?要看换回平方差会出什么事。
直觉
同样走三段链式,前两段 dy/dt = y(1 − y) 和 dt/dw = x 完全不变,只有第一段 dL/dy 换了。
交叉熵的第一段分母里有 y(1 − y),能和第二段约掉。平方差的第一段是 2(y − ȳ),没有分母,y(1 − y) 只好留在梯度里。y 贴近 0 或 1 时 y(1 − y) 几乎为 0,梯度跟着几乎为 0。
一步一步看
目标:让输出 y 从 0.01 走到 0.9,看交叉熵的推力随错误变大,L2 在错得最离谱时反而几乎不推。
固定 ȳ = 1、x = 1,让模型输出 y 从「错得离谱」走到「差不多对了」,每一步比较两种损失的梯度,柱子越长参数被推得越狠。
-
y = 0.01,错得最离谱。交叉熵梯度 y − ȳ = −0.99,L2 梯度 2 × (−0.99) × 0.01 × 0.99 ≈ −0.0196,几乎是零。
-
y = 0.5,半对半错。交叉熵梯度 −0.5,L2 梯度 2 × (−0.5) × 0.5 × 0.5 = −0.25,这是 L2 推得最狠的地方之一。
-
y = 0.9,差不多对了。交叉熵梯度 −0.1,L2 梯度 2 × (−0.1) × 0.9 × 0.1 ≈ −0.018。两者都变小,这一端变小是合理的。
-
三步并排看:交叉熵的推力随错误程度单调变大;L2 的推力在中间最大,到错的那一端反而缩回 0。
怎么算
L = (ȳ − y)²,三段分别是:
- dL/dy = 2(y − ȳ)
- dy/dt = y(1 − y)
- dt/dw = x
相乘:
dL/dw = 2(y − ȳ) · y(1 − y) · x
意思是:L2 的梯度等于「两倍误差 × sigmoid 的陡度 × 输入」,比交叉熵多出一个 y(1 − y)。
为了看出零点,把 x 取 1,展开成只含 y 的多项式:
dL/dw = 2(y − ȳ)(y − y²) = −2y³ + 2(1 + ȳ)y² − 2ȳy
代入两种标签:
- ȳ = 1:
−2y³ + 4y² − 2y = −2y(y − 1)² - ȳ = 0:
−2y³ + 2y² = −2y²(y − 1)
意思是:两条曲线在 y = 0 和 y = 1 都有根,所以梯度在两端都回到 0。ȳ = 1 那条在 (0, 1) 里恒为负,ȳ = 0 那条恒为正,方向没错,大小在两端塌掉。
常见误解
以为 L2 的梯度在两端为 0 是好事,说明快收敛了
对的那一端为 0 没问题。错的那一端(ȳ = 1 而 y ≈ 0)也为 0,模型错得最离谱却不动,这才是毛病。
以为 x 取 1 改变了结论
x 只是乘在外面的比例因子,不改变零点位置。取 1 只是为了把式子化成只含 y 的多项式,方便看根。
试一下
ȳ = 0、x = 1,模型给出 y = 0.99(错得离谱)。分别算交叉熵和 L2 的梯度。
交叉熵:y − ȳ = 0.99。L2:2 × 0.99 × 0.99 × 0.01 ≈ 0.0196。交叉熵照样大力往回推,L2 几乎不动,和 ȳ = 1 的情况左右对称。
2. 损失曲面:一张起伏的面和一张平板
它解决什么问题
上一个概念从一个样本的公式看梯度。换个角度,把所有训练点的损失画成 w、b 的函数,看整张面长什么样,就知道梯度下降在上面走不走得动。
直觉
梯度下降是在这张面上找最低点。面有坡,就知道往哪走;面是平的,往哪走损失都差不多,梯度近 0,一步只挪一点点。
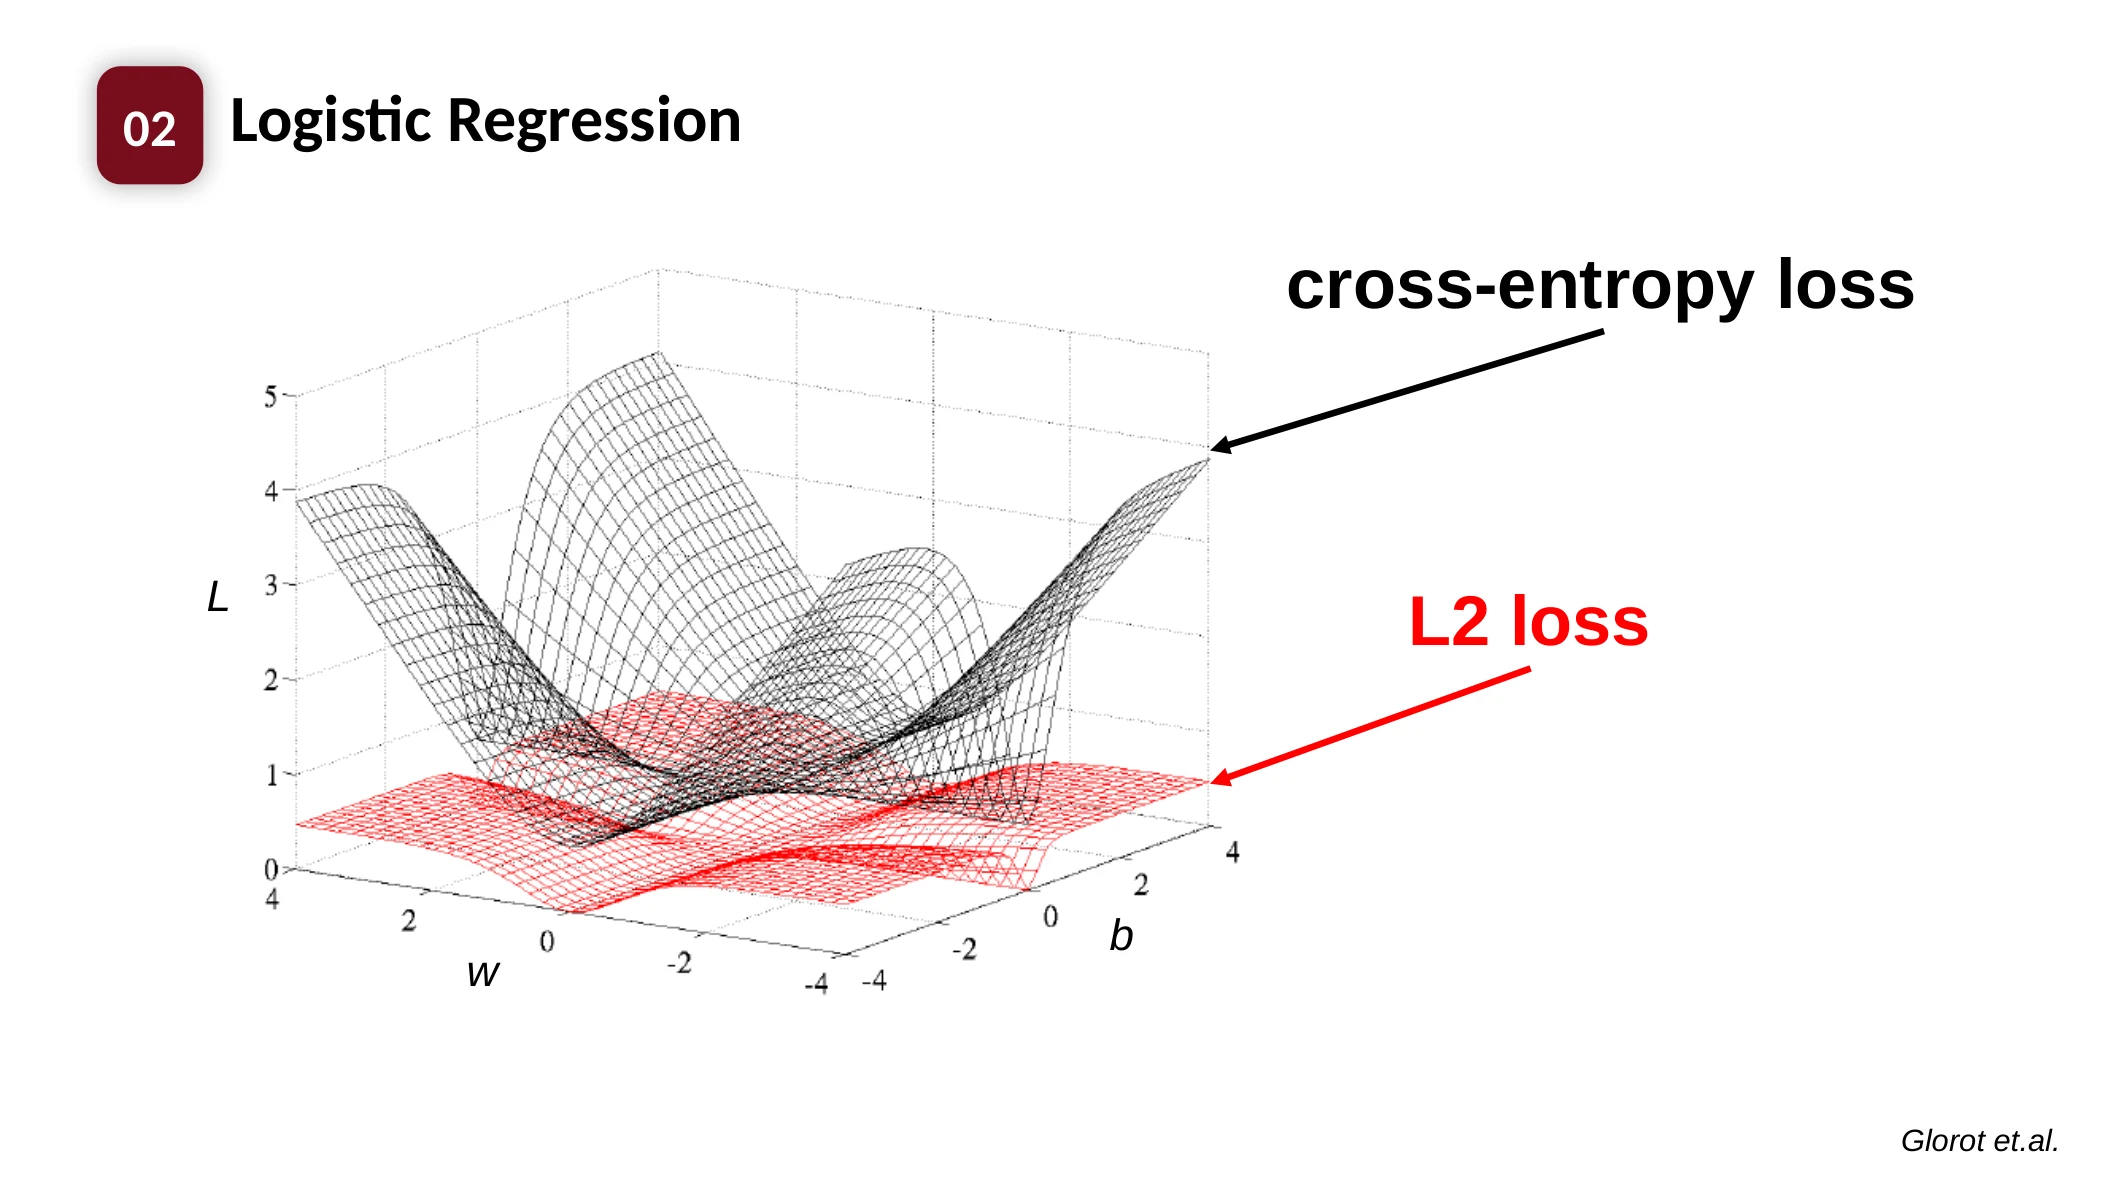
课件引用了 Glorot 等人的图:横轴是 w 和 b,竖轴是损失。黑色网格是交叉熵,起伏明显,从边缘的高处一路降到中间的谷底;红色网格是 L2,几乎是一张平板,只在中间有一点点凹陷。
一步一步看
目标:把同一起点放到交叉熵和 L2 两张曲面上走一步,看起点在错的一端时挪动量差约 50 倍。
把同一个起点放到两张面上,看梯度下降第一步能走多远。下表沿用上一个概念的单样本数据(ȳ = 1、x = 1),学习率 η = 1,只看 w 这一步的挪动量 η × |梯度|。
-
起点在错的一端,y = 0.01:交叉熵这一步挪 0.99,L2 只挪约 0.0196。
-
起点在中间,y = 0.5:交叉熵挪 0.5,L2 挪 0.25,差距缩到两倍。
-
起点在对的一端,y = 0.9:两者都只挪一点,交叉熵 0.1,L2 约 0.018。
-
随机初始化的起点大多落在曲面的大片平地上。L2 那张面几乎处处是平地,一步只走一点点,迭代很多轮也到不了谷底。
起点 y 交叉熵挪动量 L2 挪动量 交叉熵 ÷ L2 0.01 0.99 ≈ 0.0196 ≈ 50 0.5 0.5 0.25 2 0.9 0.1 ≈ 0.018 ≈ 5.6
怎么判断
看两样东西:
- 梯度表达式里有没有一个会趋于 0 的乘数没被约掉。有,就会在那个区域出现平地。
- 平地出现在哪。出现在「已经对了」的地方无害;出现在「还错着」的地方,训练就会卡住。
意思是:判断损失好不好用,要看它在错的地方给不给推力。L2 配 sigmoid 时两项都中招,交叉熵两项都没有。
结论页把两套模型并排放:左边交叉熵打勾,右边 L2 打叉。逻辑回归用交叉熵,不用 L2。
常见误解
以为平坦的曲面说明模型已经很好了
平坦只说明梯度小,和损失高低无关。L2 那张平板贴在 0.5 附近,离最好的情况还远,只是走不动。
以为把学习率调大就能救 L2
学习率是对所有位置一起放大,平地上的梯度从近 0 放大还是很小,有坡的地方却会被放大到冲过头。问题出在梯度形状上,调学习率治不了。
试一下
同样 ȳ = 1、x = 1,y = 0.1 时交叉熵与 L2 的挪动量之比大约是多少?
交叉熵 0.9,L2 = 2 × 0.9 × 0.1 × 0.9 = 0.162。比值 0.9 ÷ 0.162 ≈ 5.6,正好是 1/[2y(1 − y)] = 1/0.18。
3. 先补一块:连乘与对数(补充)
它解决什么问题
下一个概念要把很多个概率乘起来,再取对数。这里先把两件工具备好:连乘符号 Π 怎么读,为什么取对数能把乘变成加。
直觉
Σ 是「全部加起来」,Π 是「全部乘起来」。Π 下标写 n,就是对每个样本 n 各取一项,再全部相乘。
对数有一条性质:ln(a × b) = ln a + ln b。所以一串数的乘积取对数,等于每个数取对数再相加。
为什么要这样换?很多个小于 1 的概率相乘,结果小得飞快,计算机存不下这么小的数(下溢);对乘积求导也麻烦。换成连加,两件事都解决了。
一步一步看
目标:拿三个和一百个 0.5 分别连乘、取对数连加,看对数怎样把极小的连乘变成普通大小的数。
拿三个都等于 0.5 的概率走一遍。
-
连乘:0.5 × 0.5 × 0.5 = 0.125。
-
取对数:ln 0.125 ≈ −2.079。
-
先各自取对数再相加:ln 0.5 + ln 0.5 + ln 0.5 = 3 × (−0.693) ≈ −2.079,和上一步一样。
-
一百个 0.5 连乘约等于 7.9 × 10⁻³¹,取对数后是 100 × (−0.693) ≈ −69.3,一个很普通的数。
做法 三个 0.5 一百个 0.5 连乘 0.125 ≈ 7.9 × 10⁻³¹ 取对数后连加 ≈ −2.079 ≈ −69.3
怎么算
ln Πⁿ aⁿ = Σⁿ ln aⁿ
意思是:先乘后取对数,等于先取对数后加。
ln(a^k) = k · ln a
意思是:指数可以提到对数前面当系数。下一个概念里 ȳ 在指数上,取对数后它会变成乘在前面的系数。
另外,ln 是单调递增的:a 越大 ln a 越大。所以让乘积最大,和让它的对数最大,找到的是同一组参数。
常见误解
以为取了对数,最优解就变了
ln 单调递增,不改变谁大谁小,最大值出现的位置不变,只是最大值的数值变了。
以为 ln(a + b) = ln a + ln b
对数把乘变成加,不对加法起作用。ln(a + b) 没有这样的拆法。
试一下
ln(0.8 × 0.6) 等于多少?分别用两种做法算。
直接算:0.8 × 0.6 = 0.48,ln 0.48 ≈ −0.734。拆开算:ln 0.8 + ln 0.6 ≈ −0.223 + (−0.511) = −0.734。
4. 从最大似然推出交叉熵
它解决什么问题
交叉熵是直接给出来的,看着像拍脑袋。最大似然从「让训练数据出现的概率最大」这条原理出发,最后推出来的目标函数和交叉熵一字不差。
从哪来(补充)
现代形式的最大似然方法由统计学家 Ronald Fisher 在 1912 到 1922 年间独力建立。
出处:Wikipedia: Maximum likelihood estimation
直觉
换个说法读模型输出:σ(t) 是「这个点属于类别 1 的概率 p」,属于类别 0 的概率就是 1 − p。
每个训练点都有标准答案。模型给每个点「猜对的概率」:答案是 1 就取 p,答案是 0 就取 1 − p。假设各点互不影响,全部猜对的概率就是这些数连乘。参数越好,这个连乘越大。
一步一步看
目标:用四个训练点逐项写出似然里留下的因子,看连乘取对数加负号后怎样变成交叉熵。
用课件的四个一维训练点走一遍,看每一项留下什么。
-
x = −1.2,ȳ = 0:留下 1 − σ(t¹)。
-
x = −0.9,ȳ = 0:留下 1 − σ(t²)。
-
x = 0.8,ȳ = 1:留下 σ(t³)。
-
x = 1.1,ȳ = 1:留下 σ(t⁴)。四项相乘就是似然,取 ln 变连加,加负号变成要最小化的 NLL。
怎么算
把「答案是 1 取 p、答案是 0 取 1 − p」写成一个式子:
p(y) = Πⁿ σ(tⁿ)^{ȳⁿ} · [1 − σ(tⁿ)]^{1 − ȳⁿ}
意思是:ȳⁿ 只取 0 或 1,当开关用。ȳⁿ = 1 时第二个因子的指数是 0,整项变成 1 被关掉,只剩 σ(tⁿ);ȳⁿ = 0 时反过来,只剩 1 − σ(tⁿ)。
接下来三步:
- 取 ln,连乘变连加,指数变系数:
ln p(y) = Σⁿ [ȳⁿ ln σ(tⁿ) + (1 − ȳⁿ) ln(1 − σ(tⁿ))] - 加负号,最大化变最小化:
NLL = −Σⁿ [ȳⁿ ln σ(tⁿ) + (1 − ȳⁿ) ln(1 − σ(tⁿ))] - 把 σ(tⁿ) 换回记号 y,单个样本那一项就是
L = −ȳ ln y − (1 − ȳ) ln(1 − y)
意思是:负对数似然逐字等于交叉熵。最大似然 ≡ 最小化交叉熵。
最后一步怎么求解?最大似然只推出了目标函数,最小化它仍然要靠梯度下降,梯度就是上一页的 (y − ȳ)x。
常见误解
以为最大似然和梯度下降是两种并列的求解方法
两条路线前半截不同、后半截相同。交叉熵是直接给一个损失,最大似然是从概率原理推出同一个损失,求解都靠梯度下降。
以为模型输出的是标签
最大似然这个视角里,σ(t) 是属于类别 1 的概率 p。标签是拿 p 和阈值比较之后才得到的。
试一下
两个训练点,ȳ 分别为 1 和 0,模型给出的 σ(t) 分别为 0.8 和 0.3。似然和 NLL 各是多少?
第一点留下 0.8,第二点留下 1 − 0.3 = 0.7。似然 = 0.8 × 0.7 = 0.56。NLL = −ln 0.8 − ln 0.7 ≈ 0.223 + 0.357 = 0.580,等于两个点的交叉熵相加。
把它们串起来
逻辑回归能不能沿用平方差?把它代进三段链式就知道:第一段没有分母,sigmoid 的导数 y(1 − y) 约不掉,梯度在 y = 0 和 y = 1 两端都塌到 0。
塌在对的一端无害,塌在错的一端就是灾难,模型错得最离谱时反而不动。损失曲面图把同一件事画了出来:L2 那张面几乎是平板,梯度下降无处可下。
交叉熵没有这个毛病,而且它不是拍脑袋来的。把模型输出读作概率,训练数据全部猜对的概率是一串连乘;取对数、加负号,得到的负对数似然逐字就是交叉熵。
所以逻辑回归的三件套定下来了:线性一层、sigmoid、交叉熵,用梯度下降求解。下一页看这个模型到底在空间里画了一条什么样的线,以及怎么推广到很多类。
课件里的坑
- [读图提醒] p.18 把 L2 梯度展开成 −2y³ + 2(1 + ȳ)y² − 2ȳy 时,x 被当作 1 了,否则右边不可能化成只含 y 的多项式。不影响结论,手推时要写明这个前提(p.18)。
- [读图提醒] p.21 底部有一行在导出的图里被裁掉,内容是:若模型预测属于 ‘1’ 的概率是 p,则属于 ‘0’ 的概率就是 1 − p(p.21)。
- [排版误导] p.13 把梯度下降和最大似然排成「二选一」的两条路线,两者并不平行。p.21 证明最大似然推出的目标就是交叉熵,最后一步仍是梯度下降(p.13)。
- [悬念跨页] p.12 底部用橙色虚线框住 L2 loss 打了个问号,答案隔了好几页,到 p.18 推导、p.19 画图、p.20 才下结论。复习时三页连着看(p.12)。
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写 L2 梯度的三段和两个分支,指出两端的零点;再从「答案是 1 取 p」开始,把似然到交叉熵的三步写一遍;最后做完整例题和变式题。
必背
- L2 loss 用在逻辑回归上,梯度 2(y − ȳ)·y(1 − y)·x 里的 y(1 − y) 约不掉:ȳ = 1 时为 −2y(y − 1)²,ȳ = 0 时为 −2y²(y − 1)(x 取 1),两条在 y = 0 和 y = 1 两端都归零。
- L2 失效的要害:ȳ = 1 而 y ≈ 0 时错得最离谱,梯度却接近 0,参数几乎不动;交叉熵在同一位置梯度是 y − ȳ ≈ −1。
- 交叉熵的损失曲面起伏明显,L2 的曲面几乎是平板,梯度下降无处可下,所以逻辑回归用交叉熵、不用 L2。
- 最大似然:p(y = 1) = σ(t),似然写成 Πⁿ σ(tⁿ)^{ȳⁿ}·[1 − σ(tⁿ)]^{1 − ȳⁿ},指数 ȳⁿ 当开关,一个式子同时表达两种标签。
- 取对数变连加、加负号变最小化,负对数似然把 σ(t) 换回 y 就逐字等于交叉熵:最大似然 ≡ 最小化交叉熵;MLE 只推出目标函数,求解仍用梯度下降。
课件例题
例 1(课件 p.12,答案在 p.18–20):逻辑回归能不能继续用 L2 loss,L = 1/N Σ(ȳⁿ − yⁿ)²?
提示
只换三段链式的第一段,看 sigmoid 的导数 y(1 − y) 还能不能约掉;把 x 取 1,分 ȳ = 1 和 ȳ = 0 两种情况因式分解,找零点。
解答
不能。dL/dy = 2(y − ȳ),dy/dt = y(1 − y),dt/dw = x,合起来 dL/dw = 2(y − ȳ)·y(1 − y)·x,y(1 − y) 约不掉。x 取 1 时,ȳ = 1 得 −2y(y − 1)²,ȳ = 0 得 −2y²(y − 1),两条在 y = 0 和 y = 1 都归零。ȳ = 1 而 y ≈ 0 时错得最离谱,梯度却接近 0,训练卡死。p.19 的曲面图显示 L2 几乎是平板;p.20 结论:用交叉熵,不用 L2。
例 2(课件 p.21):用最大似然估计推导逻辑回归的目标函数,并说明它和交叉熵的关系。
提示
先把模型读作 p(y = 1) = σ(t),用指数开关把两种标签写进一个连乘,再取对数、加负号。
解答
p(y = 1) = σ(t),p(y = 0) = 1 − σ(t)。似然 p(y) = Πⁿ σ(tⁿ)^{ȳⁿ}·[1 − σ(tⁿ)]^{1 − ȳⁿ}。目标是最大化 p(y);取对数变连加,加负号变最小化,得 NLL = −Σⁿ [ȳⁿ lnσ(tⁿ) + (1 − ȳⁿ) ln(1 − σ(tⁿ))]。把 σ(tⁿ) 换回 y,每一项就是交叉熵 L = −ȳ ln y − (1 − ȳ) ln(1 − y)。所以最大似然等价于最小化交叉熵;之后用梯度下降求解(Then use gradient descent)。
完整例题
题面(改编自课件 p.18 与 p.15):样本 x = 0.8、ȳ = 1,当前 w = 0.5、b = 0(这组数是自设的)。分别算交叉熵和 L2 对 w 的梯度,比较两者大小。
约定:保留六位小数;L2 取单样本 L = (ȳ − y)²,不除 N。
解法:
- 前向:t = 0.4,y = σ(0.4) ≈ 0.598688。
- sigmoid 的陡度:y(1 − y) = 0.598688 × 0.401312 ≈ 0.240261。
- 交叉熵梯度:(y − ȳ)x = (−0.401312) × 0.8 ≈ −0.321050。
- L2 梯度:2(y − ȳ)·y(1 − y)·x = 2 × (−0.401312) × 0.240261 × 0.8 ≈ −0.154271。
- 比值:−0.321050 ÷ (−0.154271) ≈ 2.081,正好等于 1/[2y(1 − y)] = 1/0.480522。
要点:两个梯度方向相同,L2 只有交叉熵的一半左右。这个点 y 离 0.5 不远,差距还小;y 越贴近错的一端,差距越大。
答题格式:先写两个梯度的通式,再代数,最后写比值等于 1/[2y(1 − y)] 并说明它在两端趋于无穷。
变式题(先自己做)
改编自课件 p.18 与 p.15,换课件数据里的另一个点:x = −1.2、ȳ = 0,w = 0.5、b = 0。分别算两种梯度,求比值;再说出 y = 0.5 和 y = 0.01 时这个比值各是多少。
提示
比值和 x、ȳ 都无关,只看 y(1 − y)。
判分点与答案(非官方评分标准)
判分点:① L2 梯度写对三段并相乘;② 比值写成 1/[2y(1 − y)];③ 说出两端比值趋于无穷的含义。
- t = −0.6,y ≈ 0.354344,y(1 − y) ≈ 0.228784。
- 交叉熵:0.354344 × (−1.2) ≈ −0.425212。
- L2:2 × 0.354344 × 0.228784 × (−1.2) ≈ −0.194564。
- 比值 ≈ 2.186 = 1/[2 × 0.228784]。
- y = 0.5 时比值 1/(2 × 0.25) = 2;y = 0.01 时 1/(2 × 0.0099) ≈ 50。错得越离谱,L2 比交叉熵弱得越多。
闪卡自测
1. L2 loss 在逻辑回归里的梯度是什么?
dL/dw = 2(y − ȳ)·y(1 − y)·x(p.18)。
2. x 取 1 时,ȳ = 1 和 ȳ = 0 两个分支各是什么?
ȳ = 1:−2y(y − 1)²;ȳ = 0:−2y²(y − 1)(p.18)。
3. L2 失效的要害一句话怎么说?
错得最离谱时(ȳ = 1 而 y ≈ 0)梯度接近 0,参数几乎不动(p.18)。
4. 损失曲面图里交叉熵和 L2 各长什么样?
交叉熵起伏明显;L2 几乎是一张平板,梯度下降无处可下(p.19)。
5. 最大似然里模型输出怎么读?
σ(t) 是属于类别 1 的概率 p,属于类别 0 的概率是 1 − p(p.21)。
6. 似然式子里 ȳⁿ 放在指数上起什么作用?
当开关:ȳⁿ = 1 时只剩 σ(tⁿ),ȳⁿ = 0 时只剩 1 − σ(tⁿ)(p.21)。
7. 为什么要取对数?
连乘变连加,避免数值下溢、方便求导;ln 单调,不改变最优解位置(p.21)。
8. MLE 推完之后用什么求解?
仍用梯度下降,MLE 只负责推出目标函数(p.21)。
下一讲
三件套定下来了,这个模型在空间里画出的是什么?一个超平面。再往前一步,二分类推广到很多类,sigmoid 换成 softmax:L03a-4 决策边界与 softmax。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。