L02 Linear Regression:中介 A 的定价公式是怎么调出来的
第一个参数模型:定一条直线,用数据把斜率和截距算出来或试出来。
一句话版
先定一条直线,再用成交记录把斜率和截距定下来,最后拿没见过的房子检验这条线值不值得信。
一个类比:中介 A 的定价公式
上一讲有两个中介,B 把整本成交簿子背下来,A 只在纸条上留几个系数。这一讲整讲都在说 A。A 的纸条上写的是 价格 = w × 面积 + b:w 是每平方英尺加多少钱,b 是模型在面积为 0 时的预测截距,不等于现实中的土地底价。课件 demo 用的就是这张纸条,特征是面积 GrLivArea,标签是房价 SalePrice(p.40)。
A 的第一个问题是 w 和 b 填多少。纸条的形状是他自己定的,课件叫 Stage 1;填数字那一步才叫训练,课件叫 Stage 2(p.11)。填法有两种。一种是拿全部成交记录直接算一个公式,一次算完,这是最小二乘估计(p.18)。另一种是先随便写一组 w、b,给旧房子报价,看报高了还是报低了,往反方向拧一点,再报一次,拧到误差不再明显下降,这是梯度下降(p.21)。
第二个问题是填完了怎么知道好不好。A 不能拿训练时看过的房子自夸,得拿一批未用于拟合的记录评估。若据此反复改模型,这批记录应叫验证集;最终测试集另留(p.8, p.26)。验证成绩差,A 有三种办法:换个拧法重新训练、多收集记录、或者把纸条改复杂,比如加一项 面积²(p.26–27)。纸条加太多项会出另一个毛病:训练的房子全部报得极准,新房子反而离谱,这叫过拟合(p.30)。
类比在哪里失效:真实房价没有一条藏着的「正确直线」,成交价本身带噪声,所以最小的误差也到不了零,这也是为什么课件那个「损失小于 ε 就停」的判停条件在 demo 里永远触发不了(p.21, p.40)。本讲「线性模型 + 平方误差」可用闭式解;一般神经网络通常依赖数值优化,并非所有其他问题都没有闭式解。
概念卡
1. 参数模型与模型形态(parametric model, y = wᵀx + b)
人话定义:回归模型先把公式的形状定死,只留几个数字待填;输出永远是一个实数。
例子:课件用一张 4 个特征的表演示(p.13):第一行特征是 0.2、1、10、−3,标签 0.4。模型写成三种等价形式:逐项展开 y = w₁x₁ + w₂x₂ + w₃x₃ + w₄x₄ + b,行向量乘列向量,以及最紧凑的 y = wᵀx + b。参数一共 4 + 1 = 5 个,表格再多几千行也还是 5 个。课件接着在表里补一列恒为 1 的 x₅,模型变成 y = wᵀx,b 消失了,它变成了 w₅(p.14)。demo 代码正是这样做的:在标准化后的面积前面补一列 1,所以要学的 w 是二维向量(p.40)。
常见误解
「训练数据越多,线性回归的参数越多」→ 错。参数个数由特征维度 D 决定,是 D + 1,和样本数 N 无关;这条正是它和 KNN 的分界线(p.7, p.13)。
2. 均方误差与闭式解(MSE, least square estimator)
人话定义:每个训练点的真值减预测值,平方,再对所有点取平均,就是损失;损失最小的那组 w、b 是「最好」的。一维时这组数有现成公式。
例子:课件的定义式是 L(w,b) = (1/N) Σₙ (ȳⁿ − (wxⁿ + b))²(p.17),闭式解是 w = Σ(xⁿ−x̄)(ȳⁿ−ȳ) / Σ(xⁿ−x̄)²,b = ȳ − w·x̄(p.18)。拿三个点 (1,2)、(2,4)、(3,5) 走一遍:x̄ = 2,ȳ ≈ 3.667;分子 = (−1)(−1.667) + 0 + (1)(1.333) = 3,分母 = 1 + 0 + 1 = 2,所以 w = 1.5,b = 3.667 − 3 = 0.667。代回去三个预测是 2.167、3.667、5.167,MSE ≈ 0.0556。
课件在同一页问「平方和与 MSE 一样吗,和 MAE 呢」(p.17)。平方和与 MSE 只差常数 1/N,最小值点相同;MAE 用绝对值,是另一个函数,最优解一般不同。同页还给了四个词:loss 指单个样本的误差,error 与 loss 同义,cost 是全部样本的平均,objective 是最泛的说法。
常见误解
「闭式解是所有模型都有的」→ 错。它来自对 w、b 求偏导令零后解一个线性方程组,本讲闭式公式适用于线性最小二乘;换损失不能直接沿用,但不能推出只能梯度下降,例如 MAE 也可用线性规划(p.18, p.20)。
3. 梯度下降(gradient descent)
人话定义:从随机的 w 出发,算出损失往哪边升,然后朝相反方向挪一小步,重复到损失不再明显下降。
例子:课件把算法写成四步(p.21):随机初始化 w⁰;算 L(w),小于 ε 就停;算导数 dL/dw;更新 w¹ = w⁰ − η · dL/dw,η 叫学习率。两个参数时 w、b 各自求偏导、同时更新(p.22)。
还是那三个点,从 (w,b) = (0,0) 出发、η = 0.1。起点损失 15.000,两个偏导分别是 −16.667 和 −7.333,第一步走到 (1.667, 0.733),损失掉到 0.234;第二步梯度变成 +1.822 和 +0.800,走到 (1.484, 0.653),损失 0.058,已经贴近闭式解的 0.0556。
这两步正好回答了课件的三个问题(p.21)。步子一样大吗?不一样,每步挪动量是 η 乘梯度,越靠近谷底梯度越小,步子自动变短。更新量恒为负吗?第一步 w 往上冲、第二步往回拉,正负号由梯度的符号决定,只有「方向与梯度相反」不变。循环永远不停怎么办?加最大迭代次数,demo 设 2000 轮,实际约 300 轮后损失就不再变化(p.40)。
课件还画了一条有好几个坑的曲线问「一定下降吗」(p.23)。学习率太大会跨过谷底跳到更高处;损失不是碗形时会滚进局部的坑出不来。线性回归配 MSE 是凸二次函数,没有非全局的局部极小;设计矩阵满列秩时最优参数才唯一。学习率过大在线性回归中也会发散。
常见误解
「梯度下降和闭式解会得到不同的答案」→ 对线性回归 + MSE 来说,学习率合适、迭代够多,梯度下降就收敛到闭式解那一点。demo 跑完 2000 轮得到的 w 与闭式解完全一致,换算回原始尺度是「房价 ≈ 107.1 × 面积 + 18569」(p.40)。
4. 多项式基展开(polynomial basis expansion)
人话定义:在数据表里多加一列 x²(再加 x³……),直线就能弯,而模型仍然是线性回归。
例子:课件把训练表从 (x, y) 扩成 (x, x², y),模型变成 y = w₁x + w₂x² + b,然后问「它还是线性模型吗」(p.27)。答案是「是」:线性指的是对参数 w 线性,x² 只是一个新特征,闭式解和梯度下降照用不误。
次数每加一阶,训练误差只降不升,因为高阶模型把低阶模型当作特例包含在内(p.29)。输入不止一维时,可以用两个原始特征构造一个新特征 x₃ = k(x₁, x₂),思路同样是造特征让线性模型表达非线性(p.29)。
常见误解
「加了 x² 项就变成非线性模型了」→ 错,这是本讲最常见的判断题陷阱。判断线性看 w,看不看 x(p.27)。
5. 欠拟合、过拟合与偏差、方差(underfitting / overfitting, bias / variance)
人话定义:模型太简单,连训练集都贴不上,叫欠拟合,病根是偏差;模型太复杂,训练集贴得极好、新数据一塌糊涂,叫过拟合,病根是方差。
例子:课件的核心图横轴是模型复杂度,纵轴是误差。训练误差一路下降,测试误差先降后升,左端标 underfitting,右端标 overfitting(p.30)。
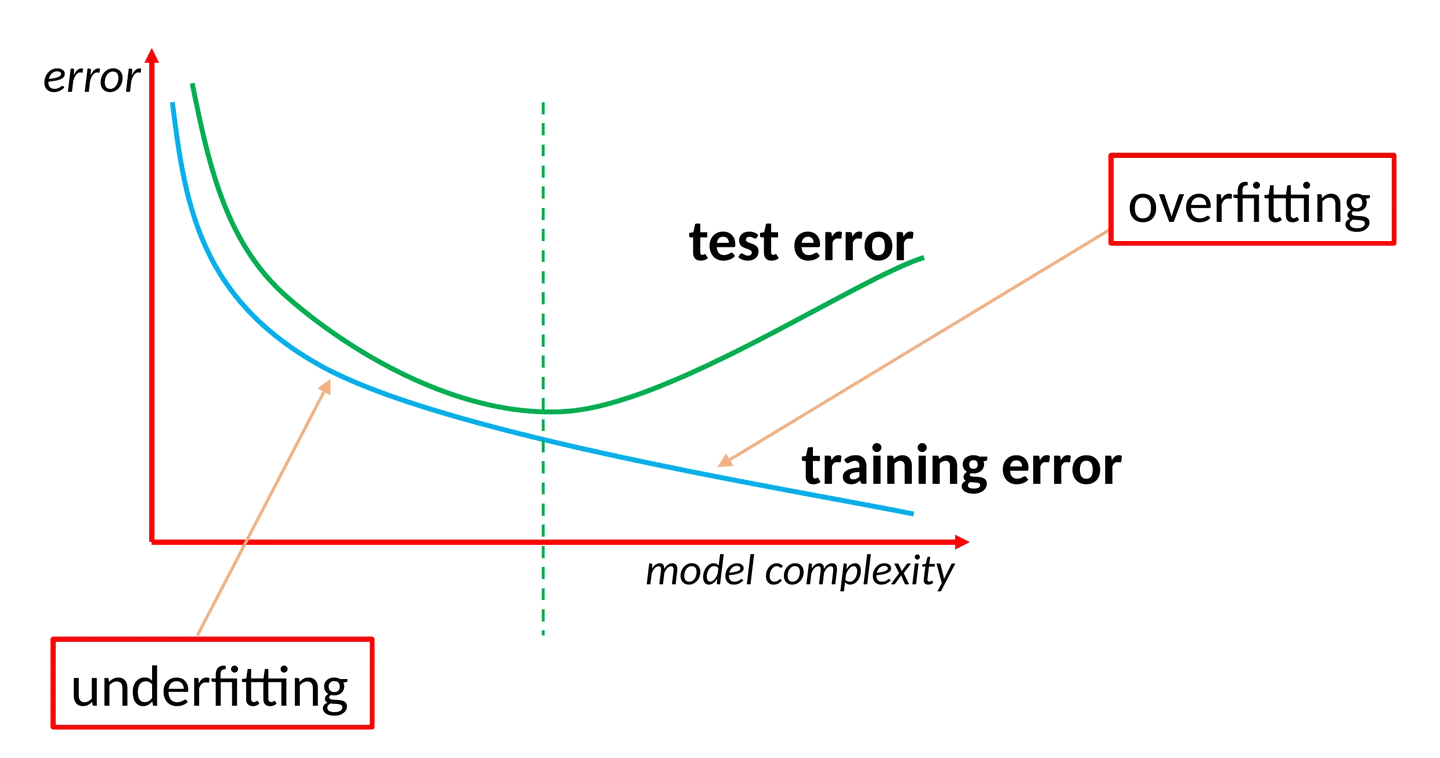
偏差和方差是给这条曲线左右两半起的名字(p.34)。想象用不同的训练集把同一个模型训练很多次,每次得到一个预测:预测的平均值离真值多远叫偏差,预测彼此散得多开叫方差(p.32)。课件的图里几十条直线几乎重叠,几十条高阶多项式四处乱飞(p.33)。
诊断只需要两个数。训练误差都大,是大偏差;训练误差小、测试误差大,是大方差(p.34)。修法分两组(p.35–36):大偏差靠加特征或换更复杂的模型,仅加数据通常不能弥补表达力不足;大方差靠正则化、更多数据,或者往简单里改模型。
常见误解
「数据不够就多收集,什么病都能治」→ 错。加数据只对方差有效。偏差是模型本身表达不了那个关系,再多数据也只是更自信地拟合出一条错的直线(p.35)。
6. 交叉验证(cross validation)
人话定义:要在几个复杂度不同的模型里挑一个,不能拿测试集挑;从训练集里再切一块出来当验证集,用它挑。
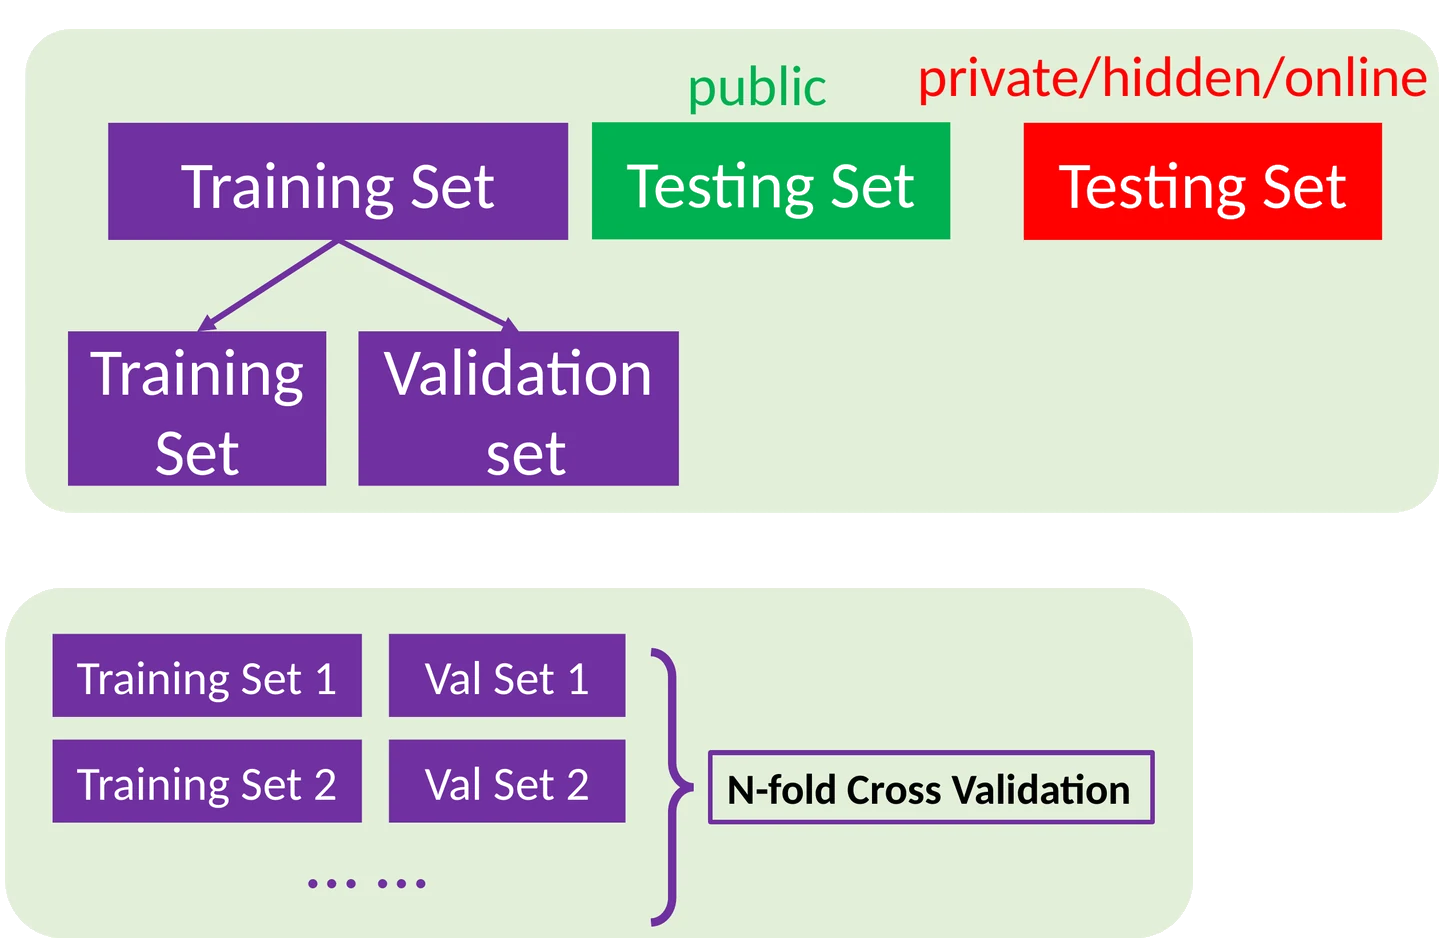
例子:课件画了三层切法(p.37)。第一层是训练集、公开测试集、隐藏测试集。第二层把训练集再切成训练集和验证集,比较多项式次数、调学习率这些决定只看验证集。第三层是 N 折:训练集切成 N 份,轮流拿一份当验证集、其余训练,N 个验证误差取平均再做决定。
常见误解
「测试集分数最高的那个模型就是最好的」→ 用测试集挑模型,等于把测试集变成训练过程的一部分,报出来的分数虚高。测试集只在最后报一次分(p.37)。
把它们串起来
主线就是课件 p.11 的四个阶段。Stage 1 定模型形状:y = wᵀx + b,参数个数 D + 1 在看到数据前就定死了。Stage 2 定参数:先用 MSE 说清什么叫「好」,再给两条路,一维有闭式解一次算完,通用办法是梯度下降,朝梯度反方向一步步挪。Stage 3 评估:用验证集比较和调整模型,最终测试集只评估不调参,最顺手的改法是加 x² 这类高次特征,加完仍是线性模型。
加特征加得太狠会翻到另一侧,训练误差一路降、测试误差反弹,课件用偏差和方差给两侧命名并各开药方。「加到几次为止」只能由验证集或 N 折交叉验证回答,测试集只负责报最终成绩。第三节的梯度下降是后续神经网络训练的基础方法,第四、五节的评估框架每一讲都会再用。
课件里的坑
- [课件有误] p.23 不等式链写成
L(w⁰,b⁰) > L(w¹,b¹) > L(w²,b¹),第三项的 b 下标按上下文应改为L(w²,b²)。 - [口径差异] p.19 等高线图上的「最佳点 (w = 3, b = −185)」是图源的示意值,只用左表列出的 4 行做最小二乘得到的是 w ≈ 2.33、b ≈ −209,别拿表里的数去验证图上的坐标。
- [课件有误] p.20 把 MSE 展开写成
K₁w² + K₂wb + K₃b² + K₄,省略了 w、b 的一次项;自己推导多出一次项是正常的。 - [课件有误] p.9 标题 “Convid-19 Dataset” 拼写有误,且那个 Kaggle 数据集是 2018 年的小儿肺炎 X 光片,与新冠无关。
- [补充] p.21 的判停条件「损失小于 ε」在真实数据上很难触发,demo 的误差平方和量级是 10¹²、阈值 10⁻⁴,实际靠 2000 轮上限结束。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条——模型写成 y = wᵀx + b 与 MSE 的形式、一维闭式解、梯度下降四步;再把下面的「变式题」做一遍;最后回查两个最容易错的地方——以为加了 x² 项就变成非线性模型、拿测试集分数挑模型。三步做完再往下看答案。
必背
- 本讲单输出线性回归是参数模型、输出一个标量;参数个数 = 特征维度 D + 1,由模型形态定,与训练样本数无关。
- 模型写成 y = wᵀx + b;在特征前补一列常数 1 可以把偏置 b 吸进 w,之后公式里只剩 w。
- 损失用均方误差 MSE:L(w,b) = (1/N) Σ (ȳⁿ − (wxⁿ + b))²;最小化平方和与最小化 MSE 解相同,换成 MAE 解一般不同。
- 一维闭式解 w = Σ(xⁿ−x̄)(ȳⁿ−ȳ) / Σ(xⁿ−x̄)²,b = ȳ − w·x̄,要能手算。
- 梯度下降四步:随机初始化 → 算损失判停 → 求梯度 → w ← w − η·∂L/∂w;更新方向永远与梯度相反,步长随梯度变小,必须设最大迭代次数。
- 加 x²、x³ 等高次项后仍是线性模型,因为对参数 w 线性;多项式基展开用来抓非线性关系,嵌套模型充分优化时,次数增加使训练误差不增。
- 嵌套模型充分优化时训练误差不增、测试误差常呈先降后升但不保证;训练集都拟合不了是大偏差(欠拟合),训练好测试差是大方差(过拟合)。
- 大偏差靠加特征或换更复杂的模型,仅加数据通常不能解决模型表达力不足;大方差靠正则化、更多数据或简化模型;选模型只能用验证集或 N 折交叉验证,测试集不参与任何选择。
完整例题
题面:训练点 (1,2)、(2,4)、(3,5)。求最小二乘解 w、b 和 MSE;再从 (w,b) = (0,0) 出发、η = 0.1,做一步梯度下降。
步骤:x̄ = 2,ȳ = 11/3。分子 Σ(xᵢ−x̄)(yᵢ−ȳ) = (−1)(−5/3) + 0 + (1)(4/3) = 3,分母为 2,故 w = 3/2,b = 2/3。预测为 13/6、11/3、31/6,误差为 −1/6、1/3、−1/6;平方和 1/6,MSE = 1/18 ≈ 0.05556。
梯度下降一步:在 (0,0) 处预测全为 0,L = (4 + 16 + 25)/3 = 15。∂L/∂w = −(2/3)Σxᵢyᵢ = −50/3,∂L/∂b = −(2/3)Σyᵢ = −22/3。这里用各样本的 yᵢ,不是均值 ȳ。
更新后 w = 5/3 ≈ 1.66667,b = 11/15 ≈ 0.73333。用未四舍五入的参数回算,L = 158/675 ≈ 0.23407。
答案:最小二乘解为 w = 3/2、b = 2/3,MSE = 1/18;一步梯度下降后为 (5/3, 11/15),损失从 15 降至约 0.23407,尚未达到最优值。
变式题(先自己做)
换一组点:(1,2)、(2,3)、(3,7)。求最小二乘解 w、b 和 MSE;再从 (w,b) = (0,0) 出发、η = 0.1 做一步梯度下降,并比较这一步之后的损失和最优 MSE 差多少。
提示
闭式解的分子分母都用离均差,b 靠均值回代。梯度那一步注意两件事:前面的负号,以及 2/n 里的 n 这里是 3。
参考答案与自检(非官方评分标准)
自检要点:① w 的分子分母都必须用离均差,b 由 ȳ − w·x̄ 回代;② 梯度的负号和 2/3 系数缺一不可;③ 最后要说出「一步 ≠ 收敛」——把 GD 一步后的损失和最优 MSE 摆在一起比。
- x̄ = 2,ȳ = 4。分子 Σ(x−x̄)(y−ȳ) = (−1)(−2) + 0 + (1)(3) = 5,分母 Σ(x−x̄)² = 2,故 w = 2.5,b = 4 − 2.5 × 2 = −1。
- 预测 1.5、4、6.5,误差 0.5、−1、0.5,平方和 1.5,MSE = 0.5。注意这组点不共线,最优解的 MSE 也不为 0。
- 梯度下降起点 (0,0):预测全为 0,误差就是 y 本身 2、3、7,L = (4 + 9 + 49)/3 ≈ 20.67。
∂L/∂w = −(2/3) Σ x(y − ŷ) = −(2/3)(1×2 + 2×3 + 3×7) = −(2/3)(29) ≈ −19.33;∂L/∂b = −(2/3)(2 + 3 + 7) = −8。- 更新:w = 29/15 ≈ 1.93333,b = 0.8;保留分数到最后,避免中途舍入。
- 用精确参数回算,L = 782/675 ≈ 1.15852,比最优 MSE = 0.5 高 889/1350 ≈ 0.65852。一步更新使损失下降,但不等于已经收敛。
闪卡自测
1. 10 个特征的线性回归有几个参数?训练集从 1000 条涨到 100 万条,参数变吗?
11 个(10 个权重 + 1 个偏置);不变,参数个数只看特征维度(p.13)。
2. 补一列常数 1 之后,模型公式变成什么?b 去哪了?
y = wᵀx,b 变成了常数 1 那一列对应的权重 w₅(p.14)。
3. 「最小化平方和」与「最小化 MSE」得到的 (w,b) 相同吗?换成 MAE 呢?
相同,两者只差常数因子 1/N;MAE 是另一个函数,最优解一般不同,且零点不可导(p.17)。
4. loss、cost、objective 三个词各指什么?
loss 指单个训练样本的误差,cost 是全部样本的平均,objective 是任何要优化的目标的泛称(p.17)。
5. 梯度下降的更新量 −η·∂L/∂w 恒为负吗?
否。η 恒正,但导数有正有负,谷底右侧 w 减小、左侧 w 增大;不变的只有「方向与梯度相反」(p.21)。
6. 学习率太大会怎样?线性回归的梯度下降会掉进局部极小吗?
太大会跨过谷底跳到更高处甚至发散;线性回归 + MSE 的损失是二次函数、只有一个最低点,不会有局部极小问题(p.20, p.23)。
7. `y = w₁x + w₂x² + w₃x³ + b` 是线性模型吗?
是,对参数 w 线性;x²、x³ 只是新特征,对输入 x 非线性(p.27)。
8. 多项式次数从 1 升到 9,训练误差和测试误差各怎么变?
嵌套模型充分优化时训练误差不增;测试误差常示意为先降后升,并非必呈 U 形(p.30)。
9. 训练误差 0.5、测试误差 0.52,是偏差大还是方差大?该加数据还是加特征?
偏差大(欠拟合);加特征或换更复杂的模型,仅加数据通常不能解决模型表达力不足(p.34–35)。
10. 训练误差 0.01、测试误差 0.9,三种修法?
正则化、更多训练数据、简化模型(p.36)。
11. 为什么不能用测试集选多项式次数?5 折交叉验证怎么做?
用测试集选模型等于把它并入训练过程,分数虚高;把训练集切 5 份,轮流拿 1 份当验证集、其余 4 份训练,5 个验证误差取平均再选(p.37)。
12. demo 里把面积标准化后,偏置项恰好等于房价均值,为什么?
标准化后 x̄ = 0,闭式解 b = ȳ − w·x̄ 里第二项为零,所以 b = ȳ(p.18, p.40)。
下一讲
下一讲 Logistic Regression 把这一讲的 wᵀx + b 套上一层 sigmoid 去做分类,损失从 MSE 换成交叉熵,训练还是梯度下降;这一讲第三节没吃透,下一讲的推导会跟不上。
下一讲的通俗笔记上完课会补,先回 COMP5541 课程页。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。